 最新模型
MiniMax、低コストなエージェントタスクと100万トークンのコンテキストを掲げるM3.1 Flashを発表
MiniMaxは10月19日、M3.1 Flashをリリースした。疎推論を調整して速度を高め、エージェントタスクの利用コストを抑える。モデルはAPI経由で利用できるが、重みはまだ公開されておらず、公式の性能データも独立した検証を待つ。
Archive
推論 runtime、量化、 serving、KV cache、成本與效能。
最新模型
MiniMaxは10月19日、M3.1 Flashをリリースした。疎推論を調整して速度を高め、エージェントタスクの利用コストを抑える。モデルはAPI経由で利用できるが、重みはまだ公開されておらず、公式の性能データも独立した検証を待つ。
 最新模型
Inceptionは10月19日、コンテキストを100万トークンに拡張したMercury 3を発表し、毎秒1,068トークンの出力速度をうたった。アプリ開発企業による導入も始まっているが、公式の速度・品質比較は独立評価を待つ必要がある。
 GitHub Repo
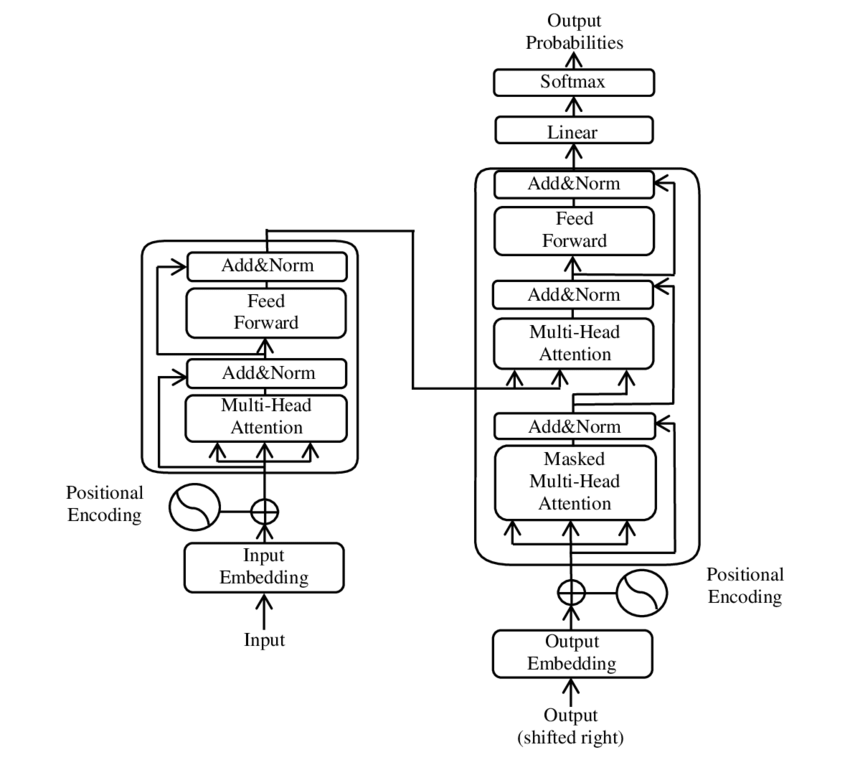
10月19日のTransformersコミュニティからの報告によると、リセット済みキャッシュをQwen4-Expで再利用すると、残存する位置情報によってスパースアテンションの選択が変わる可能性があります。報告には再現コードとローカルでの修正案が含まれますが、メンテナーによる確認はなく、事前学習済みモデルでの評価も完了していません。
 GitHub Repo
Ollamaは10月18日、PPLX Decider v1.2のMLX実行をサポートする0.40.7候補版を公開しました。更新には非因果的注意機構、決定読み出し、画像処理が含まれますが、ローカルでの性能と量子化後の確率は検証が必要です。
 GitHub Repo
SGLang は 10 月 19 日に 0.5.22 をリリースしました。分離デプロイ構成の decode ノードで、prefill の完了後にリクエスト用の KV 領域を割り当てられるようになりました。公式の特定ワークロードでのテストではスループットが向上した一方、トークン間レイテンシのテールは悪化しており、この機能は引き続きオプションです。
 GitHub Repo
10月19日のHermes Agentへの報告によると、スマート承認が未保存のプレゼンテーションを閉じるAppleScriptコマンドを自動承認し、ユーザーデータが失われる可能性がある。別の貢献者が承認上の不備を再現し、コミュニティは手動確認を必須にする修正ブランチを提案したが、正式な修正版はまだ公開されていない。
 GitHub Repo
vLLMは10月18日に0.32.0をリリースし、選択肢ごとの確率を返す構造化意思決定エンドポイントを追加した。Python 3.10のサポート終了やストリーミングイベント名の変更も含まれるため、既存環境では互換性の検証が必要だ。
 GitHub Repo
10月18日のOpen WebUIコミュニティ報告によると、FastMCPツールがリストを返す際、同じデータがテキストと構造化コンテンツの両方でモデルのコンテキストに重複して渡される可能性がある。同日、修正PRが提案されたが、まだマージされていない。実際のトークン数とコストへの影響は、ワークロードごとに測定する必要がある。
 GitHub Repo
REAは10月18日、Kuna静的解析バックエンドと再利用可能なJavaScriptクエリ結果を含む6.7.0をリリースした。新バージョンでエージェント向けリバースエンジニアリング機能が拡張されたが、Kunaは別途インストールが必要で、プラットフォーム対応や解析の完全性には制約がある。
 最新模型
IFMは10月15日、0.9B〜375BパラメーターのJais 3モデル6種を公開した。アラビア語の推論とツール操作に重点を置く。訓練段階ごとのチェックポイントと評価資産も公開されたが、性能データの独立した再現は今後の課題だ。
 GitHub Repo
Ollamaは10月16日、Windowsのコマンドラインサービスが強制終了された後も推論子プロセスが実行され続ける可能性がある問題を修正した0.40.6をリリースした。新バージョンではOSにプロセスのライフサイクル管理を委ね、llama-serverとMLX runnerを対象としている。
 最新模型
NVIDIAは10月16日、共有層を繰り返し実行することで、同じ4Bの重みを異なる推論計算予算に対応させるDory 1.0を公開した。最後のループのKVキャッシュを使うオプションがあるが、性能は公式テスト段階で、主要な推論フレームワークへの対応も統合待ちだ。