AI 研究
40時間というエージェント能力の推定値、自律的な研究を保証するにはまだ足りない理由
METRの新評価は、検証が難しい研究タスクを加え、長時間タスクのスコアの裏にある判断力の差を明らかにした。人間の作業時間の多くは推定値であり、それも数値の意味を制限している。
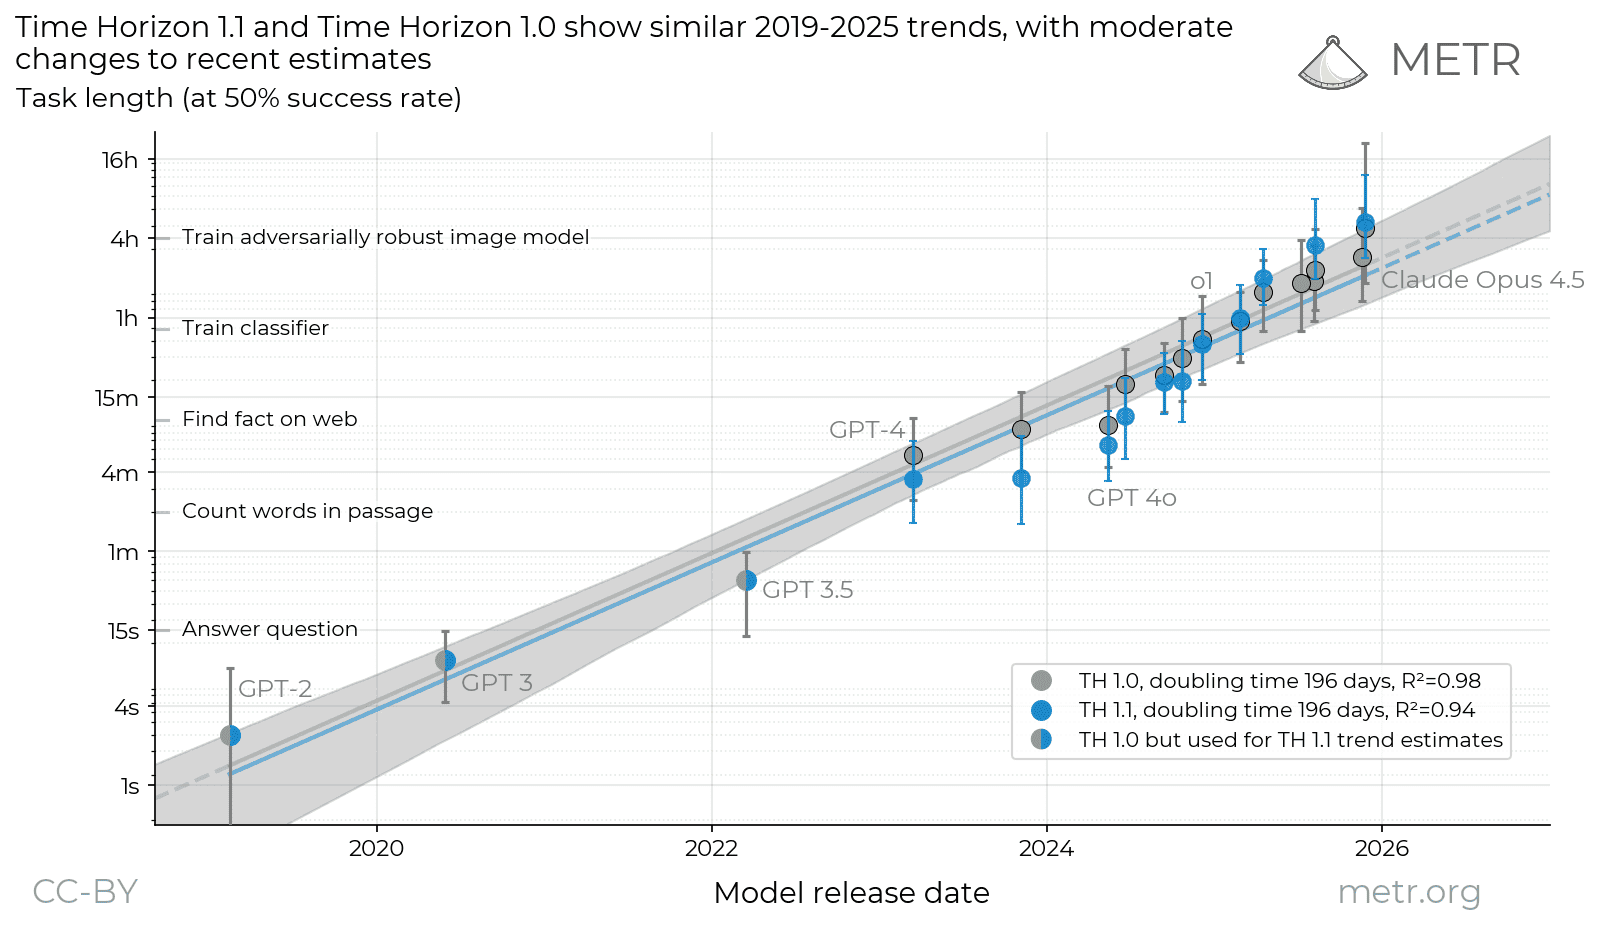
AIエージェントに長期の研究開発業務を任せようとしている人にとって、参考になる一方で誤解もしやすい指標が新たに加わった。METRが11月20日に公開した評価では、GPT-6 Astraの「タスク時間軸の50%点」を40時間、Opus 5.5を39時間と推定した。一方、同じ研究に検証が難しいタスクを加えたところ、特定の判断タスクではエージェントに依然として弱点があることも分かった。METRの評価原文
40時間は難易度の目安であり、納品の約束ではない
「時間軸」は、人間の専門家がタスクに要する作業時間で難易度を表し、エージェントのテスト結果から成功率を当てはめたものだ。50%時間軸とは、曲線が成功率50%と予測する地点を指す。エージェントが連続して自律稼働できる時間でも、同じ長さのタスクならどれも成功率が50%になるという意味でもない。METRの方法論の説明
この違いは、業務の割り振りに直結する。たとえば1週間分の研究を任せるとしても、40時間という指標からは、エージェントが適切な問いを選べるか、途中で得られた新しい証拠に対処できるか、成果に価値があるかを見極められるかは分からない。METRの従来のタスクは主にソフトウェアエンジニアリング、機械学習、サイバーセキュリティを対象とし、文脈が十分に与えられ、成功条件が明確な作業として意図的に設計されている。実際の職務には、プロジェクトの背景や人との協働、そして自動採点が難しい品質要件も関わる。指標の適用範囲
成果物を作れても、品質を正しく判断できるとは限らない
新評価のタスクの一つでは、METRにとって有用な能力テストをエージェントに設計させた。METRによると、エージェントが作成した問題のうち、今回の報告に採用できるほど有用なものは一つもなかった。別のテストでは、哲学的な議論に対する批評の質をモデルに評価させた。評価対象となった公開モデルと専門家の採点の一致度は、15分かけて評価した人間の専門家の推定水準を依然として下回った。判断力テストの結果
これらの結果は、テストされた状況に限られる。METRは、テスト設定がモデルの能力を十分に引き出せていない可能性もあると注意を促している。したがって、これは特定の弱点を示す証拠ではあるが、あらゆる研究をエージェントに任せられないと結論づけたり、AIによって研究開発が加速しないと断言したりする根拠にはならない。
人間の作業時間にも不確実性がある
新しい評価セットのうち、作業時間とスコアを校正した34件のタスクでは、人間が実際に成功させた実装を基準にできたのは3件だけだった。残る31件は研究者による推定を使っている。GPT-6 Astraの40時間という点推定の95%信頼区間は13~2,645時間だ。これは実測した作業時間の範囲ではなく、統計的な推定の不確実性を表している。校正方法と付録B
実務上は、成果を納品する前に、誰が検証できるのか、誤りが見つかるまでどのくらいかかるのか、研究の方向性に誰が責任を持つのかを確認するとよい。40時間を、そのまま安心して任せられる1週間分の仕事に換算するよりも、この指標の用途に即した考え方だ。