AI 研究
代理的四十小時能力估計,為何還不能當成自主研究保證
METR 新評估加入難驗證的研究工作,揭示長任務分數背後的判斷力落差;人類工時多靠估算,也限制了數字能代表什麼。
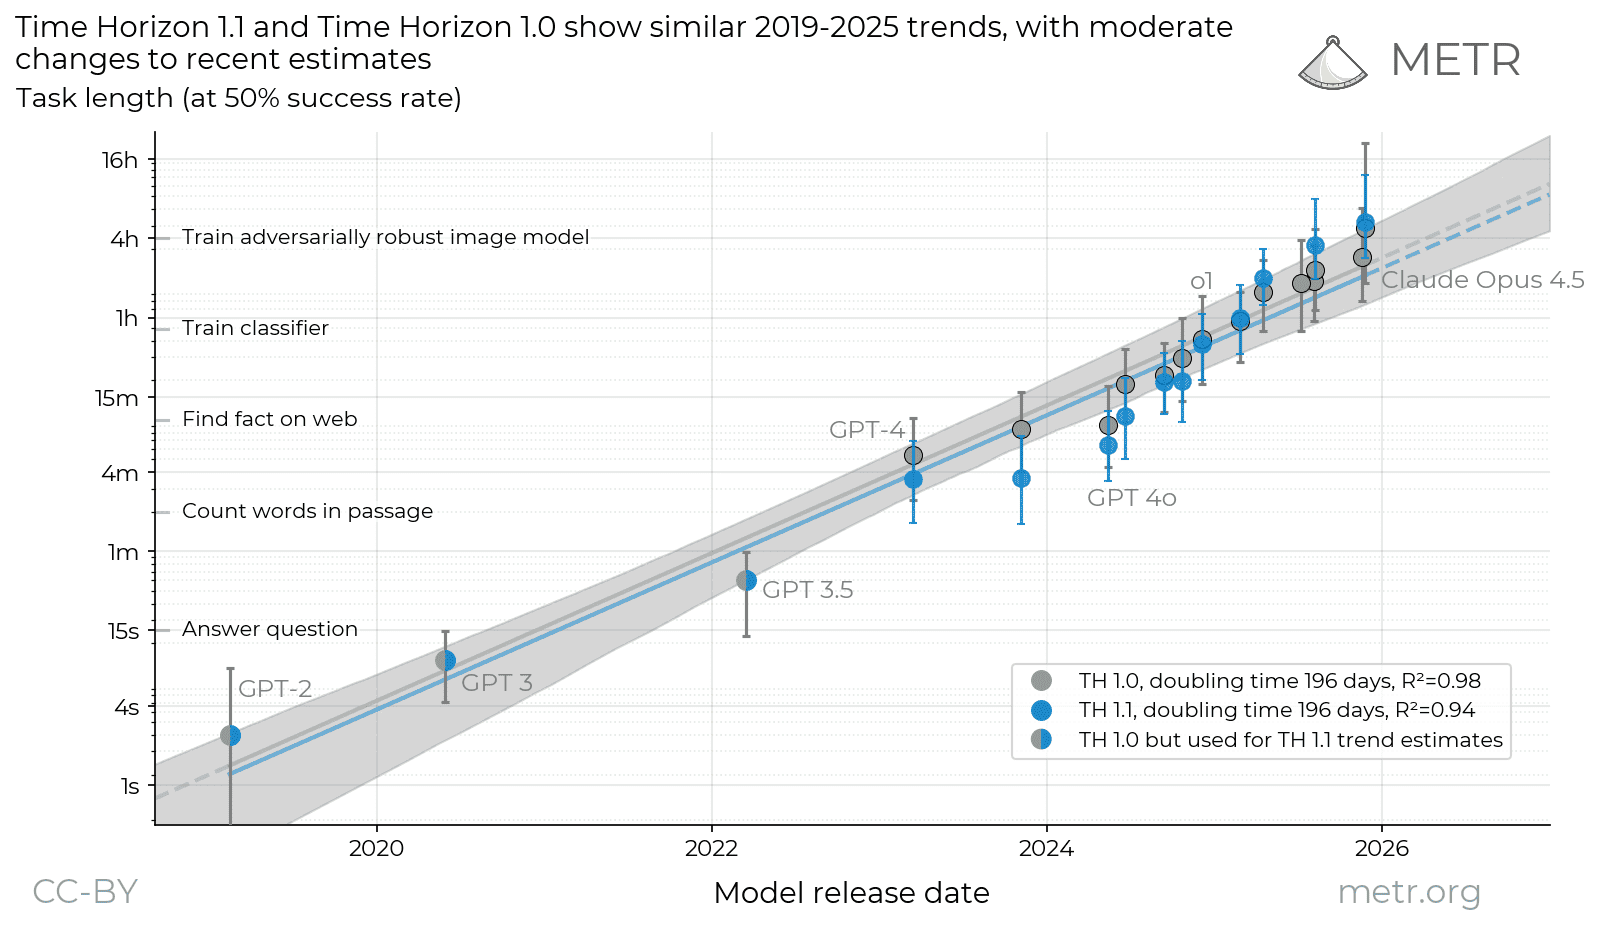
準備把長段研發工作交給 AI 代理的使用者,多了一項值得參考、也容易誤讀的指標。METR 在 11 月 20 日發布的評估中,估計 GPT-6 Astra 的「50% 任務時間跨度」為 40 小時,Opus 5.5 為 39 小時。但同份研究加入難驗證工作後,也發現代理在特定判斷任務上仍有弱點。METR 評估原文
四十小時是難度刻度,不是交付承諾
「時間跨度」以人類專家需要的工時標示任務難度,再由代理的測試結果擬合成功率。50% 時間跨度,就是曲線預測成功率為一半的位置;它不是代理連續自主運作的時間,也不代表每項同長度任務都有一半成功機率。METR 方法說明
這個區別會直接影響工作安排。假設要交付一週研究,四十小時指標並沒有回答代理能否選對問題、處理中途出現的新證據,或辨認成果是否有價值。METR 的既有任務主要涵蓋軟體工程、機器學習與資安,而且刻意設計成脈絡完整、成功條件明確的工作;真實職務還依賴專案背景、人際協作,以及難以自動評分的品質要求。指標適用範圍
能完成產出,仍可能判不準品質
新評估的一項任務要求代理設計對 METR 有用的能力測試。METR 表示,代理產出的題目沒有任何一項有用到足以納入此次報告。另一項測試要求模型評定哲學論證批評的品質,受測公開模型與專家評分的一致程度,仍低於投入十五分鐘的人類專家之估計水準。判斷力測試結果
這些結果限於受測情境。METR 也提醒,測試設定可能尚未充分引出模型能力。因此,它們提供的是特定弱點的證據,不能據此判定所有研究都無法交給代理,或斷言 AI 研發不會加速。
人類工時本身也有不確定性
新套件有工時與分數校準的三十四項任務中,只有三項採用成功的人類實作基準,其餘三十一項使用研究者估算。GPT-6 Astra 的四十小時點估計,95% 信賴區間為十三至二千六百四十五小時;這不是實測完成時數的範圍,而是統計估計的不確定性。校準方法與附錄 B
對使用者的實務推論是:交付前,先確認誰能驗證成果、錯誤多久才會浮現,以及誰負責研究方向。這比直接把四十小時換算成可放心交付的一週工作,更符合這項指標的用途。