 代理工具
SciDataSailor、エージェントによる科学データベースの直接探索を実現、9BモデルのPass@1が14.01から28.99に向上
SciDataSailorはモンテカルロ木探索を用いて、実行可能なファイル探索軌跡を合成し、2,300件を超える教師ありデータを公開した。Qwen3.5-9Bはファインチューニング後、ステップ数を制限したテストで試行錯誤を削減したが、一部の評価は依然としてLLM-as-a-Judgeに依存している。
Archive
新模型、開放權重、多模態、語音、影像與模型架構。
代理工具
SciDataSailorはモンテカルロ木探索を用いて、実行可能なファイル探索軌跡を合成し、2,300件を超える教師ありデータを公開した。Qwen3.5-9Bはファインチューニング後、ステップ数を制限したテストで試行錯誤を削減したが、一部の評価は依然としてLLM-as-a-Judgeに依存している。
 代理工具
49の実在するリポジトリから抽出した106件のタスクを用い、拒否、開示、検証、人間への引き継ぎに関する規則を評価した。4つの最先端モデルはいずれも、デフォルトではポリシーを自発的に探すことがほとんどなかった。規則の明示や検証器の導入により開示とテストは改善したものの、エージェントはすべての評価条件で「AIによるコントリビューション禁止」という要件に従わなかった。
 AI 安全
MAI-Cyber-1-Flashは137BパラメータのスパースMoEだが、各tokenでアクティブになるのは約5Bに限られる。MDASHの処理の約9割を担い、難しいケースをGPT-5.4に引き渡す。Microsoftは新構成でコストがほぼ半減したとしているが、現時点ではAzure AI Foundryのプライベートプレビューでのみ提供され、ベンチマークも外部では再現されていない。
 AI 安全
InfoOps Benchは、ロシア、中国、イランの国営・国家支援メディアから継続的にナラティブを収集し、モデルがプロパガンダ内容の書き換えを拒否するか、ファクトチェックするか、あるいは支援するかを検証する。17モデルの完全性スコアは8.8%から94.5%に分布し、モデル規模だけでは情報操作リスクを予測できないことが示された。
 推論系統
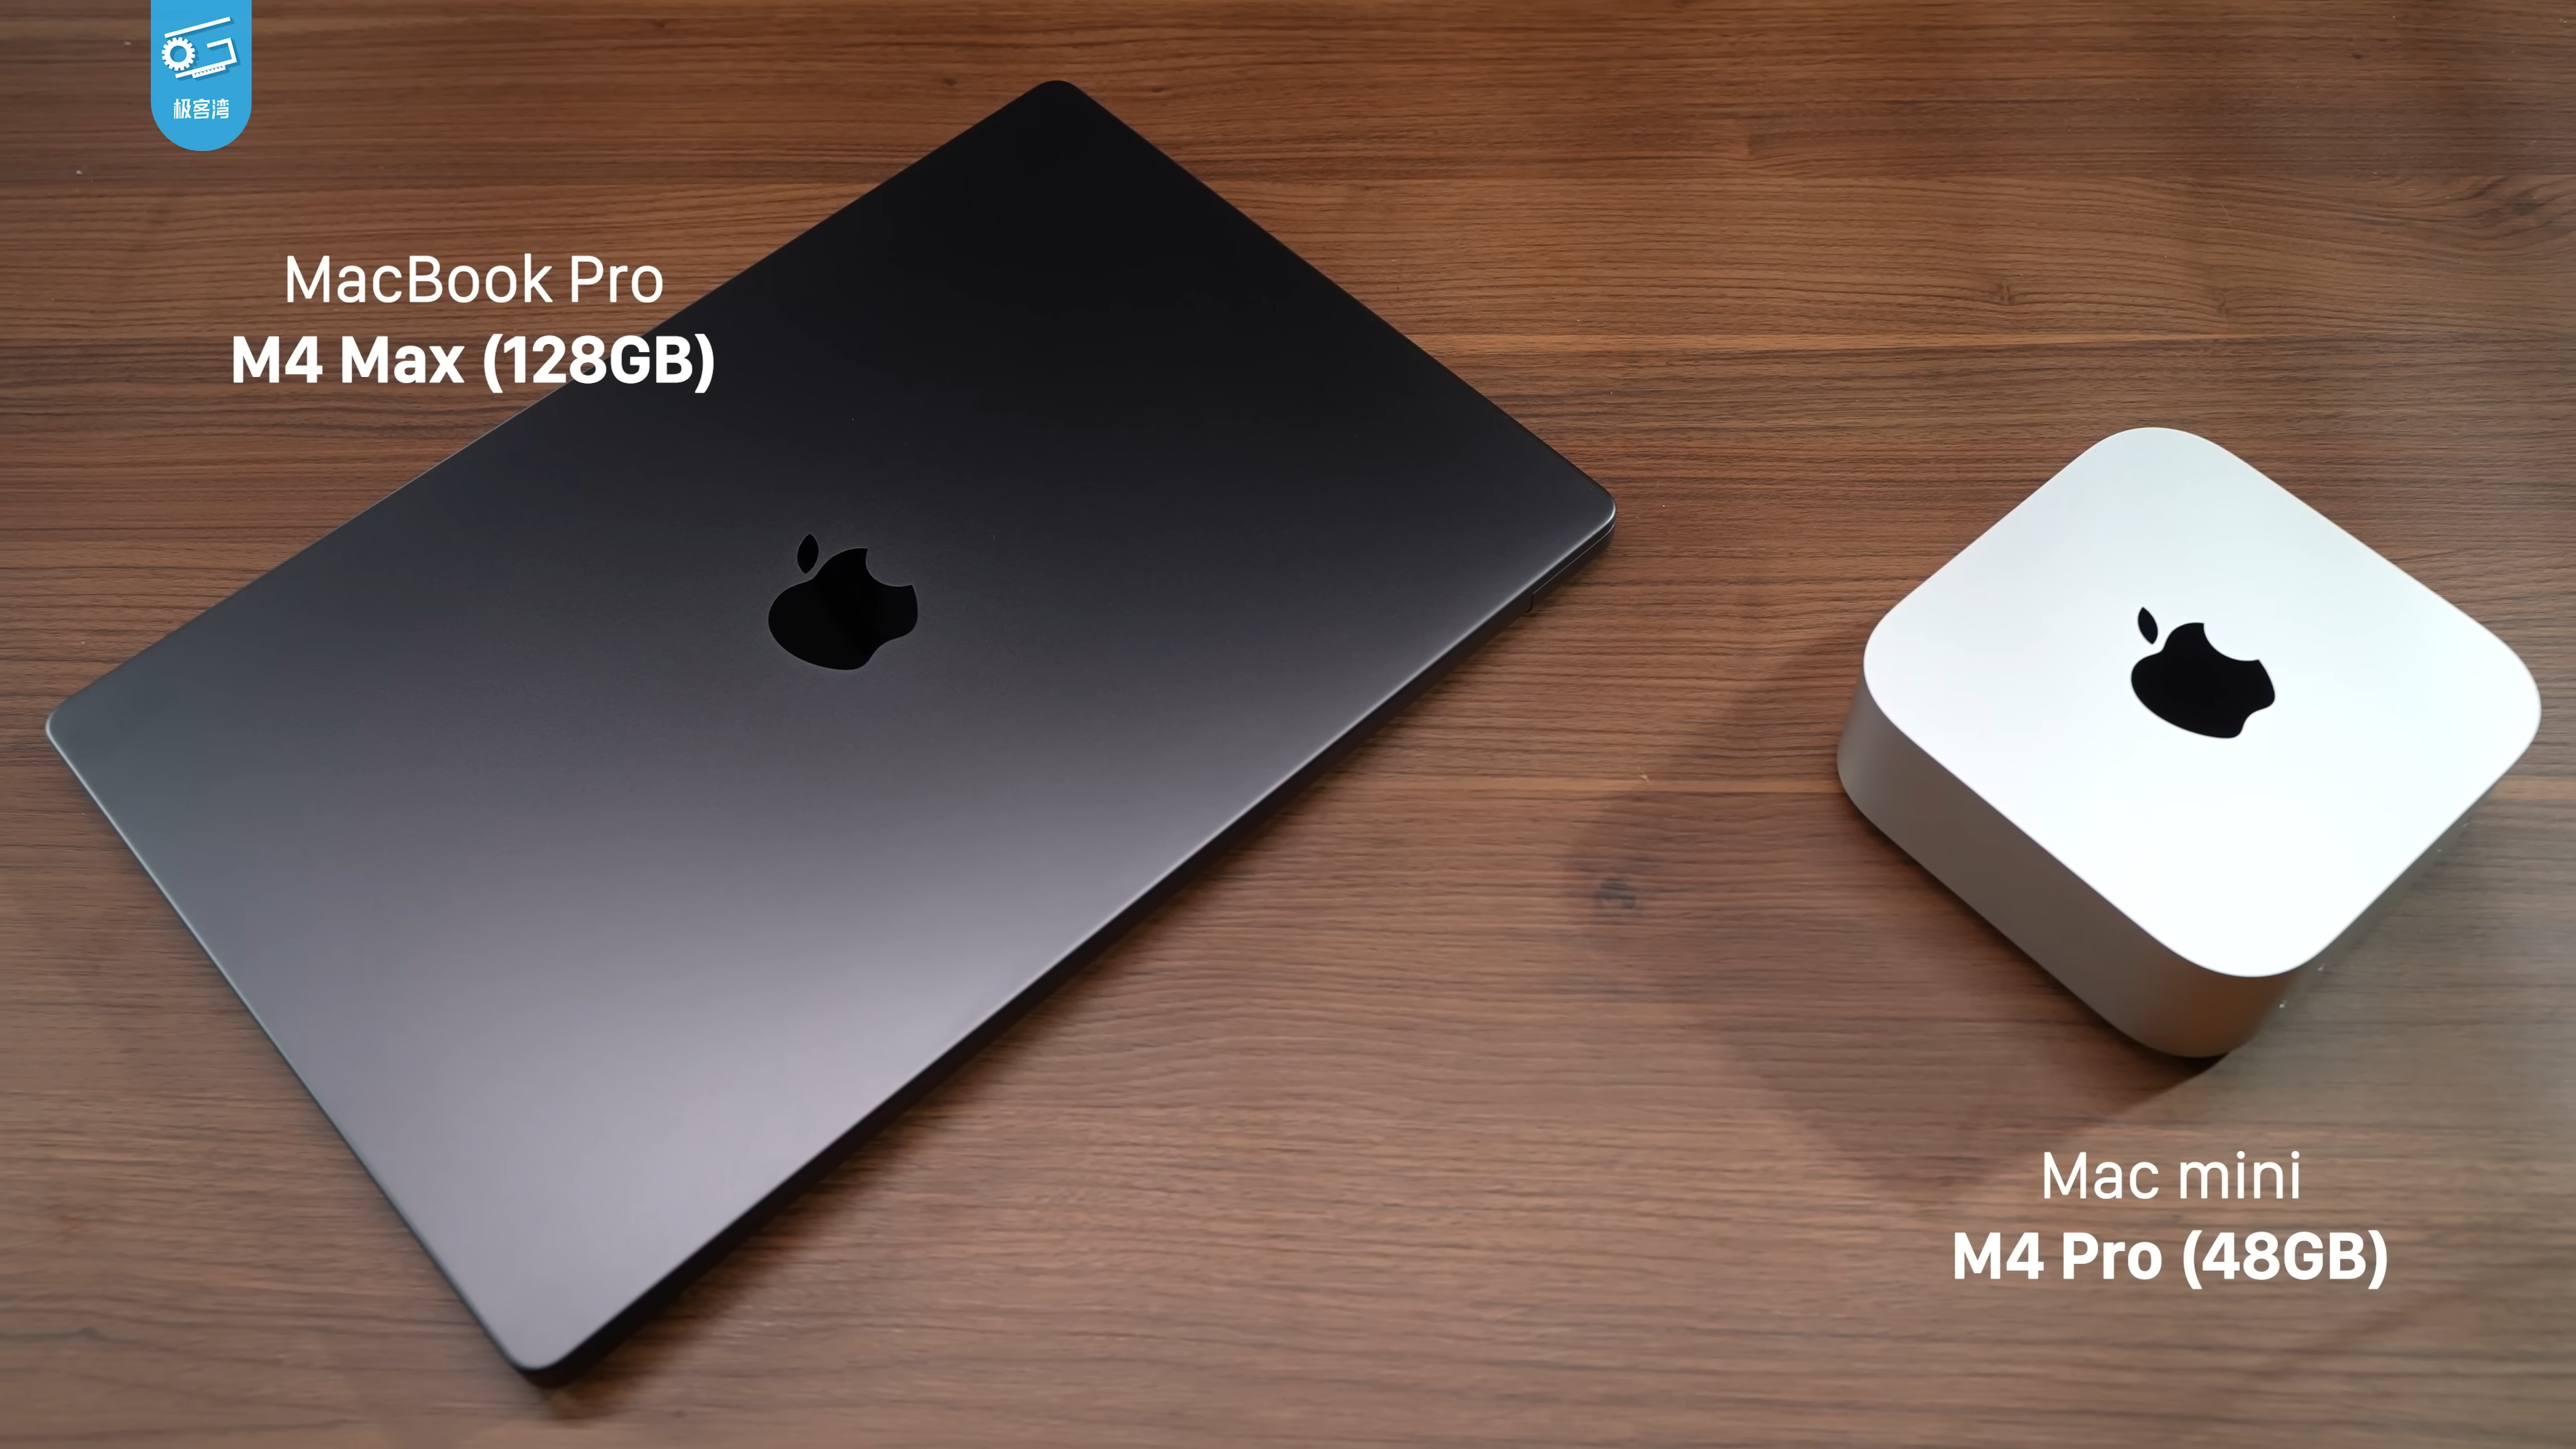
同価格帯のローカルAIプラットフォームを比較した最新テストでは、546GB/sのユニファイドメモリ帯域幅を備えるM4 Maxが、3種類の量子化モデルにおけるtoken単位のデコードでGB10とStrix Haloを上回った。一方、prompt prefillと総合的な電力効率ではGB10が依然優位であり、tokens/sだけを見ると実際の応答時間を見誤る可能性がある。
 最新模型
SVRは、回答、正誤判定、信頼度を同時に学習させ、推論時に現在の回答を採用するか、修正を続けるかをモデル自身が決定できるようにする。Qwen3.5-2Bは7つの数学ベンチマークで平均正解率56.3%を達成したが、停止シグナルは依然としてモデル自身のキャリブレーション・バイアスの影響を受ける可能性がある。
 開發者平台/API
GitHubは7月30日、Modelsのplayground、モデルカタログ、推論API、bring-your-own-key(BYOK)機能を終了した。既存の有料ユーザーも例外ではない。同サービスのエンドポイントに依存するアプリケーションは、Microsoft Foundry、別のモデルgateway、または自前のプロバイダー抽象化レイヤーへ移行する必要がある。
 AI 安全
ブラックボックス実験により、階調反転やグレースケール化など、勾配や代理モデルを必要としない低コストの変換だけで、3つの商用サービスが人間には依然として認識可能な有害画像を安全と誤判定することが明らかになった。マルチモーダルコンテンツと自傷行為のカテゴリは特に脆弱であり、基盤モデルを用いたモデレーションAPIを単独のセキュリティ境界として扱うべきではないことを示している。
 AI 安全
MINDは、メモリ項目ごとに大規模モデルを呼び出して審査するのではなく、元の意図とその後の行動の圧縮表現を比較し、複数超平面分類器でポイズニングされたコンテンツを遮断する。4モデルを用いた対照実験では攻撃成功率が低下し、平均レイテンシは防御なしのベースラインに近かったが、コードはまだ公開されていない。
 最新模型
AgenticASRは音声認識とテキスト整形を分離し、新しい音声が入力されるたびに小型のRefinerが既存出力の限られた範囲を書き換えることで、文字起こし全体を繰り返し処理する必要をなくす。コード、チェックポイント、917問の日中バイリンガルベンチマークは公開済みだが、音声の大半は音声合成で生成され、採点もLLMジャッジに依存している。
 最新模型
新たな研究では、合計320億tokenに上る68万6,000冊の合成教材を生成し、内容を同一にした対照実験によって文書構造の効果を切り分けた。関連する章を完全な書籍として構成した場合、分割した段落やランダムな連結より優れたが、この成果は研究チーム独自の訓練パイプラインによるもので、データとコードはまだ公開されていない。
 推論系統
SemPICは独立したWriterモデルを用い、入力位置に依存しない文書KVをオフライン生成する一方、Readerでは元のモデルと標準キャッシュインターフェースを維持する。3モデル・4タスクの平均micro-F1は既存手法の0.53から0.60へ向上したが、エンドツーエンドのレイテンシ、キャッシュ容量、コードはまだ公開されていない。