 AI 安全
DFOT、導出センサー値に対するLLMの過信を定量化——クロスモーダル蒸留で訂正率が最大6.69ポイント向上
新たなフレームワークは「モデルが導出値を誤って信頼する」問題を、矛盾受容、文脈による誤誘導、誤りの訂正、効用低下などの指標に分解する。PPGによる心調律判定を事例に、訓練時にECGを利用し、デプロイ時にはPPGのみを必要とする信頼度モデルが4つのエンドポイントを改善した。ただし、データと重みはコードとともに公開されていない。
Archive
推論 runtime、量化、 serving、KV cache、成本與效能。
AI 安全
新たなフレームワークは「モデルが導出値を誤って信頼する」問題を、矛盾受容、文脈による誤誘導、誤りの訂正、効用低下などの指標に分解する。PPGによる心調律判定を事例に、訓練時にECGを利用し、デプロイ時にはPPGのみを必要とする信頼度モデルが4つのエンドポイントを改善した。ただし、データと重みはコードとともに公開されていない。
 最新模型
DualG-MRAGは、マクログラフで文書横断推論の経路を探索し、ミクログラフで局所的な画像・テキスト証拠を照合することで、細粒度ノードによる知識グラフの急速な肥大化を防ぐ。MMQAでは、R@5をグラフベースの最良ベースラインの42.1%から61.9%へ向上させたが、コードとインデックス構築コストはまだ公開されていない。
 AI 安全
MAI-Cyber-1-Flashは137BパラメータのスパースMoEだが、各tokenでアクティブになるのは約5Bに限られる。MDASHの処理の約9割を担い、難しいケースをGPT-5.4に引き渡す。Microsoftは新構成でコストがほぼ半減したとしているが、現時点ではAzure AI Foundryのプライベートプレビューでのみ提供され、ベンチマークも外部では再現されていない。
 代理工具
MANTAはタスクに応じてエージェント通信グラフを構築し、実行トレースから協調上の異常を検出して、役割、接続、検証順序を限定的に書き換える。Gemma 4 31Bを用いたテストでは、5つのベンチマークにおける平均スコアが74.0に達したが、実験のサンプル数と反復回数は依然として少ない。
 推論系統
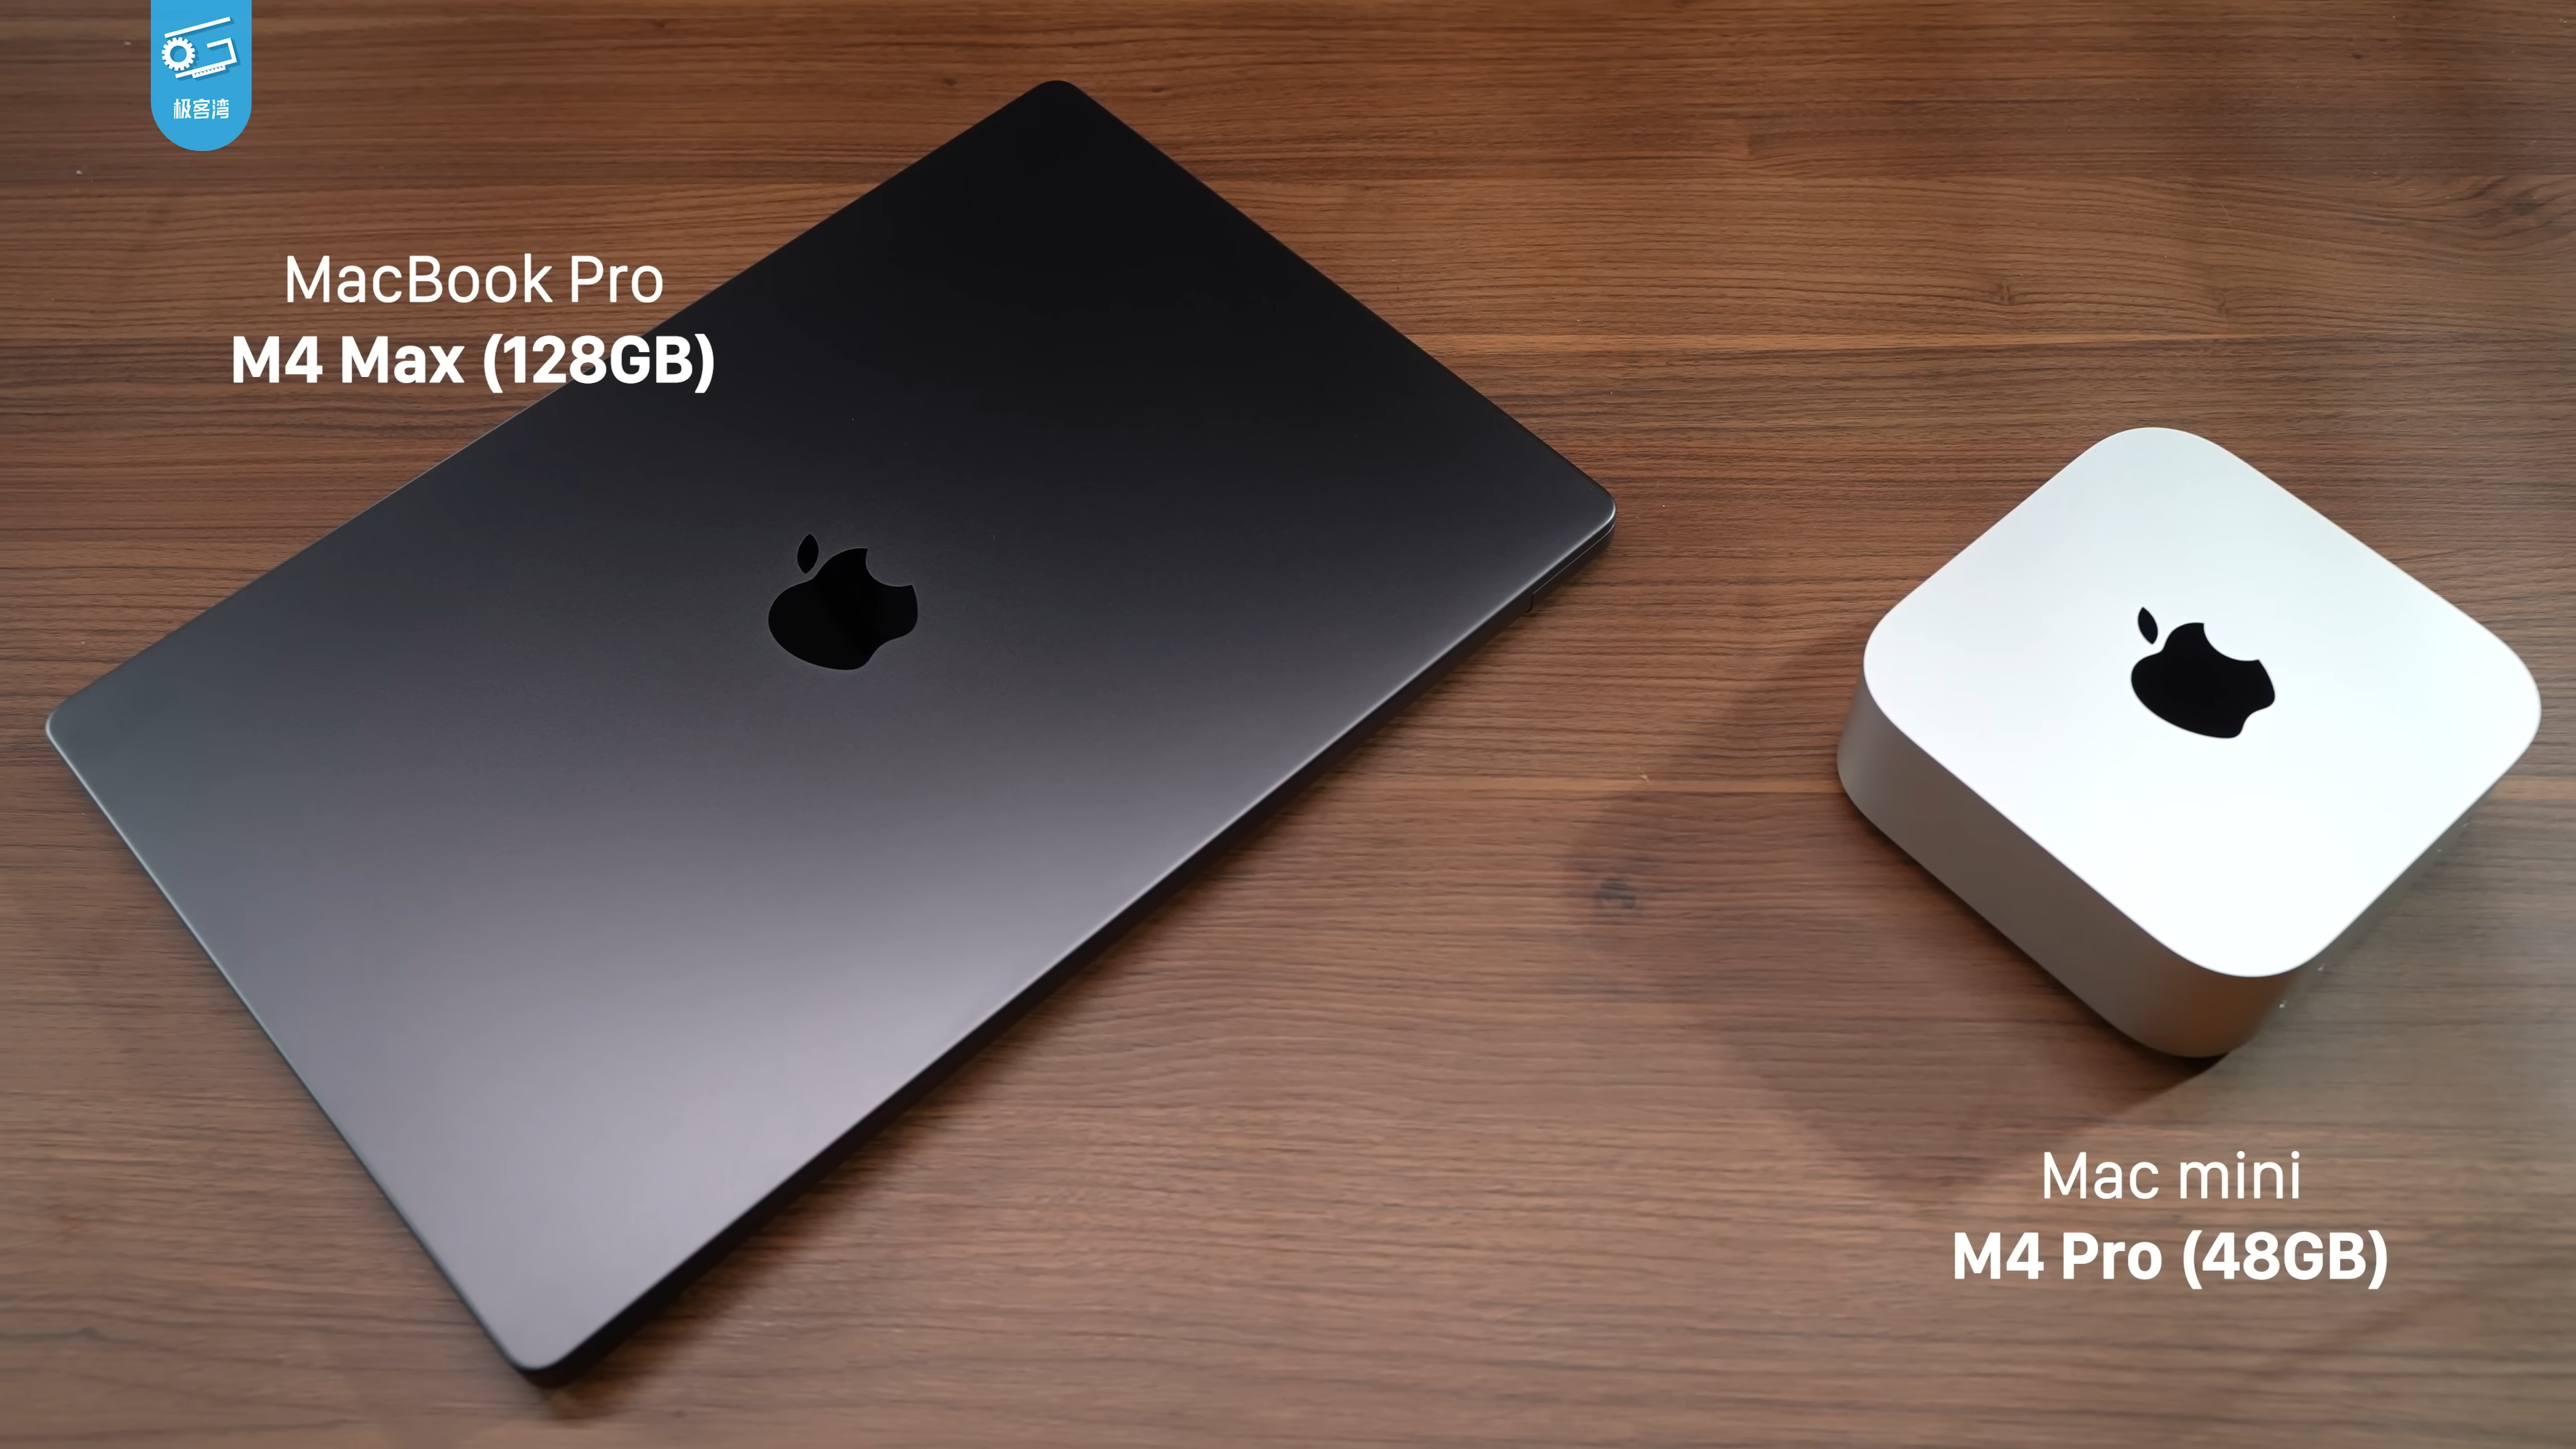
同価格帯のローカルAIプラットフォームを比較した最新テストでは、546GB/sのユニファイドメモリ帯域幅を備えるM4 Maxが、3種類の量子化モデルにおけるtoken単位のデコードでGB10とStrix Haloを上回った。一方、prompt prefillと総合的な電力効率ではGB10が依然優位であり、tokens/sだけを見ると実際の応答時間を見誤る可能性がある。
 最新模型
SVRは、回答、正誤判定、信頼度を同時に学習させ、推論時に現在の回答を採用するか、修正を続けるかをモデル自身が決定できるようにする。Qwen3.5-2Bは7つの数学ベンチマークで平均正解率56.3%を達成したが、停止シグナルは依然としてモデル自身のキャリブレーション・バイアスの影響を受ける可能性がある。
 開發者平台/API
GitHubは7月30日、Modelsのplayground、モデルカタログ、推論API、bring-your-own-key(BYOK)機能を終了した。既存の有料ユーザーも例外ではない。同サービスのエンドポイントに依存するアプリケーションは、Microsoft Foundry、別のモデルgateway、または自前のプロバイダー抽象化レイヤーへ移行する必要がある。
 最新模型
新たな研究では、合計320億tokenに上る68万6,000冊の合成教材を生成し、内容を同一にした対照実験によって文書構造の効果を切り分けた。関連する章を完全な書籍として構成した場合、分割した段落やランダムな連結より優れたが、この成果は研究チーム独自の訓練パイプラインによるもので、データとコードはまだ公開されていない。
 推論系統
SemPICは独立したWriterモデルを用い、入力位置に依存しない文書KVをオフライン生成する一方、Readerでは元のモデルと標準キャッシュインターフェースを維持する。3モデル・4タスクの平均micro-F1は既存手法の0.53から0.60へ向上したが、エンドツーエンドのレイテンシ、キャッシュ容量、コードはまだ公開されていない。
 推論系統
QuantWAMsは、将来の映像とロボットの行動を同時に生成するモデル向けに、量子化キャリブレーションを、構造、結合目的、閉ループ軌跡という3層の意思決定へと再設計した。2つのモデルのシミュレーション成功率はFP16との差が0.2~0.7パーセントポイントだったが、速度データは特定の演算モジュールのみが対象で、実機での比較も各タスク10回にとどまる。
 代理工具
OSWorldを用いた実験により、ローカルGUIエージェントに少量の画面履歴を追加すると反復操作を大幅に減らせる一方、コンテキストやステップ数をさらに増やしても、主に失敗パターンが変化するだけであることが示された。2段階の計画アーキテクチャも、フォーマット処理と連携のコストにより単一エージェントを下回り、計画を並列に多数生成しても、高額なtokenコストをかけて差の一部を埋めるにとどまった。
 最新模型
Moonshot AIは、42の既存ベンチマークにおける最初の失敗点から知覚能力の分類体系を構築し、3,000問の短答式問題によって10の基本的な視覚能力を切り分けた。その結果、総合スコアが近いモデルでも知覚上の弱点がまったく異なり得ることが示された。一方、テストセットはより大規模な社内問題プールから抽出されており、データ汚染と評価者バイアスには引き続き注意が必要だ。