 最新模型
Intern-S2-Mobius、FFNの記憶をモデル全体で共有し、35Bモデルで約4倍のエンドツーエンド推論高速化を報告
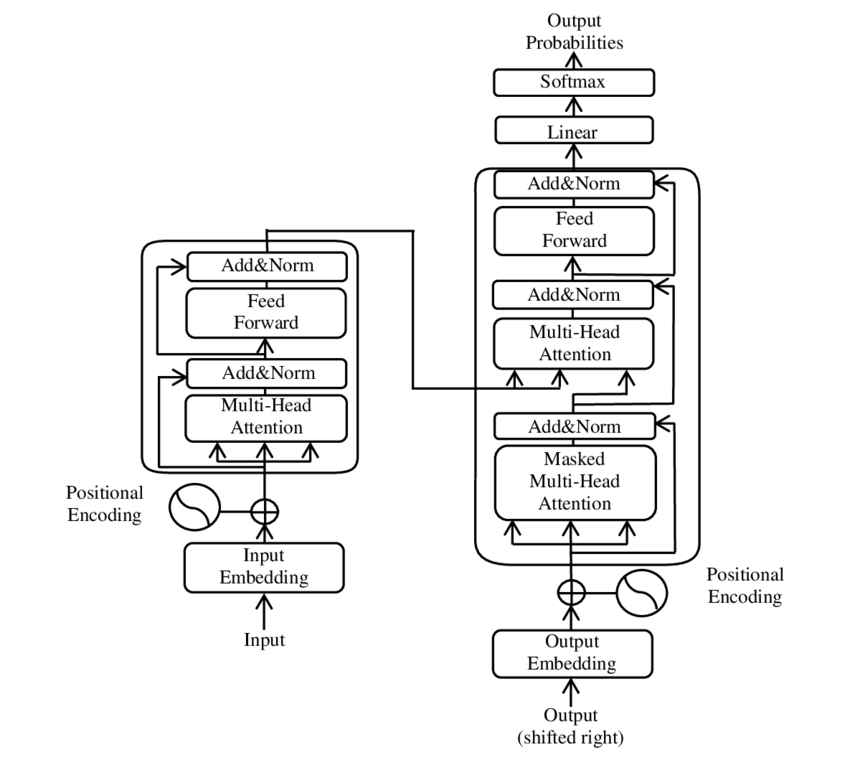
Intern-S2-Mobiusは、従来のTransformerで各層に結び付いていた知識ストレージと注意機構による推論を分離し、複数のReasonerが同一のグローバルMemoryを繰り返し参照できるようにする。オープンウェイトはLMDeploy、vLLM、Transformersで読み込めるが、約4倍という高速化は、あくまで公式の特定ベンチマークにおける結果だ。