 代理工具
Codex CLI 0.152、MCPの出力クォータをツール単位に細分化し、長時間セッションでの指示消失を修正
OpenAIはMCPツールごとの出力token上限を導入し、app-serverのshellコマンドを1時間以上実行できるようにした。新版では履歴圧縮後にユーザーの指示や承認が失われる問題も修正された一方、組み込みの計画ツールはデフォルトで無効化された。
Archive
推論 runtime、量化、 serving、KV cache、成本與效能。
代理工具
OpenAIはMCPツールごとの出力token上限を導入し、app-serverのshellコマンドを1時間以上実行できるようにした。新版では履歴圧縮後にユーザーの指示や承認が失われる問題も修正された一方、組み込みの計画ツールはデフォルトで無効化された。
 最新模型
Flower Labsは、推論、ソフトウェア開発、長時間のエージェントタスク向けにEndeavor 1.0を発表した。マネージドサービスとして利用できるほか、顧客環境へのデプロイにも対応する。初期スコアは一部のフロンティアモデルに迫るが、現時点では限定プレビューとベンダーによる自己評価しかなく、実際のデプロイコストや能力はまだ検証できない。
 代理工具
VS Code 1.132から1.135では、CopilotやClaudeなどのエージェントを独立したAgent Hostに接続することで、セッションを複数のウィンドウやリモート接続にまたがって継続でき、ヘッドレスでも実行可能になった。オープンなAgent Host Protocolはセッション状態を統一するが、各モデルの推論、権限、ツールの挙動までは統一しない。
 AI 安全
F5はDistributed Cloud WAFに異常検知とエージェント型脅威インテリジェンスを追加し、脆弱性スキャン結果をランタイムのブロック処理に連携させた。新機能は露出期間を短縮できる一方、検知率、誤検知率、レイテンシーについては、依然としてベンダーによるテストデータしか示されていない。
 AI 基礎設施
HUMAINはサウジアラビアで、AMD MI355X、EPYC、Cisco Silicon Oneネットワークを基盤とする本番環境向けGPUサービスの提供を開始した。これにより提携プロジェクトは「計画段階の容量」という域を越えたが、250 MWと1 GWは依然として、それぞれ2027年以降と2030年までの目標である。
 推論系統
NVIDIA Triton Inference Server 2.72.0では、リクエストが残っているにもかかわらずスケジューラが処理の割り当てを停止する可能性がある問題を修正し、`preserve_ordering`の完了順序セマンティクスを復元した。CUDA、TensorRT、gRPCの依存パッケージも更新された一方、TensorRT-LLMイメージは提供されず、vLLM/Rayデプロイには引き続きセキュリティ警告が付されている。
 最新模型
DeepSeekはAPI公開から10日後、初のV4マルチモーダルモデルの重み、プロンプトエンコーダー、最小構成のPyTorch推論実装をMITライセンスで公開した。モデルカードには汎用的なデプロイ手順が示されているものの、vLLMコミュニティによる検証では、316個の視覚テンソルに対応するモジュールがないため、依然として直接読み込めないことが確認されている。
 代理工具
公式MCP Inspectorの最新パッケージは、ブラウザ、コマンドライン、ターミナルの各インターフェースを単一の実行ファイルで提供し、プロトコルとOAuthの状態管理コアを共有する。新版のデプロイ文書では、Appsのサンドボックスと専用オリジンに追加のリスニングポートが必要であり、リモート公開時には組み込みtokenだけに依存できないことも明らかになった。
 推論系統
H3 Maxは、MiniMax H3のオープンウェイトにポストトレーニング用データを追加し、カスタム推論スタックによって動画生成のスループットを高めた。falは5秒の動画を3秒以内に生成できるとしているが、現時点ではホステッドAPI経由でしか提供されておらず、この速度を独自に再現できるデプロイ手順はまだ公開されていない。
 推論系統
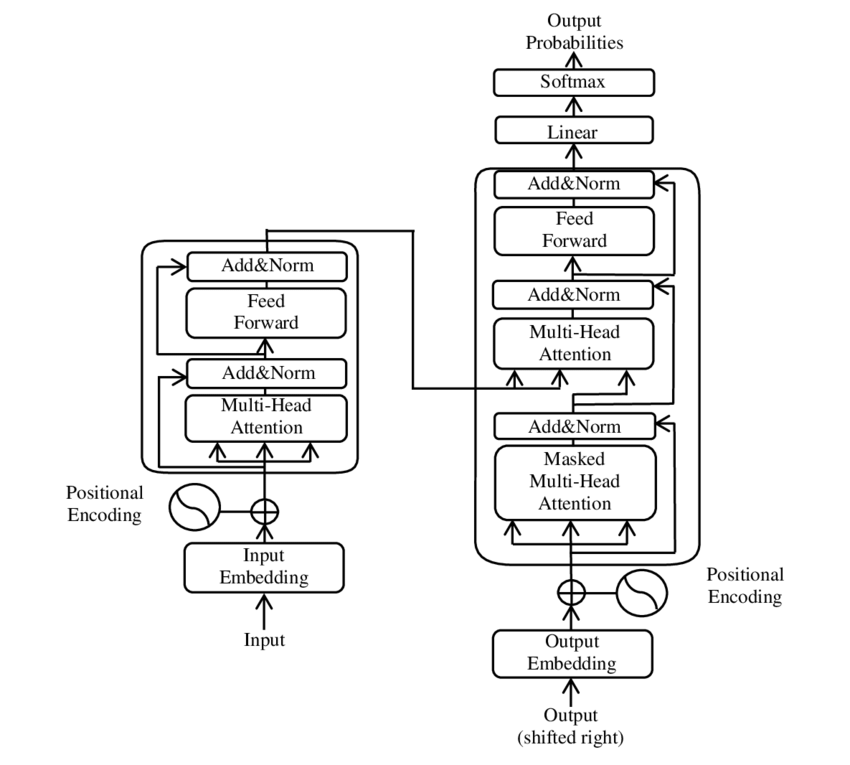
オープンソースプロジェクトのgemma4.cは、tokenizer、Transformer、KV cache、sampling、SIMD kernelを単一のCファイルに収め、外部の推論ライブラリを必要としない。作者によるRyzen 7 7700でのテストではllama.cppを上回ったが、この成果は固定モデル、単一のCPU backend、専用のデータレイアウトに依存しており、汎用的な性能評価とは見なせない。
 AI 安全
Cornell Techの研究者らは、もともと投機的デコーディング向けだったMTP/Eagle3モジュールを、主モデルを再実行せずに済む系列分類器へ転用した。この手法で訓練するパラメータは約1.6万~2万個にすぎないが、性能はドラフトヘッドの品質と数千件のタスク固有ラベルに左右される。
 推論系統
vLLM 0.28.0では、KVキャッシュを階層化してディスクへオフロードできるようになり、外部のセカンダリストレージマネージャーも利用可能になった。これにより、長いコンテキストを扱うサービスは、GPUおよびメインメモリの容量だけに制約されなくなる。新バージョンではKimi-K3、DeepSeek V4、投機的デコード、E/P/D分離も進展した一方、複数のデフォルト値と依存インターフェースが変更されている。