 推論系統
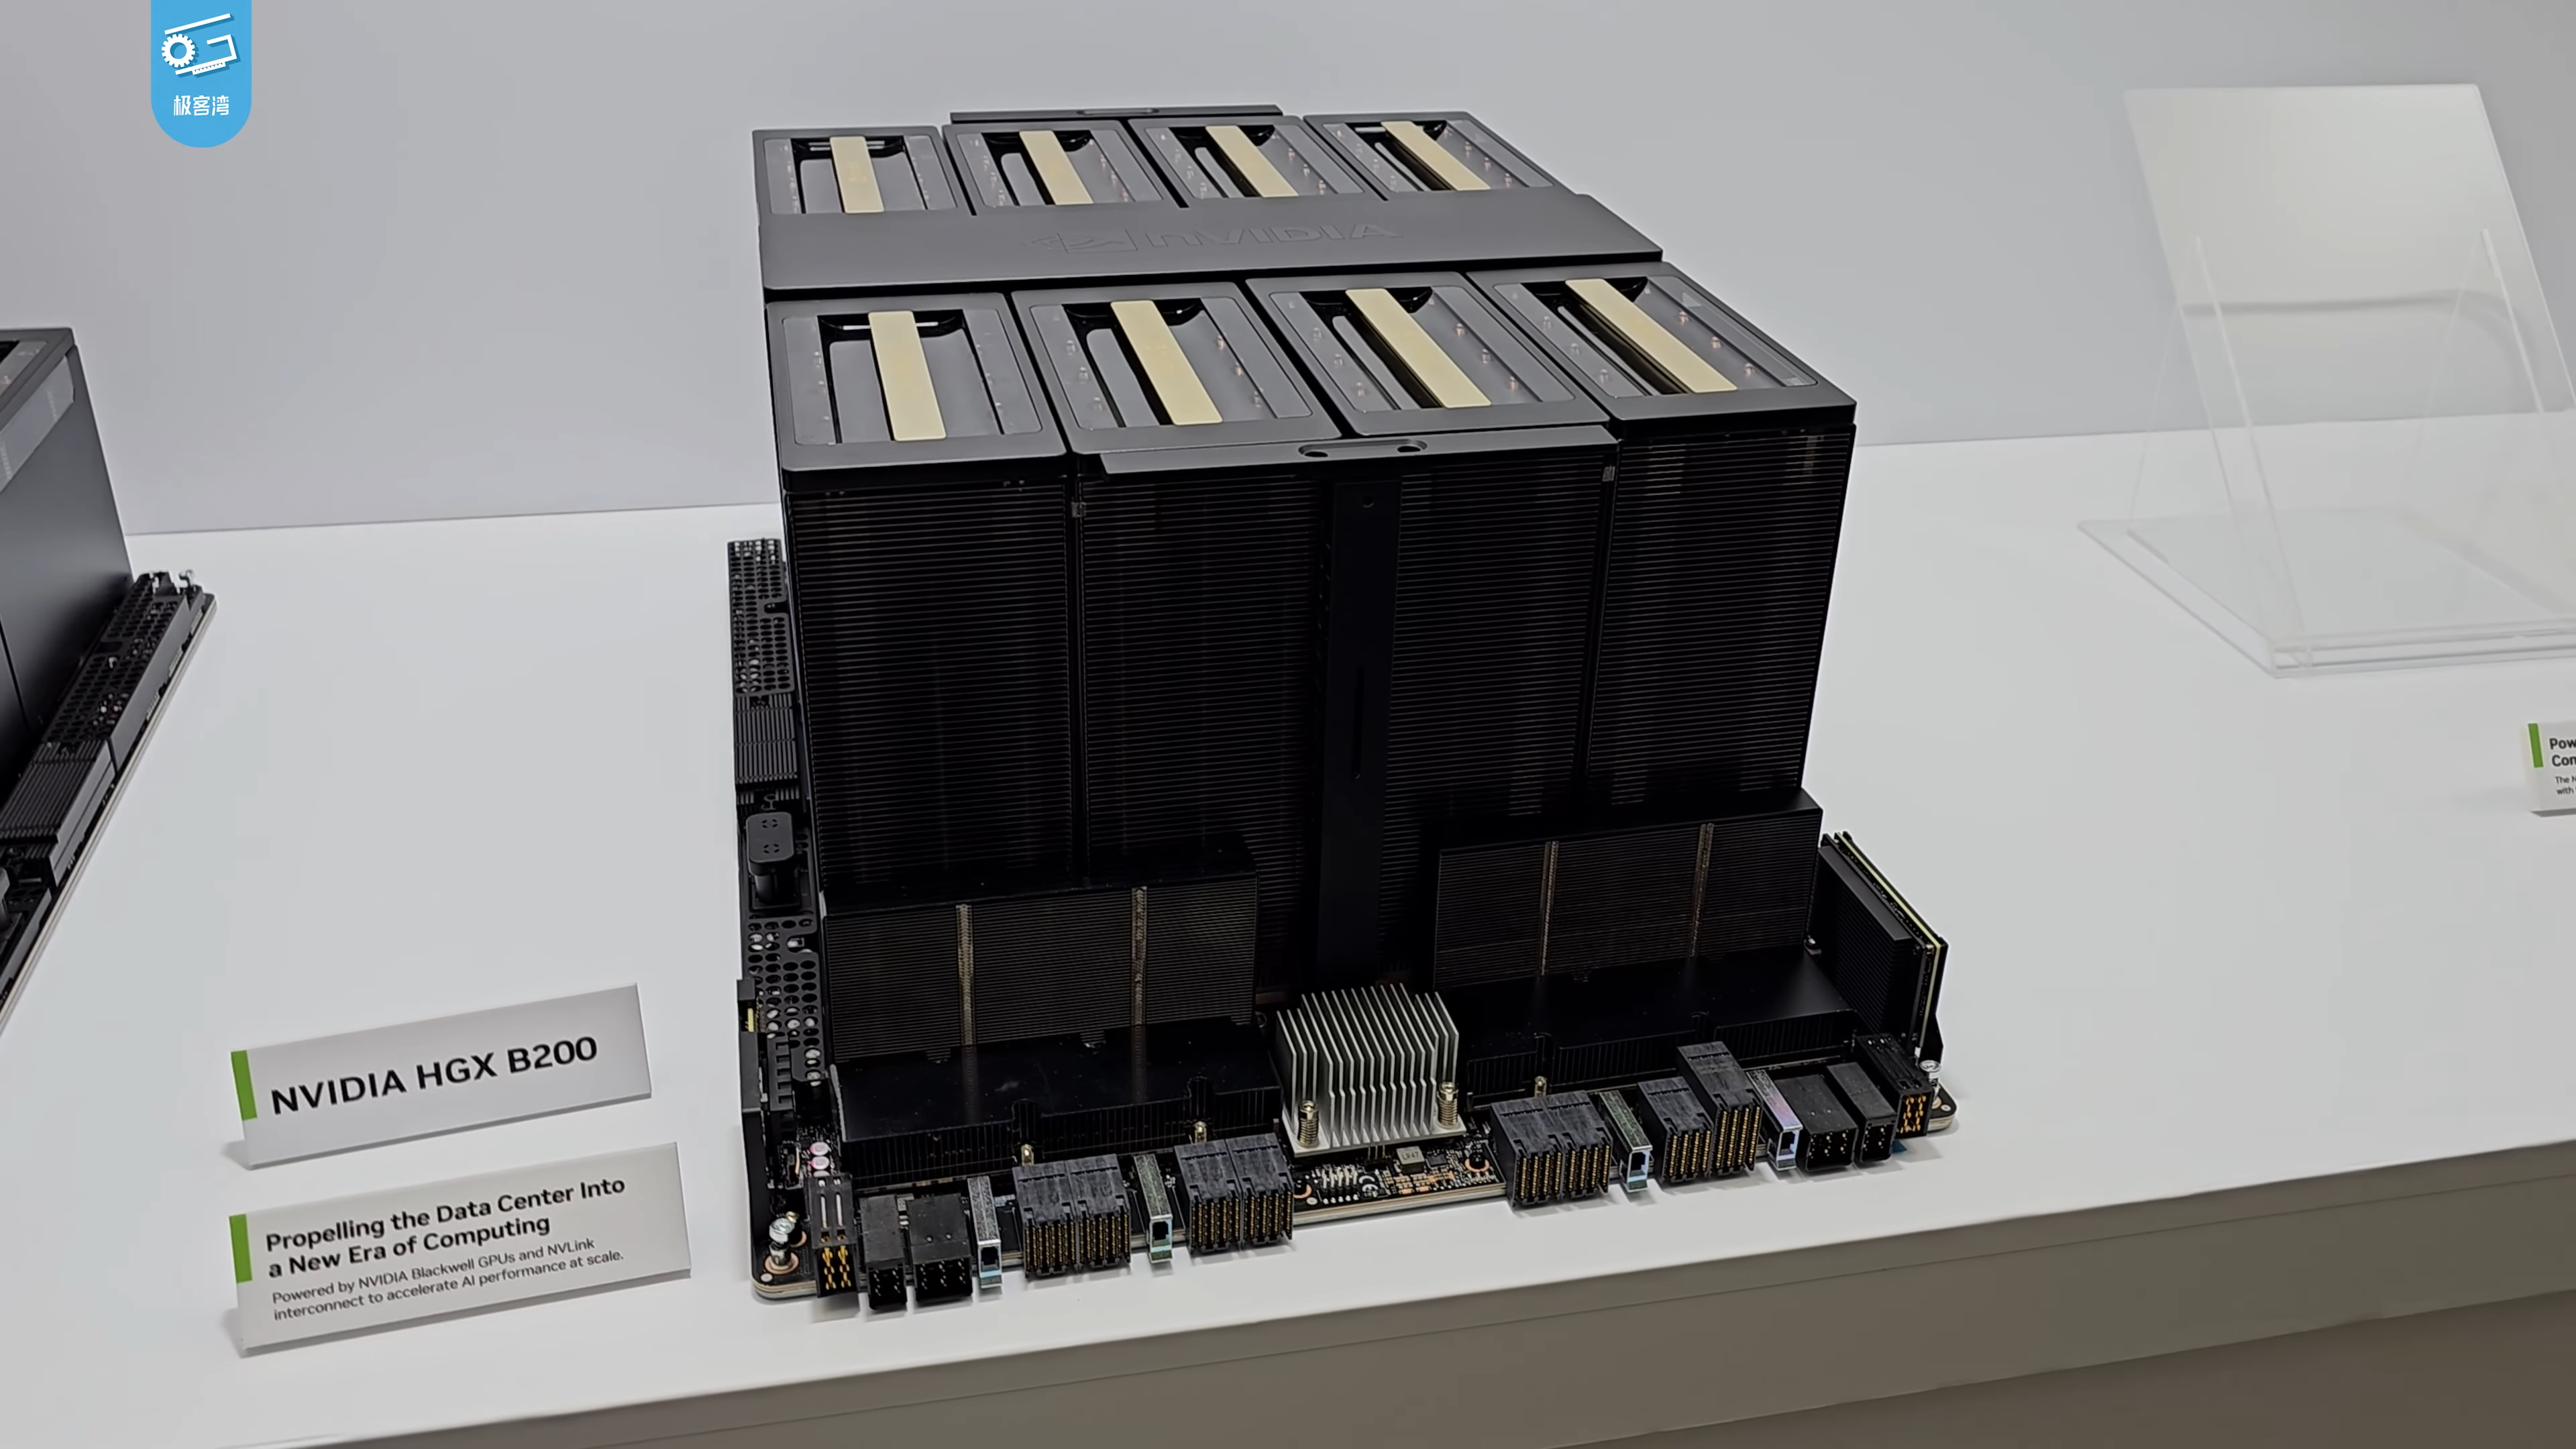
NVIDIA、B200のコンフィデンシャル推論テストを公表、特定のワークロードで96%超のスループットを維持
B200を8基使用してDeepSeek-R1を実行したテストでは、コンフィデンシャルコンピューティングによる1トークン当たりの平均レイテンシーの増加率は5%未満だった。この結果はメモリ転送、カーネルの時間計測、GPU間通信の調整に依存しており、実際のサービスのワークロードに即した再検証が必要だ。
Archive
AI 晶片、GPU、資料中心、邊緣裝置與硬體安全。
推論系統
B200を8基使用してDeepSeek-R1を実行したテストでは、コンフィデンシャルコンピューティングによる1トークン当たりの平均レイテンシーの増加率は5%未満だった。この結果はメモリ転送、カーネルの時間計測、GPU間通信の調整に依存しており、実際のサービスのワークロードに即した再検証が必要だ。
 推論系統
新たな記事では、MI350Xを8基使用した推論テストの手順を整理している。データは7月に収集されたものだ。指定コミットのREADMEと記事ではワークロードが異なり、エンジンごとの設定の違いも性能比較の制約となる。
 GitHub Repo
新たな経路では、ポータブルなモデル層をハードウェア固有の最適化から分離する。最初のコンポーネント群はすでにTransformersバックエンドに組み込まれた。H100での初期テストでは従来の経路に近いスループットを示したが、レイヤーの対応範囲やプラットフォーム間の性能は引き続き確認が必要だ。
 推論系統
Physical AI ToolchainがリモートGPUへの推論処理のデプロイに対応し、2種類のロボットアームのサンプルを提供。既存研究では、追加の遅延や画像伝送に必要な帯域幅が演算面の利点を相殺する可能性が示されており、導入には制御フロー全体の評価が必要となる。
 AI 研究
新ベンチマークはSGLangの53タスクでコーディングエージェントを評価し、他のチェックに合格した修正でも、モデルを正常にサービングできない場合があることを示した。結果は特定のテスト環境に限られ、ベンチマークに合格しても本番投入が可能になったことを意味しない。
 最新模型
DROIDとSO-101向けの重みとファインチューニング手順を提供。RoboLabの公開リーダーボードでは成功率約42.9%を記録した。制御ループは引き続きアプリケーション側で処理する必要があり、計画が対象とする時間幅を推論レイテンシとみなすことはできない。
 最新模型
Nemotron 3 Diarizationは1億パラメータでストリーミング音声と録音を処理し、話者キャッシュを引き継いで区間をまたぐラベルの一貫性を維持する。遅延の数値は音声のバッファリングのみを対象としており、実際の導入では認識、通信、後処理にかかる時間も測定する必要がある。
 GitHub Repo
既存のIntelドライバーで計算グラフをコンパイルし、SHAVEカーネルを置き換えることで、カスタムCプログラムをNPU上で実行する。新たなテストでは2種類の精度を持つ独立ブランチを検証したが、任意の混合精度パイプラインにはまだ対応していない。
 GitHub Repo
RTX 4070を使った再現例で、一部のテンソルサイズではtorch.compile後に誤った結果が生じることが示された。報告ではループの並べ替えと読み書きの依存関係が指摘されており、修正や他の環境への影響は引き続き確認が必要だ。
 AI 研究
同じ重みのまま計算を延長した研究で、当初は解けなかった問題の一部が後に解けることが確認された。結果は停止条件の研究に手がかりを与えるが、実サービスでの費用対効果はまだ実証されていない。
 AI 研究
演算ユニットの位置とメモリパーティションを推論構成に組み込み、特定の Qwen3-8B ワークロードでデコードスループットを改善。プロトタイプにはドライバの変更が必要で、コード公開と異なる環境での再現検証が待たれる。
 GitHub Repo
Fast StartはCUDA IPCを通じて処理済みの重みを再利用し、エンジン再起動時のディスクからの読み込みを削減する。ゼロコピーモードはsleep modeと互換性がなく、導入時には並列構成やキャッシュ利用失敗時のフォールバック動作も検証する必要がある。