推論系統
NVIDIA、B200のコンフィデンシャル推論テストを公表、特定のワークロードで96%超のスループットを維持
B200を8基使用してDeepSeek-R1を実行したテストでは、コンフィデンシャルコンピューティングによる1トークン当たりの平均レイテンシーの増加率は5%未満だった。この結果はメモリ転送、カーネルの時間計測、GPU間通信の調整に依存しており、実際のサービスのワークロードに即した再検証が必要だ。
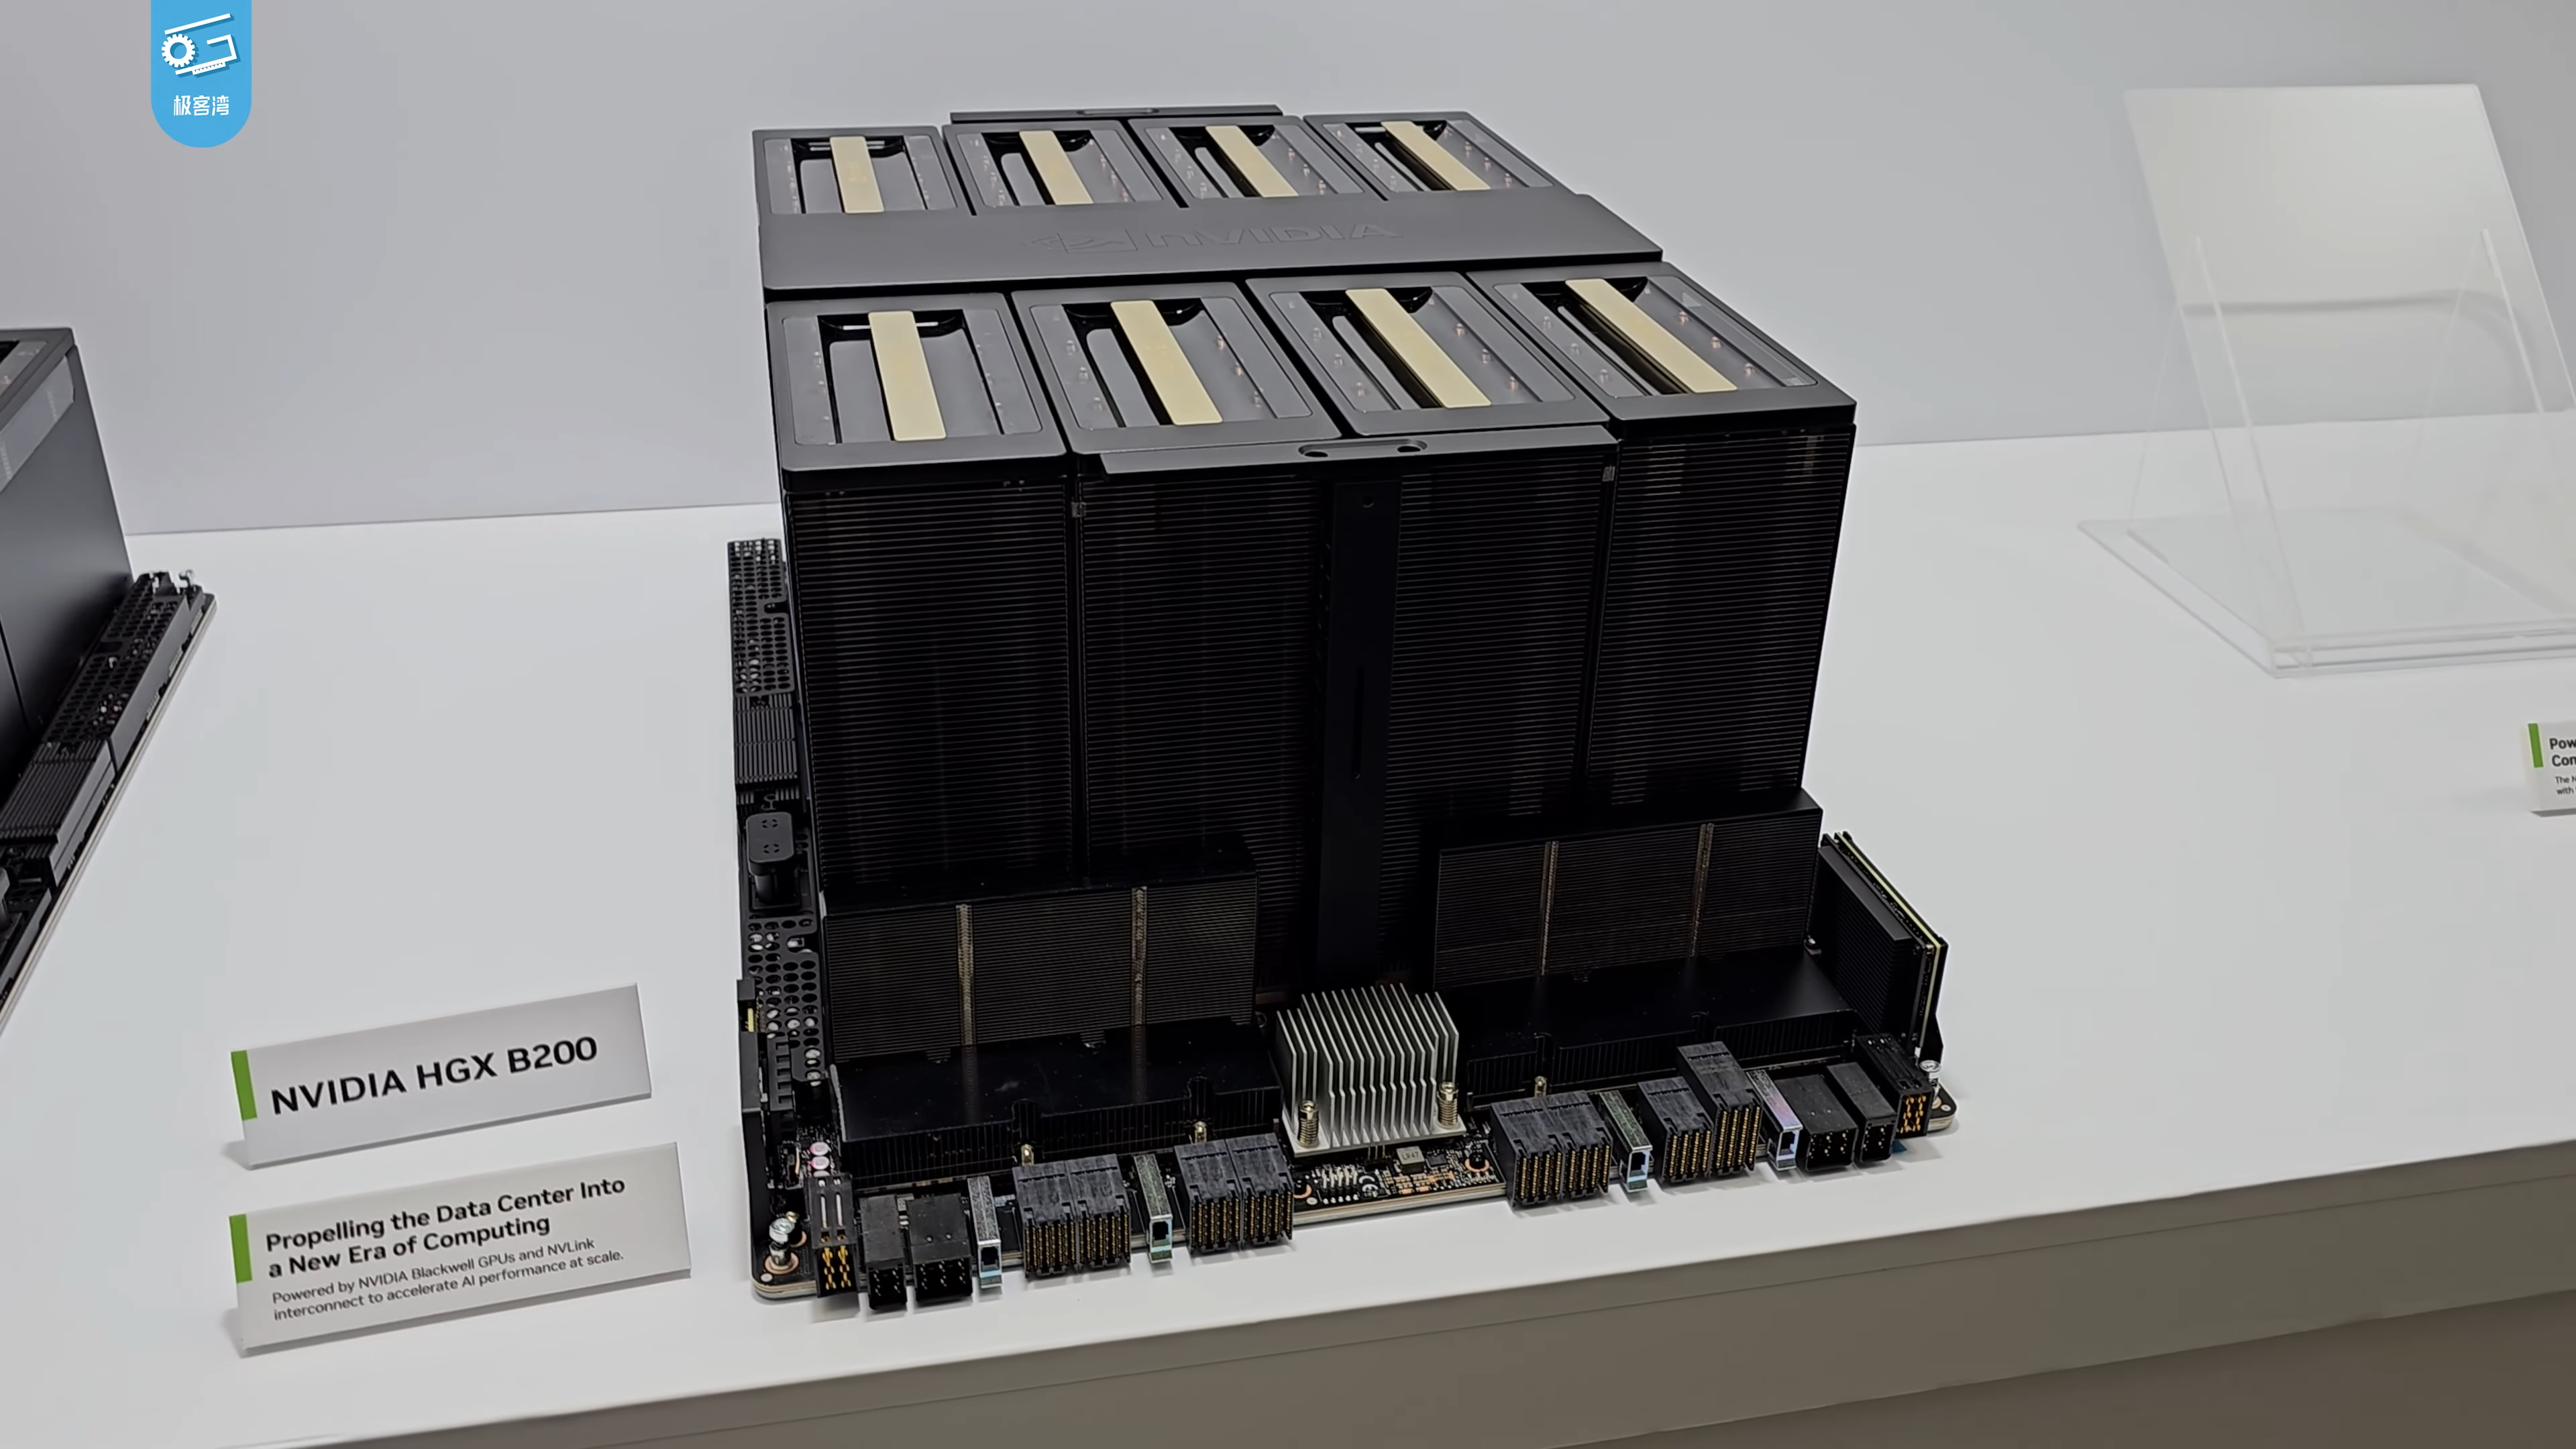
NVIDIAは9月22日、B200でのコンフィデンシャルコンピューティングによる推論テストの結果を公表した。GPU 8基でDeepSeek-R1を実行し、保護を有効にした状態でも、無効時の96.1%~98.2%のスループットを維持した。出力1トークン当たりの平均レイテンシーの増加率は1.2%~4.3%だった。今回新たに公開されたのはテスト結果とデプロイに関する分析であり、記事で引用されたTensorRT LLMの2件の修正は、すでに2月にマージされている。[公式テスト](https://developer.nvidia.com/blog/enabling-private-high-performance-production-ai-inference-with-nvidia-confidential-computing/)
テストではNVFP4の重み、FP8 KVキャッシュ、8ウェイのテンソル並列を採用した。入力長と出力長はそれぞれ32K、1Kで、同時リクエスト数は1~16だった。環境はIntel TDXとTensorRT LLM 1.3.0rc22の組み合わせだ。これらの条件によって数値の解釈範囲は限定されるため、他のモデル、短いリクエスト、同時実行数の多いサービスにおけるコストを、この結果から推定することはできない。[テスト構成](https://developer.nvidia.com/blog/enabling-private-high-performance-production-ai-inference-with-nvidia-confidential-computing/)
性能調整は、まずCPUとGPU間のデータ転送に施された。保護された仮想マシンのメモリにはGPUが直接アクセスできず、データは暗号化された中間バッファを経由する必要がある。このため、従来よく使われていたページロックメモリは、非同期転送における利点の一部を失う。関連する修正では、コンフィデンシャルコンピューティングの有効・無効に応じてページロックの適用を判断するよう変更した。また、サンプリングデータの読み戻しを処理する非同期ワーカーを追加し、コピー処理がメインスケジューラーをブロックする可能性を減らした。[メモリと読み戻しに関する修正](https://github.com/NVIDIA/TensorRT-LLM/pull/11573)
もう一つの変更は、自動チューニングの基盤となる計測に関するものだ。この保護モードではCUDAイベントによる時間計測が不安定になり、カーネル実装の選択に影響する可能性がある。代替の処理経路では、小さなCUDAカーネルでGPUのグローバルタイマーを読み取り、ホスト側で経過時間を計算する。計測バックエンドは保護の有効・無効に応じて選択されるほか、エンジニアが比較しやすいよう、環境変数による上書きも用意されている。[時間計測に関する修正](https://github.com/NVIDIA/TensorRT-LLM/pull/11657)
フレームワーク開発者にとって、これらの実装は問題を切り分ける順序の参考になる。まずデータ転送がスケジューリングを妨げていないかを確認し、次に計測ツールの影響でチューニング時に誤ったカーネルを選択していないかを調べ、最後にGPU間通信の待ち時間のコストを比較する。これは修正内容から導いた技術的な提案だ。GPUカーネルの速度だけを見ていると、保護モードによるホスト側の挙動の変化を見落とす可能性があるため、既存の最適化設定も再検証する必要がある。
GPU間通信には依然として制約がある。B200のこの種の構成ではNVLSマルチキャストがサポートされず、通信アルゴリズムをトポロジーとメッセージサイズに合わせて調整する必要がある。今回の結果はベンダーによるテストに基づくものであり、トークン当たりの平均レイテンシーだけでは、最初のトークンが出力されるまでの時間やテールレイテンシーがサービス目標を満たすかどうかは判断できない。デプロイの評価では、同じモデル、バージョン、ワークロードで保護の有効・無効を切り替え、リクエスト全体のレイテンシーも別途計測すべきだ。スループットが近いという結果は性能を判断する根拠にとどまり、セキュリティ検証の代わりにはならない。[適用上の制約](https://developer.nvidia.com/blog/enabling-private-high-performance-production-ai-inference-with-nvidia-confidential-computing/)