 GitHub Repo
vLLMコミュニティ、再起動後の出力不一致を報告 カーネルの自動チューニングが再現性に影響する可能性
固定シード、温度0のQwen3-8Bテストでも、カーネル構成の違いによって出力に差が生じた。関連するPyTorchの修正案は未マージで、影響範囲はバージョン、ハードウェア、コンパイル経路ごとに確認する必要がある。
Archive
AI 晶片、GPU、資料中心、邊緣裝置與硬體安全。
GitHub Repo
固定シード、温度0のQwen3-8Bテストでも、カーネル構成の違いによって出力に差が生じた。関連するPyTorchの修正案は未マージで、影響範囲はバージョン、ハードウェア、コンパイル経路ごとに確認する必要がある。
 GitHub Repo
単一マシンでのテストでは、メモリ設定の変更によりデコード時のGPU待機時間が短縮した。公式の既定値は引き続き無効で、効果と容量制限はデプロイ環境ごとに検証する必要がある。
 GitHub Repo
特定の設定ではGuidanceバックエンドが固定オブジェクトを書き換え、正しい出力が拒否され、誤った出力が通ることがある。コミュニティは修正案とテストを提出したが、まだマージされておらず、影響するバージョンの範囲も未確認だ。
 AI 研究
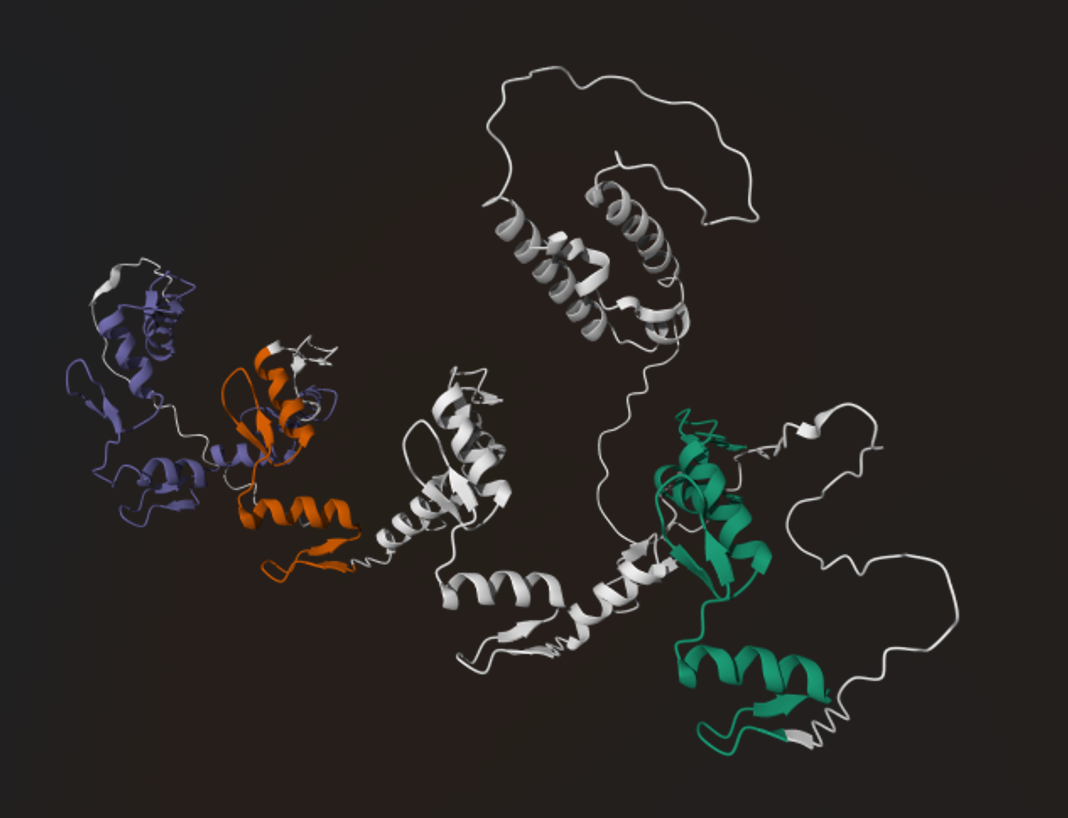
共同チームが2,812組のウイルスプロテオームを対象に、高信頼度の複合体予測とGPU計算パイプラインを公開した。導入には大容量GPUとクラスター環境が必要で、構造予測は実験による検証も欠かせない。
 GitHub Repo
実測したGPUコア時間からサービスのボトルネックを予測し、エージェントが候補となる最適化を推論フレームワークに適用する。チームはコードとテストケースを公開したが、効果はモデルや負荷に左右され、一部の修正は上流でのレビュー待ちだ。
 推論系統
約2.8億パラメータのドラフトモデルがLFM2.5-VL-3Bに投機的デコーディングを追加。公開ウェイトとフレームワーク統合も提供された。公式テストは特定のハードウェアと設定に限られ、ビジョンエンコーディング、プリフィル、並行負荷が全体の効果を制約する。
 最新模型
新バージョンはレイアウト解析と視覚言語モデルを組み合わせ、複数ページにまたがる表やフォーム項目の抽出をサポートする。公式評価ではテスト範囲の一部が変更されており、導入前にAPIのモデルバージョン対応を確認する必要がある。
 GitHub Repo
新版ではバックグラウンドスレッドで次の画像バッチを事前に読み込み、GPUがデータを待つ時間を短縮する。公開ベンチマークは特定のYOLO26n構成を対象としており、リリース概要とマージ履歴の間には適用範囲の記述に食い違いが残る。
 推論系統
単一のPallas呼び出しで92層をつなぎ、層をまたぐ重みのプリフェッチでメモリ帯域幅の利用率を向上。公式の比較は特定のトポロジーと小規模バッチに限られ、投機的デコーディングの性能はドラフトトークンの受理率にも左右される。
 GitHub Repo
新版ではIntelとApple Silicon向けのNode.js、uvを同梱し、起動時にアーキテクチャに応じて選択する。デスクトップ版は引き続き初期プレビュー段階にあり、エージェントの一連の処理とバックエンド設定は実環境での検証が必要だ。
 AI 基礎設施
BioNeMoがグループ化したエキスパート演算、エキスパート並列、MXFP8を組み合わせ、特定の訓練ワークロードのスループットを向上。最速構成では精度と並列化方式を同時に変更しており、性能向上は収束品質と併せて評価する必要がある。
 硬體
モバイルゲーム向けの超解像とフレーム生成のインターフェースを提供し、ネイティブ統合ドキュメントも公開。初版のフレーム生成では、実際にレンダリングされる1フレームの時間分だけ入力遅延が増えるため、効果は消費電力や画質と併せて評価する必要がある。