硬體

AI 晶片、GPU、資料中心、邊緣裝置與硬體安全。

最新模型

Cosmos 3 Edge、世界モデルを4Bに小型化し、単一GPUで視覚・テキスト・ロボット動作を同時処理

NVIDIAはCosmos 3 Edgeの重みと推論パイプラインを公開した。4BのMixture-of-Transformersに自己回帰推論と拡散ベースのマルチモーダル生成を組み合わせ、テキスト、画像、動作軌跡を入力できる。DROIDデータでファインチューニングしたロボットポリシー版も提供するが、物理的一貫性とエッジデバイスでのレイテンシーについては、独立した検証がなお必要だ。
科學機器學習

UNICON、4,160万パラメータで9種類の数値システムを統一、重みを凍結したまま分野横断予測

UNICONは、河川、交通、電力網、気象、人流などのデータを共通のグラフ系列インターフェースに変換し、少数の数値例を通じてコンテキスト内で新たなタスクを指定する。学習に含まれていないWebトラフィックなどの分野でも専用モデルに迫るが、現時点で検証されているのは予測タスクのみで、重みとコードも公開されていない。

推論系統

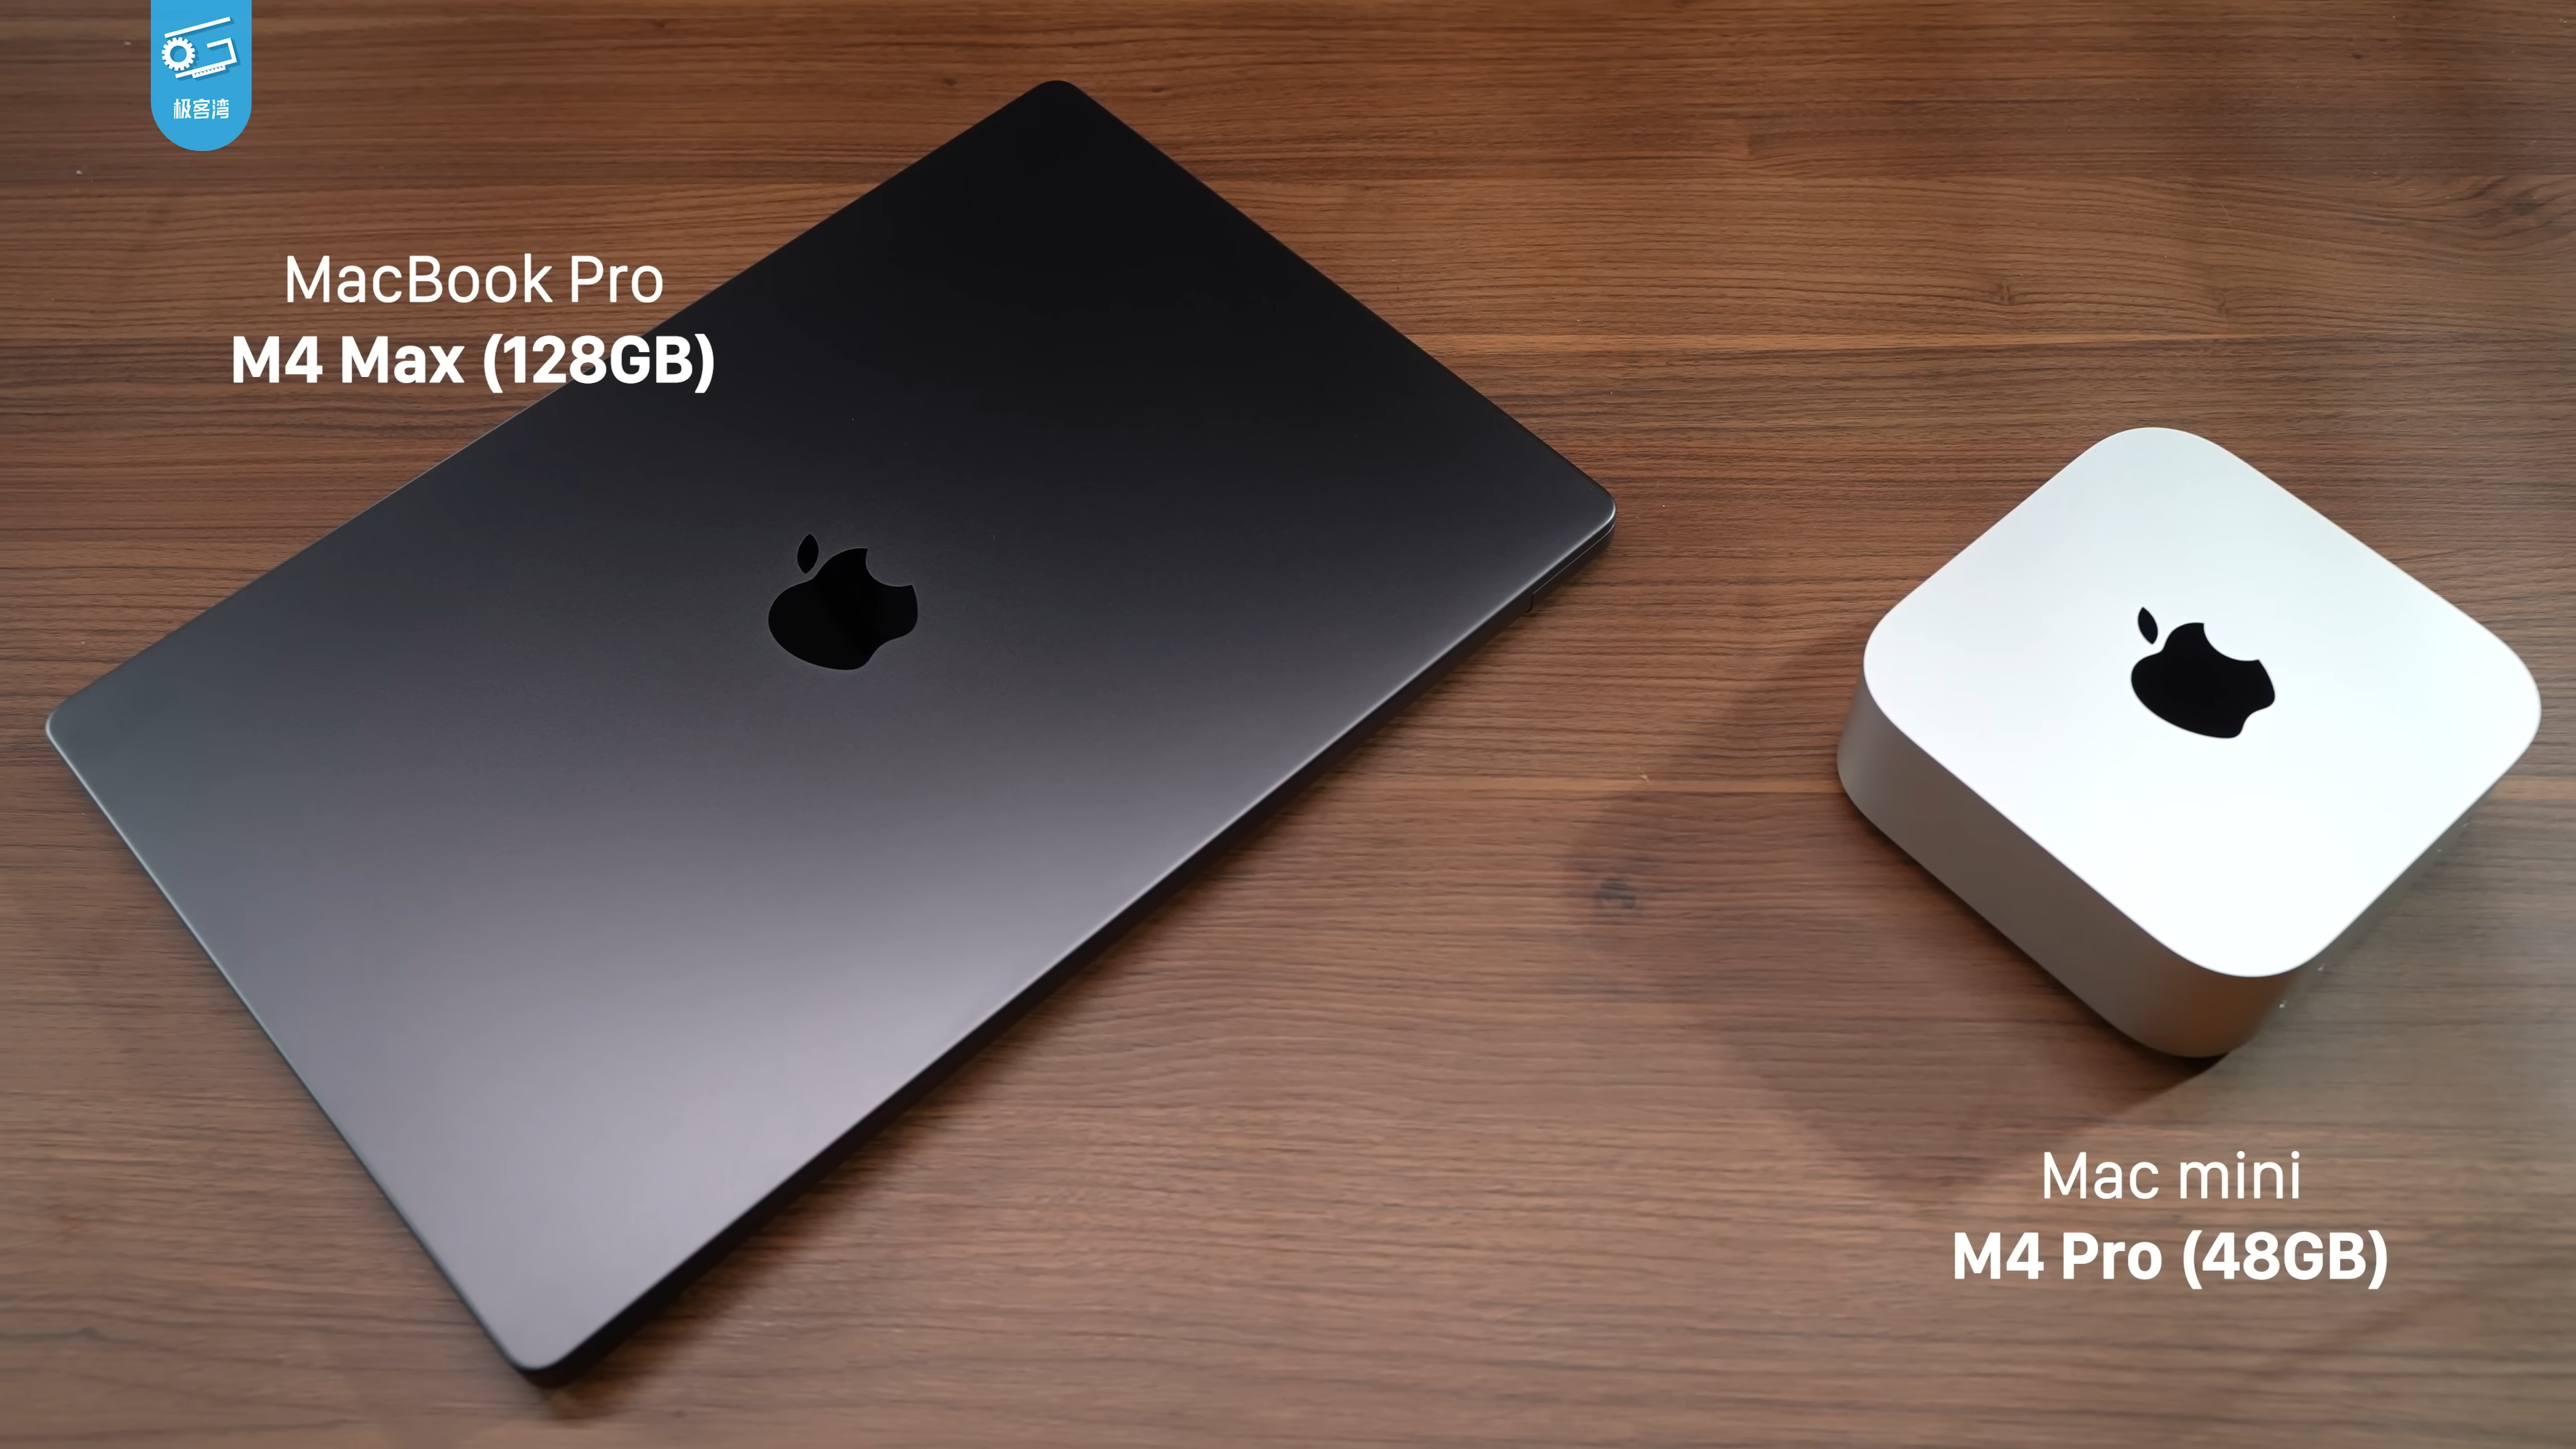
M4 MaxのローカルLLM実測:デコードはGB10より高速、ただし応答全体は依然としてprefillが制約

同価格帯のローカルAIプラットフォームを比較した最新テストでは、546GB/sのユニファイドメモリ帯域幅を備えるM4 Maxが、3種類の量子化モデルにおけるtoken単位のデコードでGB10とStrix Haloを上回った。一方、prompt prefillと総合的な電力効率ではGB10が依然優位であり、tokens/sだけを見ると実際の応答時間を見誤る可能性がある。

代理工具

Home Assistant 2026.8 Beta、llama.cppとLiteLLMをネイティブ統合――住宅向け会話エージェントを完全セルフホスト可能に

Home Assistantにllama.cppとLiteLLMの会話統合が追加され、モデルごとに個別のエージェントと指示を設定できるようになった。今回の更新でローカルモデル導入のハードルは下がるが、現時点ではまだbetaであり、エンドツーエンドのtool callingの信頼性はモデル、schema、ハードウェアに左右される。

實體 AI/科學自動化

PUDA、制限付きCLIとイベントログでラボエージェントを接続し、生成的プランニングをハードウェアドライバ層から分離

PUDAは自動化機器を探索可能なコマンドラインツールとして公開し、JSON、NATS/JetStream、安定した識別子を用いてコマンド、測定、サンプルの来歴を保存する。エージェントは次の実験を選択できるが、実際のハードウェア操作は、エンジニアが事前に作成し、パラメータ検証を組み込んだドライバメソッドを介してのみ実行される。

硬體

ACE-RTLがNemotronにVerilogの反復コンパイルと修正を実行させ、9種類のタスクで平均合格率97.1%を達成

NVIDIAはNemotron 3 Ultraを「生成—テスト—リフレクション」のRTLエージェントループに統合し、CVDPの9種類のエージェントタスクで平均合格率97.1%を達成した。この結果は、実行可能な検証がチップ設計モデルを大幅に強化できることを示す一方、データの関連性、ツール設定、ベンダーによる自己評価が依然として結果の一般化を制約している。

最新模型

Kimi K3、2.8T MoEの重みを公開――104Bのアクティブパラメータでセルフホスティングのハードルはクラスター級に

Moonshot AIがKimi K3の重みと技術レポートを正式に公開した。ネイティブな視覚処理、100万tokenのコンテキストを備え、各tokenにつき896個の専門家のうち16個をアクティブ化する。オープンウェイト化により、公式が主張する能力をようやく再現できるようになったが、低精度化しても1TBを超える重みのため、完全なデプロイは依然として一般的なワークステーションの手には届かない。

最新模型

JSONを要求するだけで44モデルの回答が収束、構造化出力がモデルの判断を変える可能性

44の言語モデルを対象とした実験で、単に「JSONで回答する」と指示するだけで、schema enforcementやconstrained decodingを使わなくても回答の多様性が低下することが分かった。この結果は、構造化出力が単なるserialization layerではなく、モデルが実際に選ぶ回答そのものを変える可能性を示している。

推論系統

NInfer、2つのQwen3.6向けに推論パスをハードコード――RTX 5090単体で長文デコード毎秒543 tokenを達成

オープンソースのNInferは、カスタム量子化、重みレイアウト、融合カーネル、MTPドラフトパスにより、Qwen3.6-35B-A3Bの長文デコードをRTX 5090単体で約543 token/秒に維持する。この速度はモデルとGPUに対する高度な特化によるもので、現時点では2つのcheckpointのみをサポートし、continuous batchingを備えておらず、同一条件での独立評価もまだない。

硬體

CoTinyVLA、9億パラメータで7Bのロボティクスベースラインを上回るも、実験は依然シミュレーション環境に限定

CoTinyVLAは、35B教師モデルの階層的推論を0.9Bの視覚・言語・行動モデルへ蒸留し、LIBERO-Plusの4つのテストスイートすべてで最強の7Bベースラインを上回った。コード、訓練パイプライン、重みは公開済みだが、実機ロボット、異なるハードウェア、外部チームによる再現結果はまだない。

推論系統

Sol-Attn、online softmax内で注意を動的にスパース化し、動画生成をエンドツーエンドで2倍超高速化

NVIDIAの研究チームは、再学習を必要としないSol-Attnを公開した。注意演算中に重要なブロックを選択し、スキップしたブロックの寄与を近似的に補完する。公式評価では複数の動画モデルで約1.9~2.34倍のエンドツーエンド高速化を確認したが、品質とハードウェア間の汎化性能については、なお独立した検証が必要だ。