PTQ4SNN 同時量化權重與膜電位,事件分類僅損失 1 個百分點
PTQ4SNN 把脈衝神經網路長期保留的浮點膜電位納入後訓練量化,按通道配置 2、4 或 8 位元。論文在分類與語意分割上接近浮點模型,但硬體收益仍來自分析模型,且專用程式尚未公開。
Archive
AI 晶片、GPU、資料中心、邊緣裝置與硬體安全。
PTQ4SNN 把脈衝神經網路長期保留的浮點膜電位納入後訓練量化,按通道配置 2、4 或 8 位元。論文在分類與語意分割上接近浮點模型,但硬體收益仍來自分析模型,且專用程式尚未公開。
 最新模型
Muse Glimmerは、マルチモーダル入力、ツール呼び出し、失敗時の再試行を、コンシューマー向けハードウェアにデプロイ可能な30BのDenseモデルに統合した。Apache 2.0ライセンスの重みと公式GGUFはすでに公開されているが、性能および安全性の数値は現時点で主にMeta自身の評価に基づいている。
 推論系統
コミュニティのデプロイ手順では、単一のDGX Spark上でCUDA Graphと1層のMTP投機的デコーディングを有効にし、Ling-3.0-flash INT4の生成速度を20.8 token/sから38.7 token/sへ引き上げた。さらに重要なのは、メインラインのvLLMがV3アーキテクチャをまだサポートしておらず、古いattentionパスを無理に適用すると、エラーが報告されないまま、一見流暢だが誤った内容が出力される可能性があるという点だ。
 硬體
MicroEvoは、プロセッサ設計の知識、Pareto木探索、過去のPPAフィードバックを組み合わせ、より少ないシミュレーションで性能・消費電力・面積のトレードオフを探索する。最大36.2%のhypervolume向上はシミュレーション上の設計空間で得られたものであり、実チップの改善と同一視することはできない。
 推論系統
PaDocは、レイアウト系列と各領域のコンテンツでページ接頭辞を共有し、並列デコードを行うことで、ページ全体を単一の系列として処理することを回避する。2.1BモデルはOmniDocBenchで総合スコア94.24を維持したが、性能値は単一GPUと特定のスケジューリング設定に基づく。
 硬體
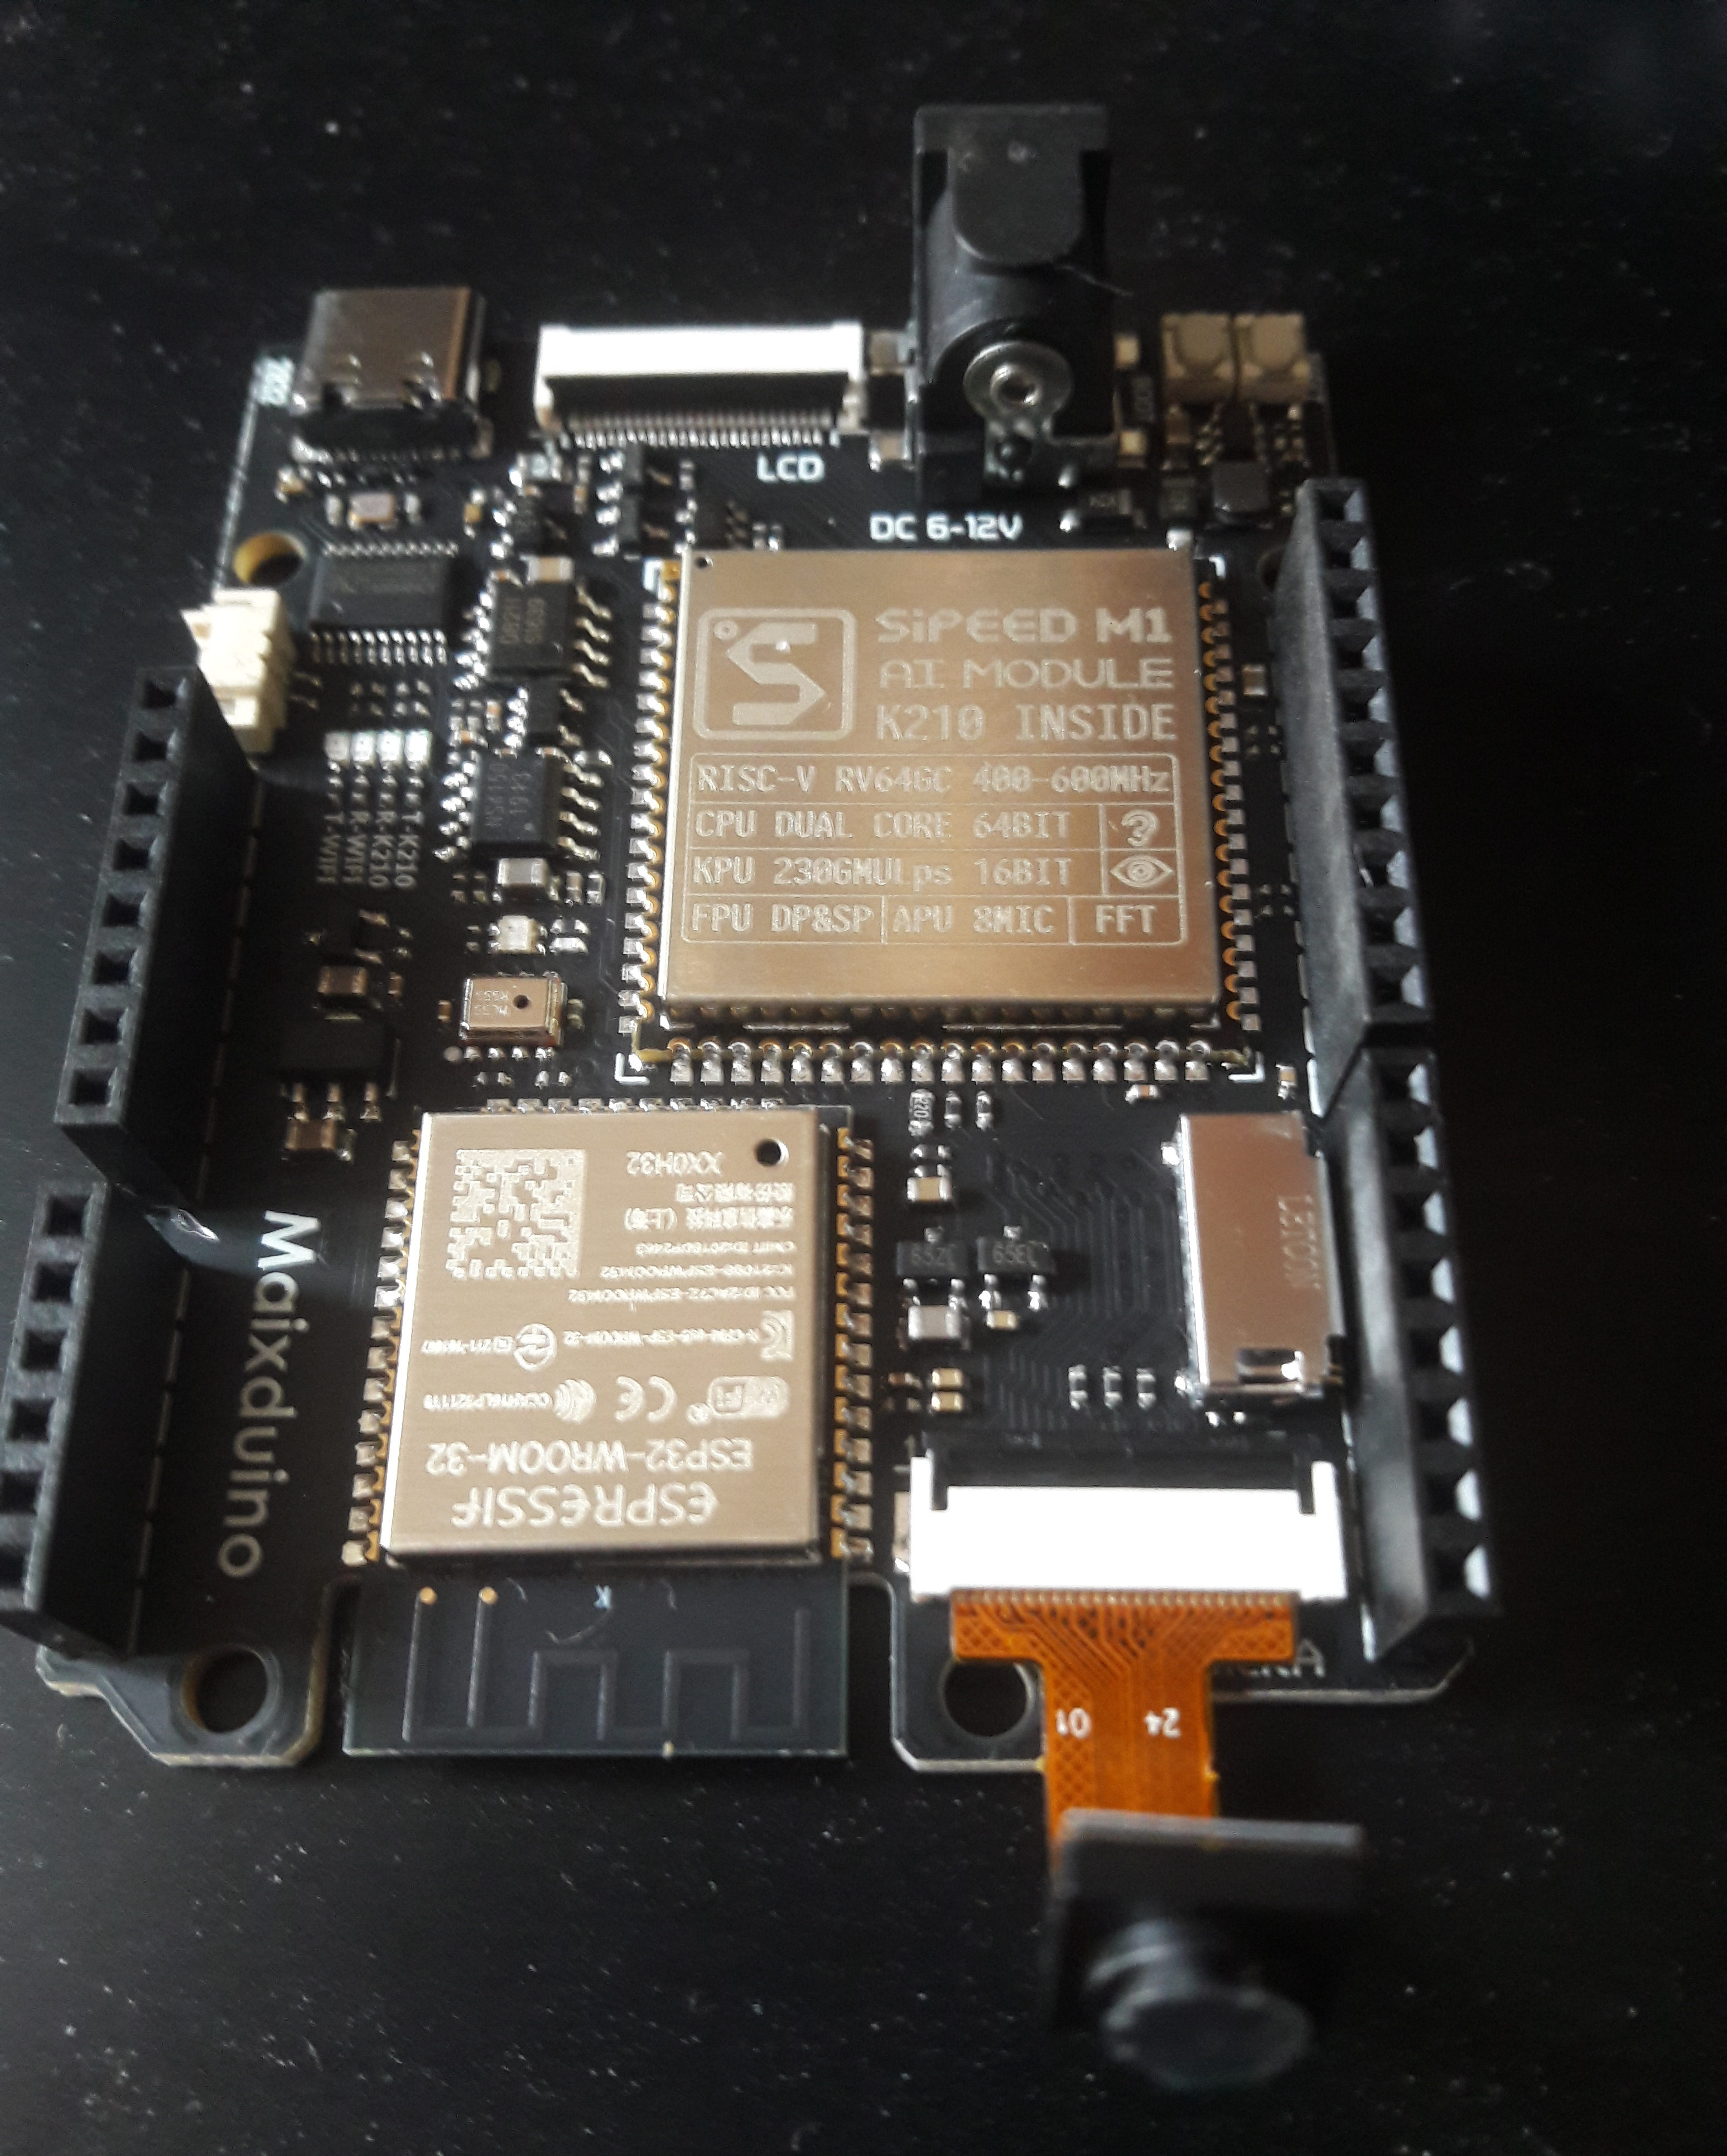
オープンソースプロジェクトのesp32-aiは、4-bit量子化と階層型メモリ配置を採用し、約2,500万の埋め込みパラメータをflashに保持して、tokenごとに必要な行だけを読み出す。10米ドル未満のマイクロコントローラ上でオフラインのテキスト生成が可能だが、その能力は依然として短い物語や単一分野の質問応答に限られる。
 推論系統
PhyAIはモデルアダプターにより各アーキテクチャの条件、ソルバー、行動セマンティクスを維持しつつ、グラフ実行、カーネル、キャッシュ、マルチGPUサービスを共通化する。公開テストはπ0、π0.5、GR00T N1.7、Cosmos3、MiniCPM-Robotを対象とするが、一部の比較では数値精度が完全には統一されていない。
 AI 基礎設施
Microsoft Azureの研究により、エージェントがモデル推論、ツール、オーケストレーターの間を繰り返し切り替えることで、CPUが再びクリティカルパスに入り、その一方でGPUは頻繁にアイドル状態になることが示された。プロトタイプシステムのAgoraは、ワークフローの特性に応じて計算資源を回収できるが、並列エージェントへのGPU割り当てを誤って縮小すると、テールレイテンシがかえって16倍に悪化する。
 最新模型
新たな研究では、音声文字起こしとQWERTYキーボード由来の摂動を用いて命令モデルを検証し、音声による構造の書き換えが一貫して回答性能を低下させることが分かった。推論予算を増やすことでキーボード入力経路の性能はほぼ回復したが、音声入力では同様の改善が得られなかった。
新基準以可視辨識的真實實體測試視覺語言模型,發現只用文字做知識遺忘,效果不易轉移至圖片與跨模態問答。多模態遺忘可回頭通過文字測試,顯示單一文字評測可能高估刪除成效。
 最新模型
新たな研究では、教師モデルの少数のlogitsを事前にキャッシュし、チャンク化・融合KL kernelによって完全な語彙テンソルの生成を回避する。単一GPUで蒸留コンテキストを8Kから32Kへ拡張できるが、速度と品質に関する結論は、依然として限定的なモデルおよびハードウェア構成に基づいている。
 推論系統
同一ファミリーの小規模モデルが生成したKV cacheを大規模モデルへマッピングし、長い対話の途中でモデルを切り替える際にプロンプト全体を再処理する必要をなくす新手法。6組のモデルペアのうち、元の精度の73~98%を維持できたのは4組にとどまり、テンソルの互換性が意味的な互換性を保証するわけではないことが示された。