 AI 基礎設施
GigaToken 以 Rust、SIMD 與檔案直讀加速 BPE,GPT-2 分詞自測達 24.53 GB/s
開源專案 GigaToken 0.9.0 將預分詞、BPE 合併與資料輸入路徑重新最佳化,宣稱在雙路 144 核 AMD EPYC 主機上比 Hugging Face Tokenizers 快 989 倍。最大數字依賴原生 API、11.9 GB 批次語料及高度平行硬體,不能直接套用到線上短請求。
Archive
GitHub 熱門專案、開源工具、框架、runtime 與重要 release。
AI 基礎設施
開源專案 GigaToken 0.9.0 將預分詞、BPE 合併與資料輸入路徑重新最佳化,宣稱在雙路 144 核 AMD EPYC 主機上比 Hugging Face Tokenizers 快 989 倍。最大數字依賴原生 API、11.9 GB 批次語料及高度平行硬體,不能直接套用到線上短請求。
 GitHub Repo
在 Sashiko 與 Patchwork 串接討論中,Linus Torvalds 明確表示 Linux kernel 不是反 AI 專案;反對者可以依開源規則 fork,或選擇離開。這不是全面放行 AI 產物,而是把 AI 工具納入既有技術評估:結果要有用、責任仍在人類維護者與提交者身上。
 訓練系統
研究團隊針對 DeepSeek-V4 家族重做平行策略、通訊排程、核心與算子融合,使 Ascend 訓練效率達開源基線的 2.93 倍。系統再以求解器驗證資料訓練運籌研究模型,但程式、資料與硬體測量仍需更完整的公開重現。
 推論系統
BaseRT 新增手寫的稠密、MoE GEMM 與 FlashAttention 核心,將提示階段的矩陣運算交給 M5 GPU 內的神經加速器。團隊在 M5 Pro 報告顯著領先 llama.cpp 與 MLX,但數據目前仍來自開發者自己的單機測試。
 推論系統
SWE-Pruner Pro 不再呼叫獨立分類器,而以輕量預測頭從程式代理的內部表徵判斷每行工具輸出是否保留。研究在兩款開放 MoE 模型與四項多輪基準上取得 token 節省,但需要修改推論伺服器,且部分品質增益尚待重現。
 具身 AI/機器人
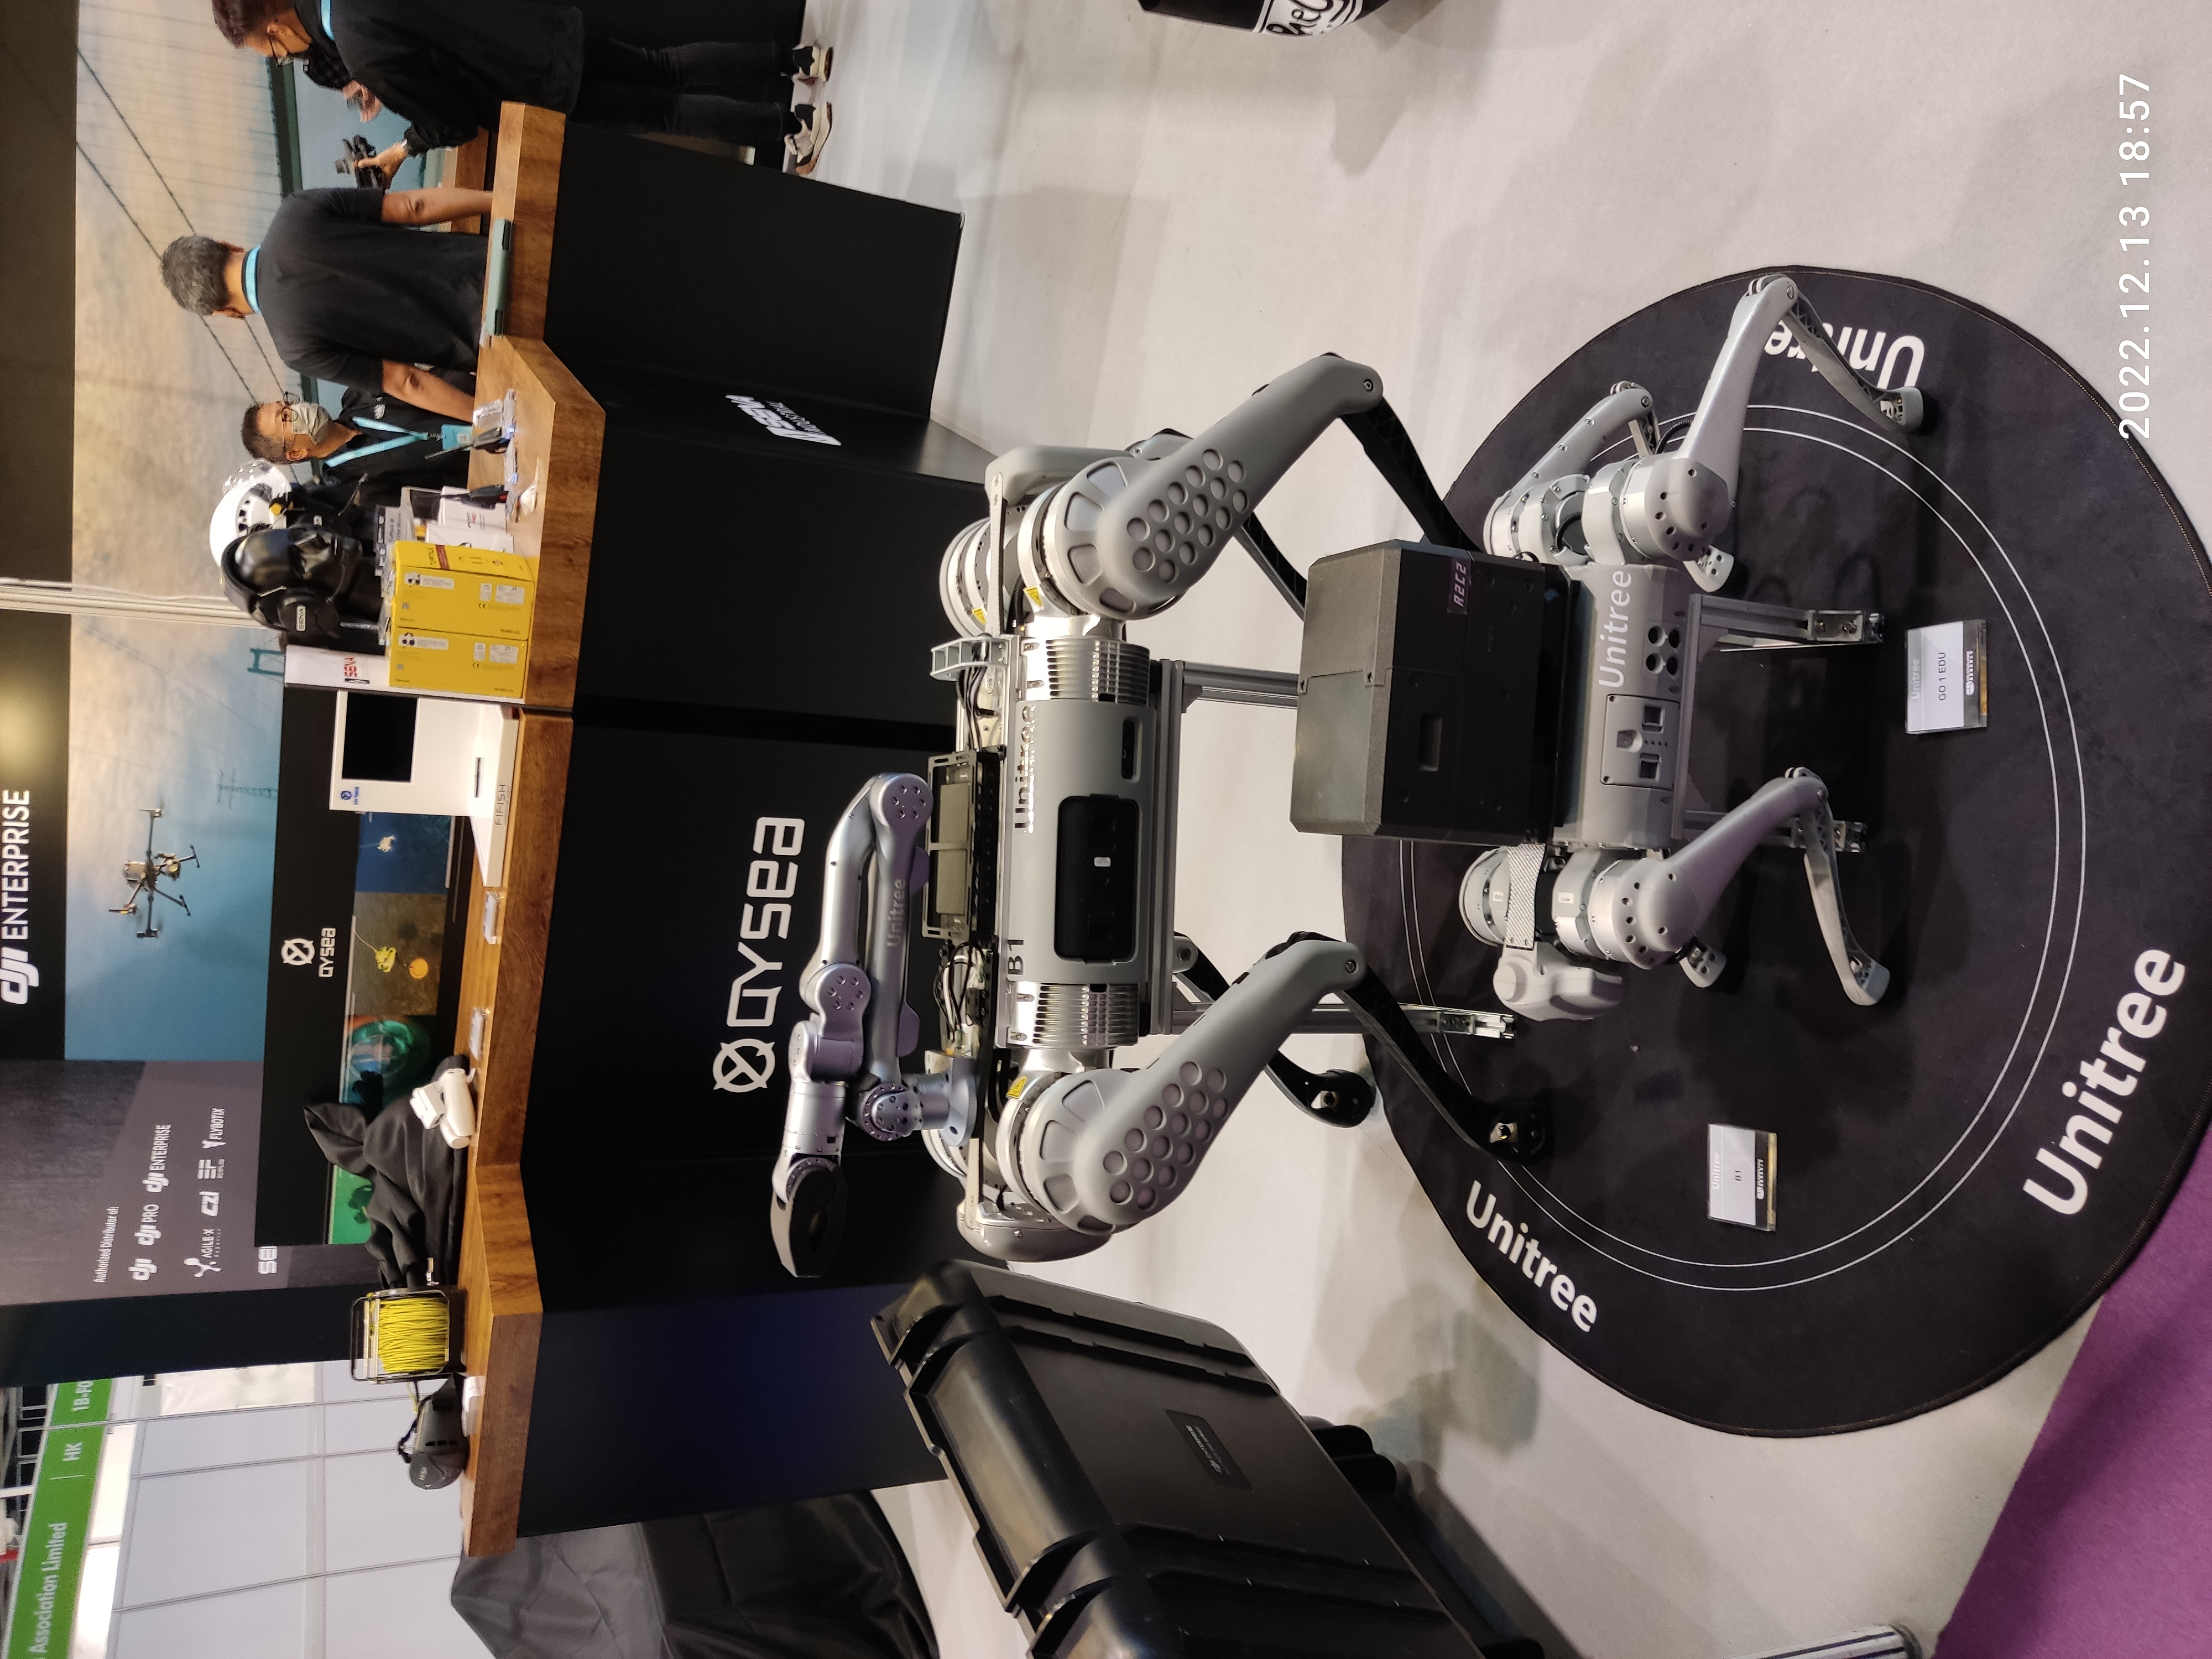
阿里巴巴達摩院發布 2B、9B 與 122B-A10B 三種 RynnBrain 1.1 模型,新增接觸點預測及原生 3D grounding。配套 RynnBrain-VLA 以統一動作空間跨 Unitree G1、Astribot-S1 與天機舞姬訓練,但跨硬體泛化仍主要由團隊自有實驗支持。
 開發者工具
GitHub 新增 Copilot impact dashboard,依程式優先、代理優先及多代理等使用階段比較合併速度與產出。新介面讓企業能觀察工具採用深度,但仍缺少缺陷、返工與長期維護成本等品質訊號。
 機器人資料與工具
Pollen Robotics 發布約 490 歐元的手持式 Grabette,利用雙相機、IMU 與夾爪編碼器記錄六自由度操作。瀏覽器處理流程會執行 SLAM、檢查軌跡並輸出標準 LeRobot 資料。
 代理工具
AgentLens 不只檢查代理是否解出程式題,而是審查完整互動軌跡與實際產品結果。開源基準可用於比較模型版本、定位行為退化,並接入持續整合流程。
 推論系統
Diffusers 現可直接載入 Nunchaku Lite 的 INT4 與 NVFP4 檢查點,不必另裝模型專用推論引擎。SVDQuant 同時量化權重與啟用值,目標是在節省顯存之外真正縮短去噪時間。
 GitHub Repo
Google 發布 Gemma 4 12B 開放權重模型,以線性投影取代獨立視覺與音訊編碼器。新架構簡化微調與本機推論,但官方效能數據仍須由獨立測試驗證。
Google 發布 LiteRT.js,讓網頁應用直接執行 `.tflite` 模型,並依裝置使用 CPU、GPU 或 NPU。它把瀏覽器端 AI 從 JavaScript 核心推向跨平台原生執行堆疊,但效能與相容性仍高度依賴瀏覽器及硬體。