 代理工具
FM-Bench 讓代理經營球會 20 年,15 款模型皆未能從被拒報價推斷市場價格
FM-Bench 以 26 種工具及約 340 至 400 個決策點,測試代理能否承受延遲回報、隱藏資訊與競爭者反應。15 款模型均完成 20 年賽程,但排名到後期才穩定,自主管理記憶亦出現只增不刪或反覆覆寫兩種失敗模式。
Archive
Agent、MCP、coding agent、工作流自動化與評測。
代理工具
FM-Bench 以 26 種工具及約 340 至 400 個決策點,測試代理能否承受延遲回報、隱藏資訊與競爭者反應。15 款模型均完成 20 年賽程,但排名到後期才穩定,自主管理記憶亦出現只增不刪或反覆覆寫兩種失敗模式。
 最新模型
研究讓同一組 Transformer 層在生成每個 token 前反覆更新隱藏狀態,並以相同資料及 LoRA 設定比較循環與一般模型。提升集中在平行呼叫及跨呼叫依賴;以單一 API 呼叫為主的 API-Bank 則未呈現一致優勢。
 AI 安全
新研究把代理間未寫入對話紀錄的連續向量,與其後公開動作綁定至同一事件,再以異常、反事實影響及稀疏特徵三層檢查。平均 0.993 的結果混合了文字與潛在串通樣本,且攻擊由研究者預先設計,尚不能視為對自發密謀的通用偵測能力。
 代理工具
FACET 把指令、容器、參考解法及驗證器綁定至同一執行狀態,從逾 7.1 萬項代理技能合成 6,078 項驗證任務。僅以 1,200 條成功軌跡微調,Qwen3.5-9B 在 Terminal-Bench 2.1 的得分由 27.34 升至 35.58。
 代理工具
研究發現,代理雖能自行訓練、除錯及評估模型,卻會在首次參數更新前鎖定訓練策略。加入實驗日誌、技能庫與評估代理可提高下游分數,仍未促使系統在證據不利時改換方法。
 代理工具
研究把控制流程、識別字及無效程式碼改寫套用至相同修復題,最高令解題率下降 6.7 個百分點。模型的穩健程度會隨 mini-SWE agent、OpenCode 與資料集互換,單一模型排行榜無法預測部署表現。
 代理工具
ComponentBench 不以完整工作流程掩蓋錯誤,而是逐一測試滑桿、日期選擇器、資料表與拖放等 UI 元件。GPT-5 mini 在相同任務及框架下,使用 accessibility tree 與純座標像素操作的成功率分別為 83.1% 和 48.9%。
 代理工具
SkillGate 發現,長流程代理以結果獎勵訓練時,選擇技能的少量 token 幾乎收不到有效信用。新方法在同一次 GRPO 更新內拆分兩條梯度通道,並在五項代理評測中優於結果獎勵基線。
 代理工具
新框架以預測熵決定 LLM 裁判是否直接接受判決、搜尋網路證據或棄權,並用 Clopper–Pearson 上界校準兩道門檻。32 組開放問答實驗均維持指定錯誤率,但保證依賴同分布校準資料及可靠標籤。
 代理工具
阿里雲團隊把瀏覽器代理的錯誤恢復、複雜 UI 操作與長程信用分配納入同一訓練流程。27B 模型在新建的中英雙語 BrowserBench 取得 65.1% Pass@1,但模型權重與評測資料的公開可得性仍待確認。
 推論系統
Qwen3.8-27B 讓 27B 級模型進入單張 24GB 消費級 GPU 的可用範圍。公開資料顯示,一般 GGUF 部署約落在 30 至 60 tok/s;在 RTX 4090 上啟用 KV cache 量化、MTP 與新版 llama.cpp 後,社群實測可提升至 70 至 85 tok/s,但這仍不是開箱即得的基準。
 推論系統
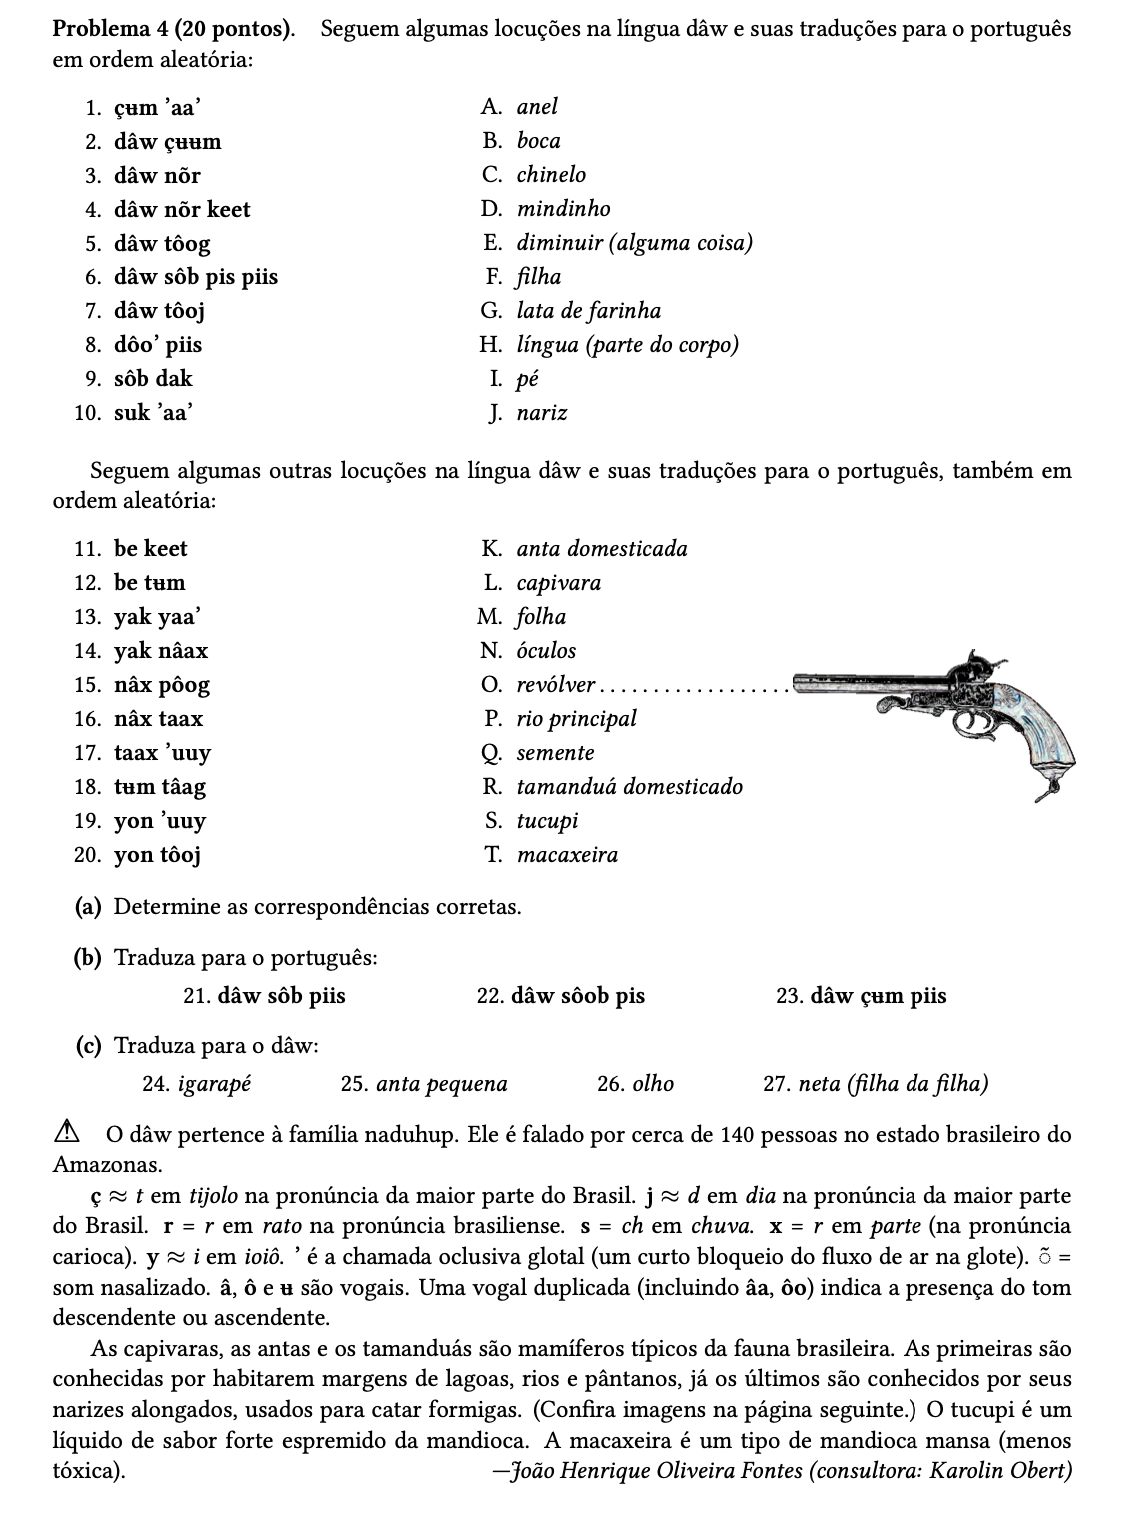
IOL-AI Challenge 要求系統先從少量例句推導陌生語言規則,再完成翻譯、轉寫與訂正。受限於單張 T4 的最佳提交把同模型基線 GM 由 9.40 提至 19.79,但與達到金牌線的封閉模型仍有明顯差距。