代理工具

Agent、MCP、coding agent、工作流自動化與評測。

機器人與具身 AI

HiFi-UMI、ミリメートル精度のウェアラブルデータでロボットを直接訓練――ポストトレーニングで実機デモが不要に

HiFi-UMIは、オフラインのステレオ慣性SLAM、マイクロ秒精度の同期、両手を捉える6視点を統合したポータブルなデータシステムだ。人間の操作データのみをロボットのポストトレーニングに直接利用できる。3種類のVLA/世界・行動モデルの実機成功率は現場での遠隔操作ベースラインに近いが、結果は依然として単一チームによる制御されたタスクに集中している。
實體 AI/科學自動化

PUDA、制限付きCLIとイベントログでラボエージェントを接続し、生成的プランニングをハードウェアドライバ層から分離

PUDAは自動化機器を探索可能なコマンドラインツールとして公開し、JSON、NATS/JetStream、安定した識別子を用いてコマンド、測定、サンプルの来歴を保存する。エージェントは次の実験を選択できるが、実際のハードウェア操作は、エンジニアが事前に作成し、パラメータ検証を組み込んだドライバメソッドを介してのみ実行される。

代理工具

CAPA、コーディングアシスタントのセッション横断記憶を評価:同一ユーザーの履歴で初回成功率が平均15.6ポイント向上

CAPAは、ユーザーが繰り返し省略する実装上の好みを600件の実行可能なコーディングタスクに組み込み、アシスタントが過去の会話から新たな要件を推測できるかを検証した。12モデルでは、同一ユーザーの履歴を追加しても最終成功率の上昇は平均6.8ポイントにとどまった一方、初回成功率は15.6ポイント向上した。これは、記憶が主に確認のやり取りを減らすものであり、失敗そのものを解消するわけではないことを示している。

代理工具

TREK、実行可能なルールで旅行エージェントを検証――最強モデルでも完全実行可能率は46.2%にとどまる

TREKは、LLMによる旅行計画の評価をやめ、エンティティ、予算、営業時間、交通手段、暗黙の要件を項目ごとに検証する。15種類のエージェントのうち最高性能のモデルでも、解決可能なタスクを完全に通過した割合は46.2%にすぎず、部分的に正しくても実行可能な旅程としてまとめることは依然として難しいと示された。

AI 安全

SecRespondが侵害後フォレンジックのワークフローを再現、23モデルはいずれも単一の演習環境を完全に検知・修復できず

SecRespondでは、セキュリティエージェントがクリーンな環境で攻撃課題を解くだけでなく、侵害されたホストの読み取り専用ディスクスナップショットを分析する。23モデルはアラートの内容を言い換えることはできたものの、アラートで明らかにされていないインプラントや修復の検証を総じて見落とした。

代理工具

CAM-DF、エージェントのツールランキングをコスト考慮型の停止判断へ転換し、ツール露出を37%削減

新たな研究によると、関連性ランキングで決められるのはツールの順序だけで、エージェントが何個のツールを読み込むべきかには答えられない。CAM-DFは読み込みを継続する限界便益を直接学習し、ほぼ同等のタスク成功率を維持しながらツール露出を37%削減する。

AI 安全

MemTX、エージェントの共有メモリをトランザクション型コミットに変更、550万のプロトコル状態を網羅的に検証しても安全規則の違反なし

MemTXでは、エージェントが書き込んだ情報を即座に実行可能な事実として扱わず、証拠、権限、出所、スナップショット分離、検証付きコミットを導入する。研究では5つのモデルすべてで下流への被害がゼロだったと報告されたが、結果は依然として制御された評価環境に基づくものであり、現実の外部システムで生じる不可逆な副作用を修復できることまでは証明されていない。

代理工具

OmegaUse-OfficeVal、オフィスエージェント評価にタスク別コストラベルを導入 最高性能モデルも品質では人間に3分の1超及ばず

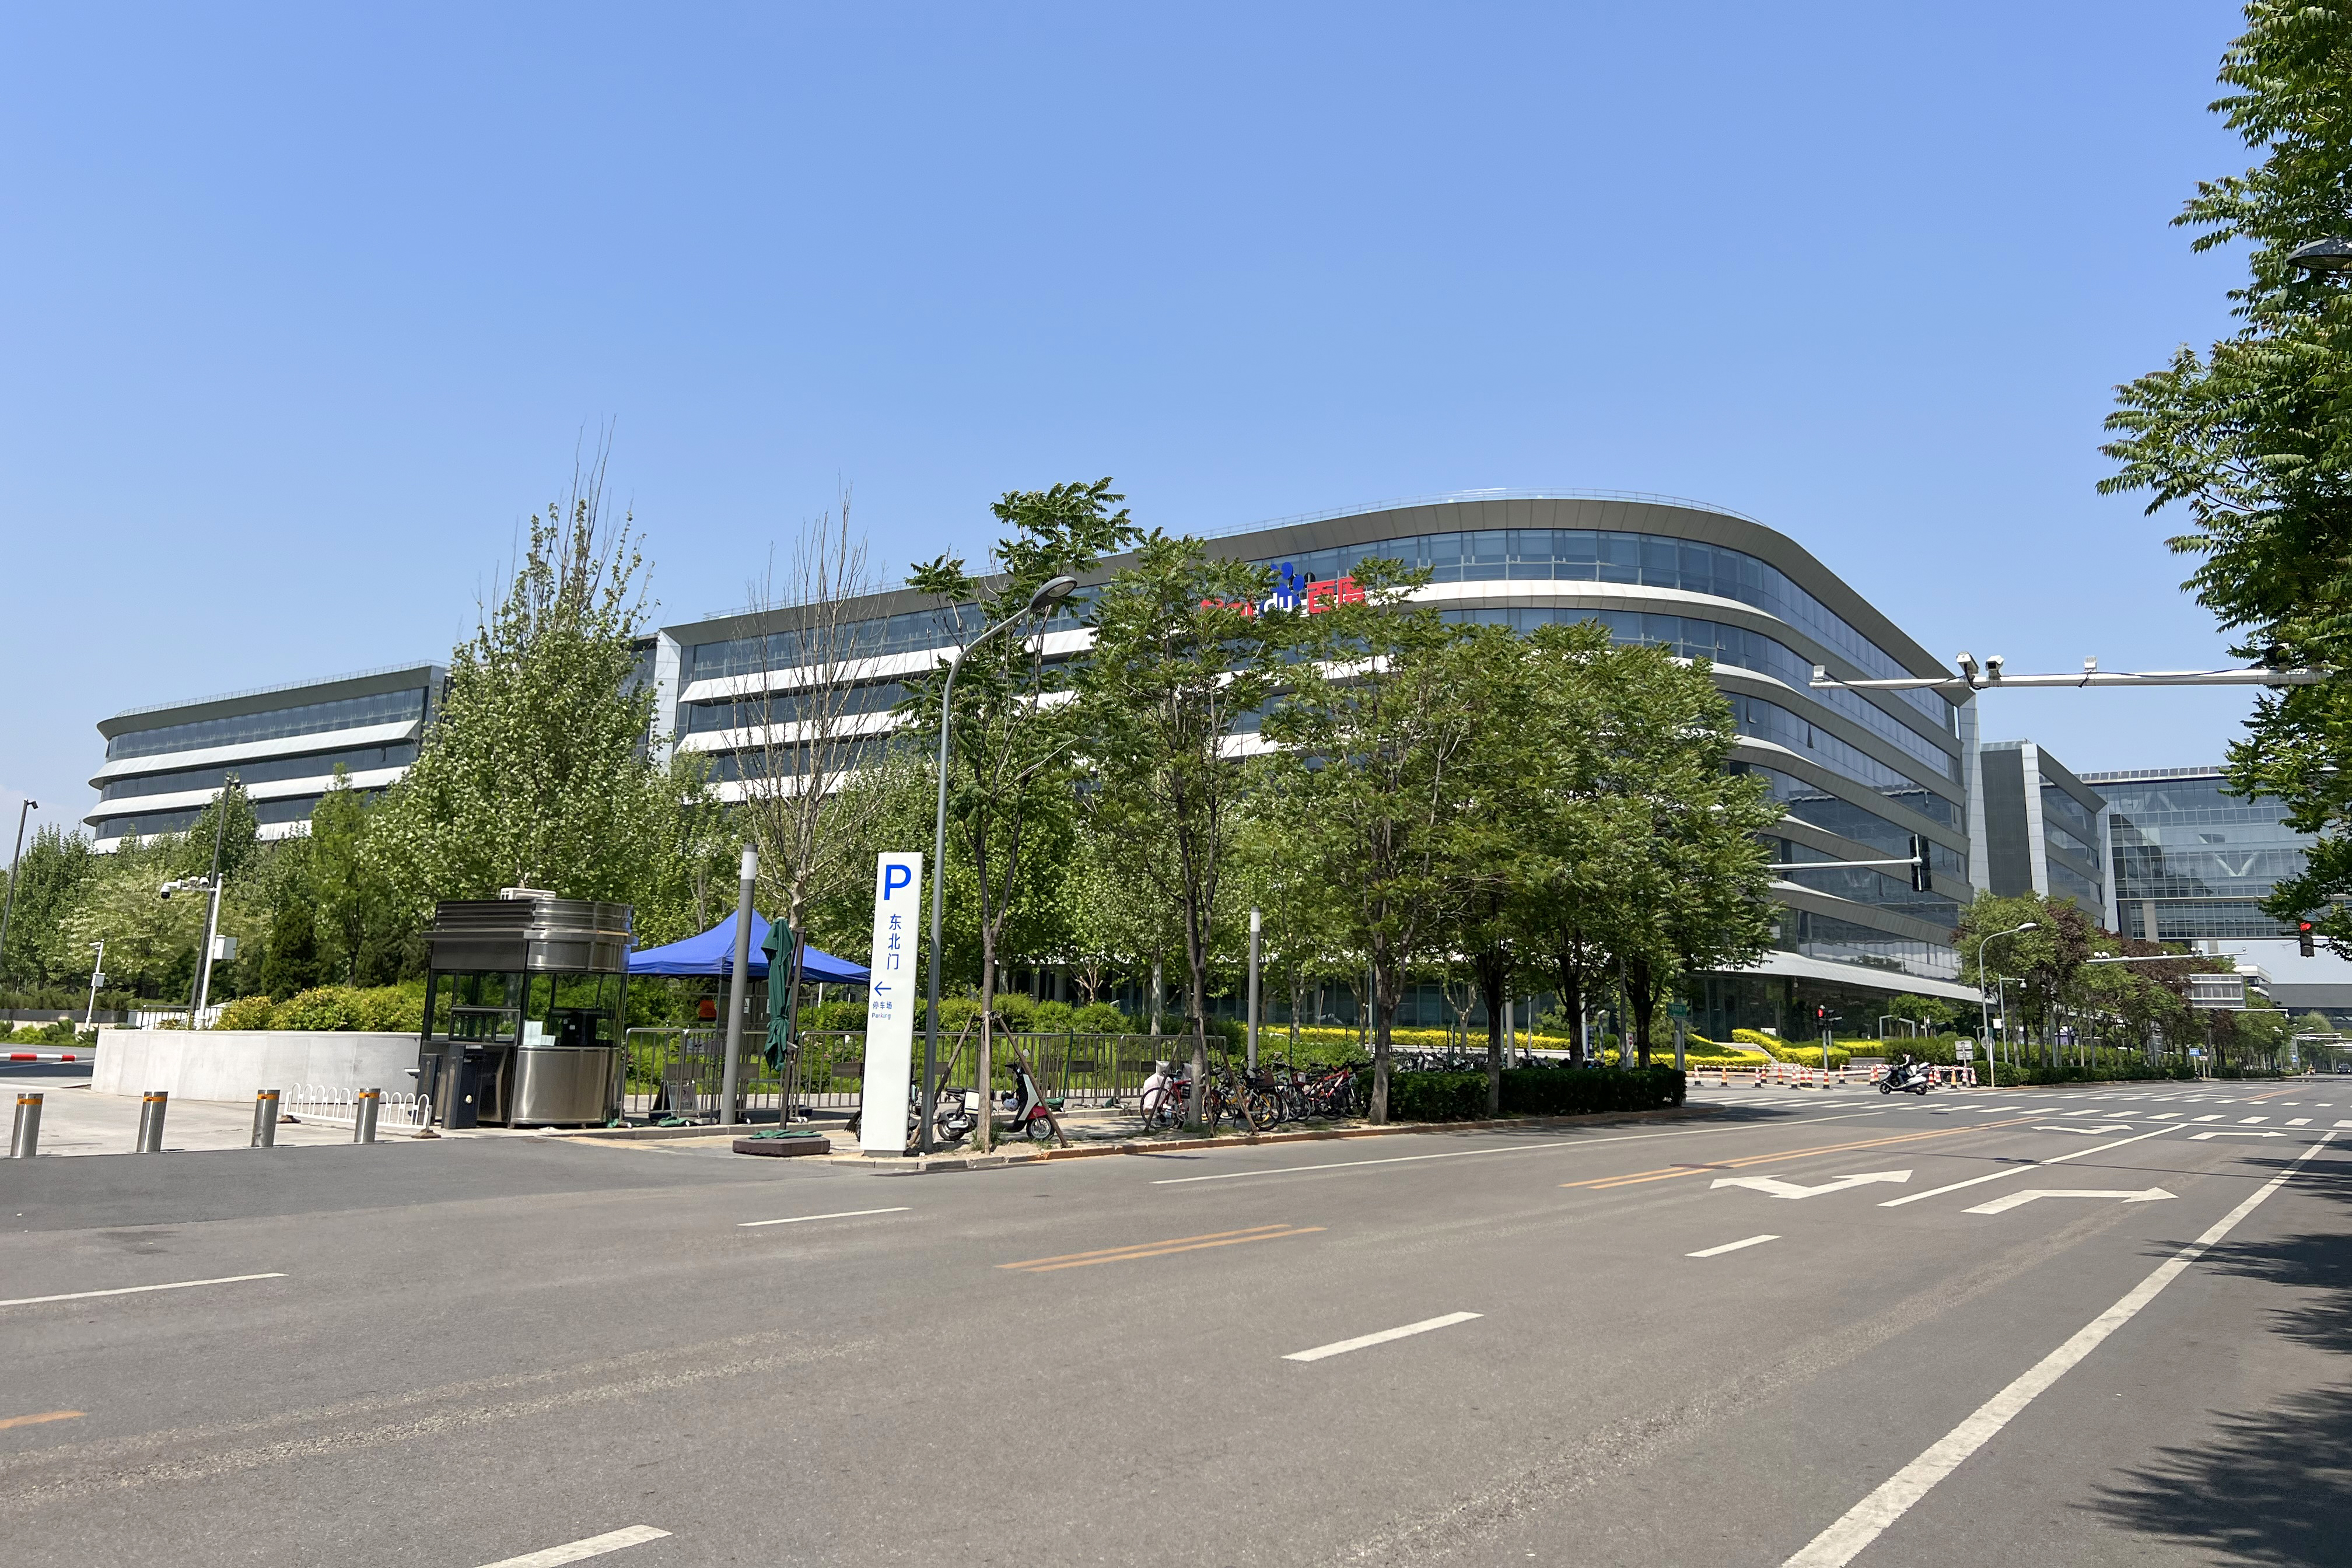
百度(Baidu)の研究チームは、文書、スプレッドシート、プレゼンテーションに関する100件の長工程タスクを、人間の作業時間、価格の代理指標、実行可能な検証ツールとともに公開した。最高性能モデルの平均スコアは17.91で、人間のベースラインである27.79を下回った。推論が安価かつ高速でも、成果物をそのまま利用できるとは限らないことを示している。

最新模型

AREX、研究エージェントに未解決の条件を反復検証させ、4Bモデルが圧縮状態で長期探索を維持

BAAIは深層調査を「検索—項目別検証—対象を絞った追加調査」という再帰的ループに再構成し、確認済みの証拠と未解決の制約をモデル自身が圧縮するよう訓練した。4BのDenseモデルと122B-A10BのMoEモデルの重みは公開されたが、その優位性は主に自動検証可能な合成タスクに由来しており、オープンエンドな科学研究へ直接一般化できるとは限らない。

硬體

ACE-RTLがNemotronにVerilogの反復コンパイルと修正を実行させ、9種類のタスクで平均合格率97.1%を達成

NVIDIAはNemotron 3 Ultraを「生成—テスト—リフレクション」のRTLエージェントループに統合し、CVDPの9種類のエージェントタスクで平均合格率97.1%を達成した。この結果は、実行可能な検証がチップ設計モデルを大幅に強化できることを示す一方、データの関連性、ツール設定、ベンダーによる自己評価が依然として結果の一般化を制約している。

最新模型

Poolside、Laguna S 2.1をオープン化:118B MoEで各tokenあたり有効化するパラメータはわずか8.5B

Laguna S 2.1は、sliding-window attention、attention gate、FP8 KV cacheによって長いコンテキストのコストを抑え、セルフホスト可能なエージェント型コーディングを主眼に据える。複数の精度の重みと完全な評価trajectoryが提供されている一方、100万tokenへの対応能力、性能比較、単一マシンでの実行可能性は、量子化形式と実行環境に大きく左右される。

推論系統

同一モデルがツール呼び出し予測器を兼任、Qwen 4Bの次ステップ的中率が17ポイント超向上

研究チームは、エージェントが推論中に自身の次のツール呼び出しを予測して先行実行する仕組みを開発し、外部ドラフトモデルを共有重みとKV cacheで置き換えた。共同強化学習により、2種類のQwen 4Bモデルの平均Hit@1はそれぞれ61.2と66.3に向上したが、論文では実際の並列デプロイにおけるエンドツーエンドの高速化はまだ定量化されていない。