最新模型
Sarvam 開放 Prism 決策模型權重,以單次前向運算輸出選項機率
Sarvam 於 11 月 3 日發布 Prism,將固定選項判斷改為一次前向運算,並開放 Apache 2.0 授權權重。官方公布單張 B200 的請求延遲中位數為 44 毫秒,但中文表現與實際服務負載仍須驗證。
Sarvam 於 11 月 3 日發布 Prism,這款基於 Sarvam 105B 的決策模型,接收情境、問題與預先定義的選項,直接輸出各選項機率。對客服分流、代理執行結果判定等工作,工程意義是省去逐 token 生成答案及後續解析的步驟;權重已採 Apache 2.0 授權公開。發布公告
Prism 以 LoRA 微調,並用小型評分頭產生機率。其注意力設計讓情境與問題區塊可雙向讀取,每個選項只能看見共用情境及自身,最後再於答案標記彙整比較。訓練結合帶有標籤平滑的交叉熵與 Brier 損失,目標是降低過度自信的錯誤;選項另按固定順序評分,減少輸入排列造成的變動。技術說明
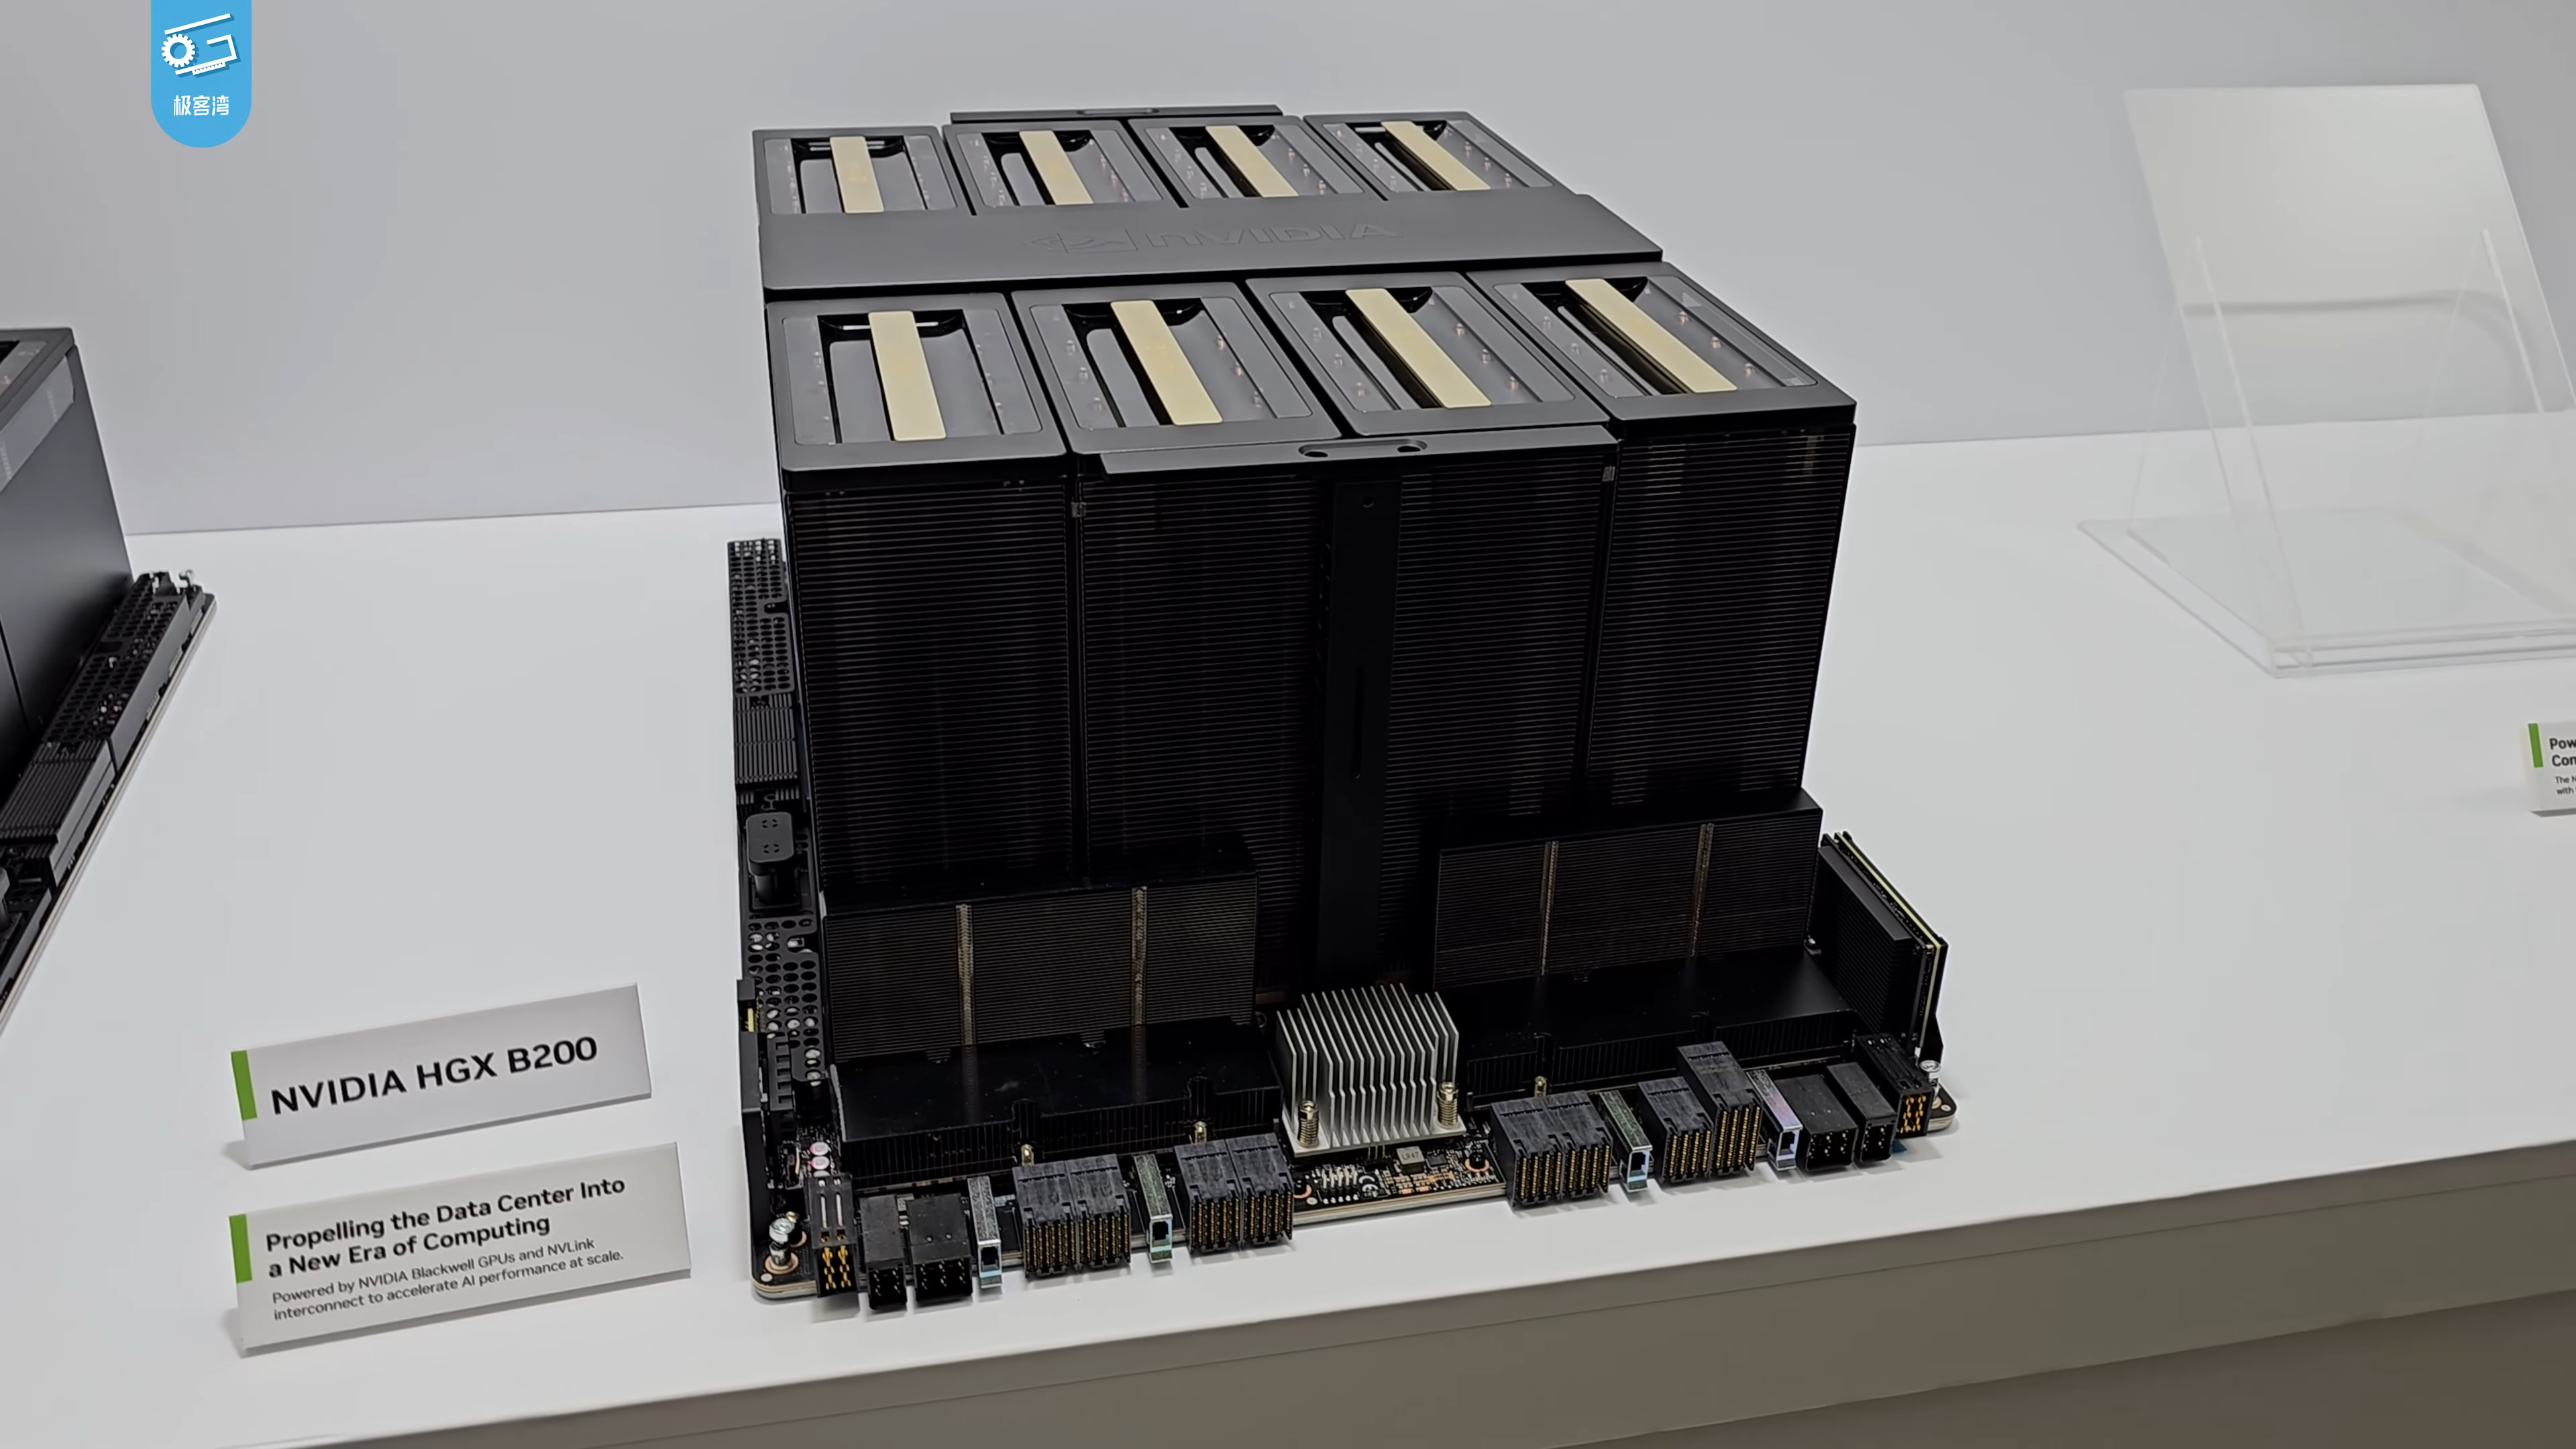
官方模型卡記載,單張 B200 在載入完成後,逐筆執行一千個公開 Decision Index 隨機請求,延遲中位數為 44 毫秒,第 95 百分位為 420 毫秒。兩者差距顯示,工程團隊仍須量測自身輸入長度與尾端延遲,不能將中位數當作服務保證。自架需要支援 FP8、約有 120 GB 可用記憶體的 NVIDIA GPU;權重使用自訂格式,須配合隨附推論程式,無法直接交由通用推論伺服器載入。模型卡
部署時還有上下文差異:公開模型卡列出每題 131,072 tokens,託管 API 文件則限制每題 32,768 tokens,採同步 JSON 回應。API 支援選一、是非與順序量表問題,適合把機率門檻接到自動處理或人工覆核流程;接入前應分別確認自架及雲端介面限制。API 文件
目前效能與校準結果主要來自開發團隊測試,部分比較採內部資料集或重建指標。官方列出的語言以英語及印度語言為主,尚不能推定繁體中文具備同等準確率。中文團隊下一步應以實際工單或代理軌跡,驗證選項措辭、信心門檻及資料分布改變後的誤判率,再決定可自動執行的範圍。評測方法、語言範圍