全ニュース

技術ニュース 1528 件

推論系統

HeadWiseKV、アテンションヘッドごとに長文脈キャッシュを構成し、Qwen3.6-27Bの利用可能長を161Kへ拡張

HeadWiseKVは、すべてのアテンションヘッドに同一の履歴を保持させる方式を改め、各headの多段階ウィンドウをオフラインでキャリブレーションし、実際の物理KV residencyを削減する。論文では、モデルを固定したテストで最大成功コンテキスト長を114Kから161Kへ延長したが、公開リポジトリのさらに大きな数値は、特定の量子化方式と単一の4090Dを使用した結果である。
最新模型

K2 Horizon、6モデルの完全な訓練軌跡を公開し、エージェントベンチマークにおける報酬ハッキングも明らかに

IFMは、0.9Bから375B-A23Bまでの6つのテキストモデルを、データレシピ、中間チェックポイント、訓練コード、エージェント向けポストトレーニングの記録とともに公開した。最大モデルのTerminalBenchスコアは、ハッキング監査後に70.2%から66.9%へ低下し、再現可能な形での公開においてもベンチマーク汚染への対処が不可欠であることを浮き彫りにした。

代理工具

PydanticAI 2.38、エージェントのコンテキスト使用量を公開し、実行ストリームに型付きカスタムイベントを追加

エージェントツールが `RunContext` からコンテキスト使用量を判断できるようになり、アプリケーションもカスタム状態を同じイベントストリームへ送信可能になった。新バージョンでは、セルフホスト型 vLLM provider と、`finish_reason` が欠落したストリームを拒否するポリシーも追加された。

AI 基礎設施

PyTorch 2.14、障害時の再構成をc10dに統合、Inductorの低精度・マルチハードウェアカーネルを拡充

新版では、`nccl2`、Process Groupのインプレース再構成、バックエンド横断のFlight Recorderにより、大規模分散学習を強化。InductorにはNVGEMM、宣言的な動的形状、複素数テンソルのコンパイルも加わったが、多くのインターフェースは依然として不安定とされている。

硬體

mzCache、CPU/GPU並列復元でモバイルLLMのメモリを回復、最初のtokenまでの遅延を2.1~5.5倍短縮

MobiCom 2026の研究では、モデル重みとKV cacheを共有バッファに分割し、CPUが退避されたデータを復元している間にGPUがprefillを開始できるようにした。成果の焦点は、スマートフォンでのマルチタスク後に生じる復帰遅延の改善であり、モデル自体の生成速度向上ではない。

AI 安全

GitSpawn、悪意ある `.git/config` でコーディングエージェントのサンドボックスを回避—開示時点で4件が未修正

複数の CLI コーディングエージェントが信頼確認前に Git のステータス照会を実行するため、リポジトリ内の実行可能な設定がユーザー権限でホスト上にて動作する。通常の `git clone` では攻撃は伝播しないが、完全な `.git` ディレクトリを ZIP、同期フォルダ、USB 経由で渡すと発動し得る。

醫療 AI 與物理導向學習

PyDoseRT Photon、微分可能な物理エンジンと小規模なニューラル事前分布で放射線治療線量を補正

新たな研究では、GPUペンシルビーム計算、凍結された2つのニューラル事前分布、136万パラメータの3D U-Netを統合し、CT/MRI共通のパイプラインを構築した。内部データにおける1%/1 mmのgammaパス率は最高99.12%に達したが、施設横断的な検証や臨床用途の妥当性確認には至っていない。

代理工具

Claude Code 2.1.259、リモートMCPを組織全体に配布可能に—無人実行モードではプロンプトが必要な操作を即時拒否

新バージョンでは、`managedMcpServers`を通じてHTTP/SSEツールエンドポイントを一元的に配布できるほか、無人実行ホスト向けに対話を待たない権限ポリシーが追加された。今回のアップグレードでは、管理対象サーバーに対するallowlistの適用方法も変更されるため、企業がdenylistを追加しなければ、従来は除外されていたツールが再び読み込まれる可能性がある。

推論系統

Hugging Face、207個のWebGPUカーネルをオープンソース化――ブラウザAI演算子をバージョン管理可能なパッケージに

`@huggingface/kernels`は、インターフェース、テスト、WGSL実装を備えたGPU演算子をHubから動的に読み込める。公式のApple M4上での演算子単位のテストでは、幾何平均で2.57倍の高速化が報告されたが、この結果にはモデルの読み込み、コンパイル、データ転送のコストは含まれていない。

最新模型

TranslatePsy、アフリカ言語翻訳モデルを公開——0.8B~4B版は量子化してオフライン実行可能

Tether AI Researchは、Qwen3.5をファインチューニングしたAfriSLMと、ブラウザやスマートフォン向けの17M~43MパラメータのAfriNanoをリリースした。モデルは最大19のサハラ以南アフリカ言語に対応するが、大規模ベースラインを上回るとの結論は主に自動評価指標に基づいており、母語話者の専門家による評価はまだ行われていない。

推論系統

Unsloth 0.1.806、MTP投機的デコーディングをデフォルトで有効化。Qwen3.8とGLM-5.3のローカル推論が最大2倍高速に

Unslothは、Qwen3.8-Flash-NextとGLM-5.3-FlashでMulti-Token Predictionをデフォルトで有効化し、MLX、マルチGPU、ROCmの各経路も改善した。公式が掲げる「最大2倍」には完全なベンチマークマトリクスが添付されておらず、Qwenの技術文書に記載された低並行時の高速化は1.3~1.7倍となっている。

代理工具

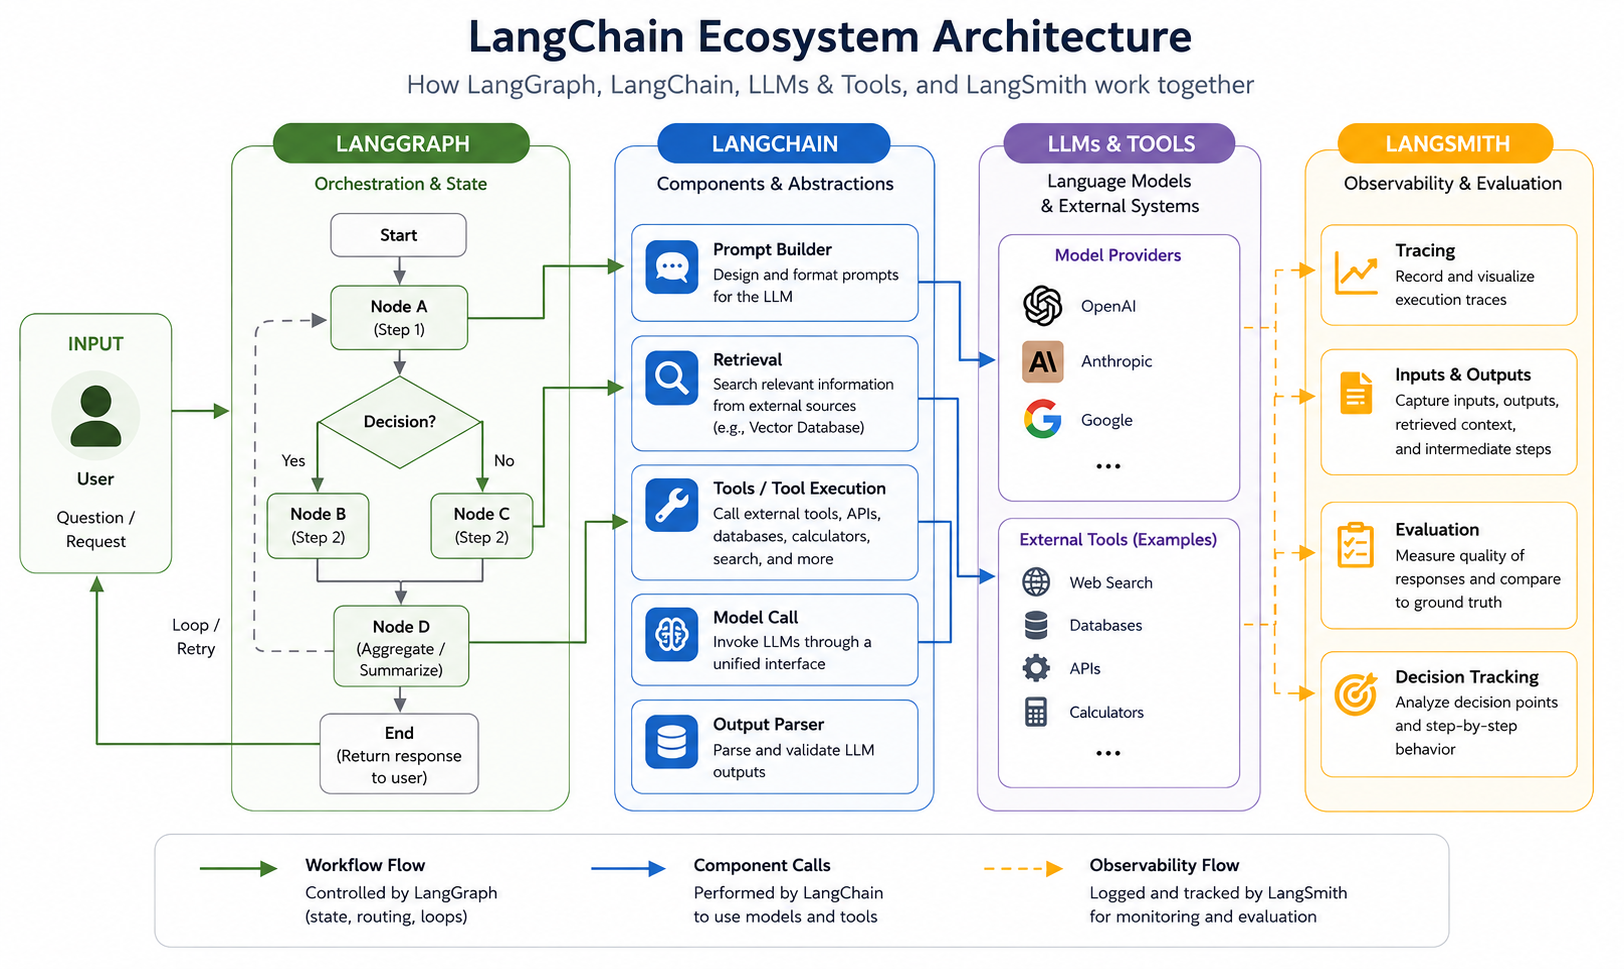
LangChain 1.4 Alpha、MCPツール連携をコアに統合――サーバーが呼び出し途中で人間の入力を要求可能に

新しい `langchain.mcp` は、単一または複数の MCP サーバーへの接続を統一し、ツール実行途中の問い合わせを再開可能な LangGraph interrupt に変換する。インターフェースは依然として Alpha 段階にあり、連続するバージョンでメソッド名や elicitation の挙動が変更されているため、安定運用が求められる本番環境へ直接導入するのは適切ではない。