 AI 研究
WISE、再帰型モデルのアテンション対象範囲を再利用し、アテンション処理で1.36倍の高速化を計測
すべての再帰ステップを維持しつつ、初期の探索で後続のアテンション計算の対象範囲を絞る手法。性能の数値はアテンションのワークロードのみを対象としており、4Kコンテキストでの品質低下と公開された再現用資料については、引き続き確認が必要だ。
Archive
技術ニュース 1515 件
AI 研究
すべての再帰ステップを維持しつつ、初期の探索で後続のアテンション計算の対象範囲を絞る手法。性能の数値はアテンションのワークロードのみを対象としており、4Kコンテキストでの品質低下と公開された再現用資料については、引き続き確認が必要だ。
 GitHub Repo
新版では、Responses APIのストリーミング中に明示的な失敗イベントをアプリケーション層へ伝達し、同期・非同期の両インターフェースにテストを追加した。終了イベントのない途切れたストリームについては別途検証が必要で、既存の例外処理やリトライ戦略も確認する必要がある。
 推論系統
単一のPallas呼び出しで92層をつなぎ、層をまたぐ重みのプリフェッチでメモリ帯域幅の利用率を向上。公式の比較は特定のトポロジーと小規模バッチに限られ、投機的デコーディングの性能はドラフトトークンの受理率にも左右される。
 GitHub Repo
新版ではIntelとApple Silicon向けのNode.js、uvを同梱し、起動時にアーキテクチャに応じて選択する。デスクトップ版は引き続き初期プレビュー段階にあり、エージェントの一連の処理とバックエンド設定は実環境での検証が必要だ。
 AI 基礎設施
BioNeMoがグループ化したエキスパート演算、エキスパート並列、MXFP8を組み合わせ、特定の訓練ワークロードのスループットを向上。最速構成では精度と並列化方式を同時に変更しており、性能向上は収束品質と併せて評価する必要がある。
 GitHub Repo
新たな推論パスはggmlのMetalカーネルを再利用し、Transformersの処理フロー内で量子化重みを実行できるようにする。現時点ではmainブランチからのインストールが必要で、対応モデル、バッチ処理、カーネルの互換性には制限が残る。
 GitHub Repo
新版では、プレーンテキスト生成が出力上限に達すると、まずコンテキストの空き容量の確保を試みてから再試行する。すでにツールの動作が発生したターンは、この仕組みでは再実行されない。実際の回復率は今後の測定を待つ。
 AI 研究
ラベルなしの英語音声を使った蒸留により、枝刈り後の認識性能を部分的に回復。速度測定で示された1.75倍にはバッチサイズ変更の効果も含まれ、同一バッチサイズでの効果と中国語の認識品質はそれぞれ評価する必要がある。
 AI 研究
話者ごとの音声トラックと共通のタイムラインを保持し、全二重の音声対話やターンテイキングの研究に活用できる。中国語部分の人手によるアノテーション時間は記載されておらず、自動文字起こしもそのまま学習用の正解データとして使うには適さない。
 硬體
モバイルゲーム向けの超解像とフレーム生成のインターフェースを提供し、ネイティブ統合ドキュメントも公開。初版のフレーム生成では、実際にレンダリングされる1フレームの時間分だけ入力遅延が増えるため、効果は消費電力や画質と併せて評価する必要がある。
 GitHub Repo
新版は依存パッケージを更新し、TLS証明書検証とプロセスプールのブロッキングに関するリスクに対処。デフォルトのイメージには未解決の脆弱性が残っており、実際の影響は実行経路に応じて判断する必要がある。
 推論系統
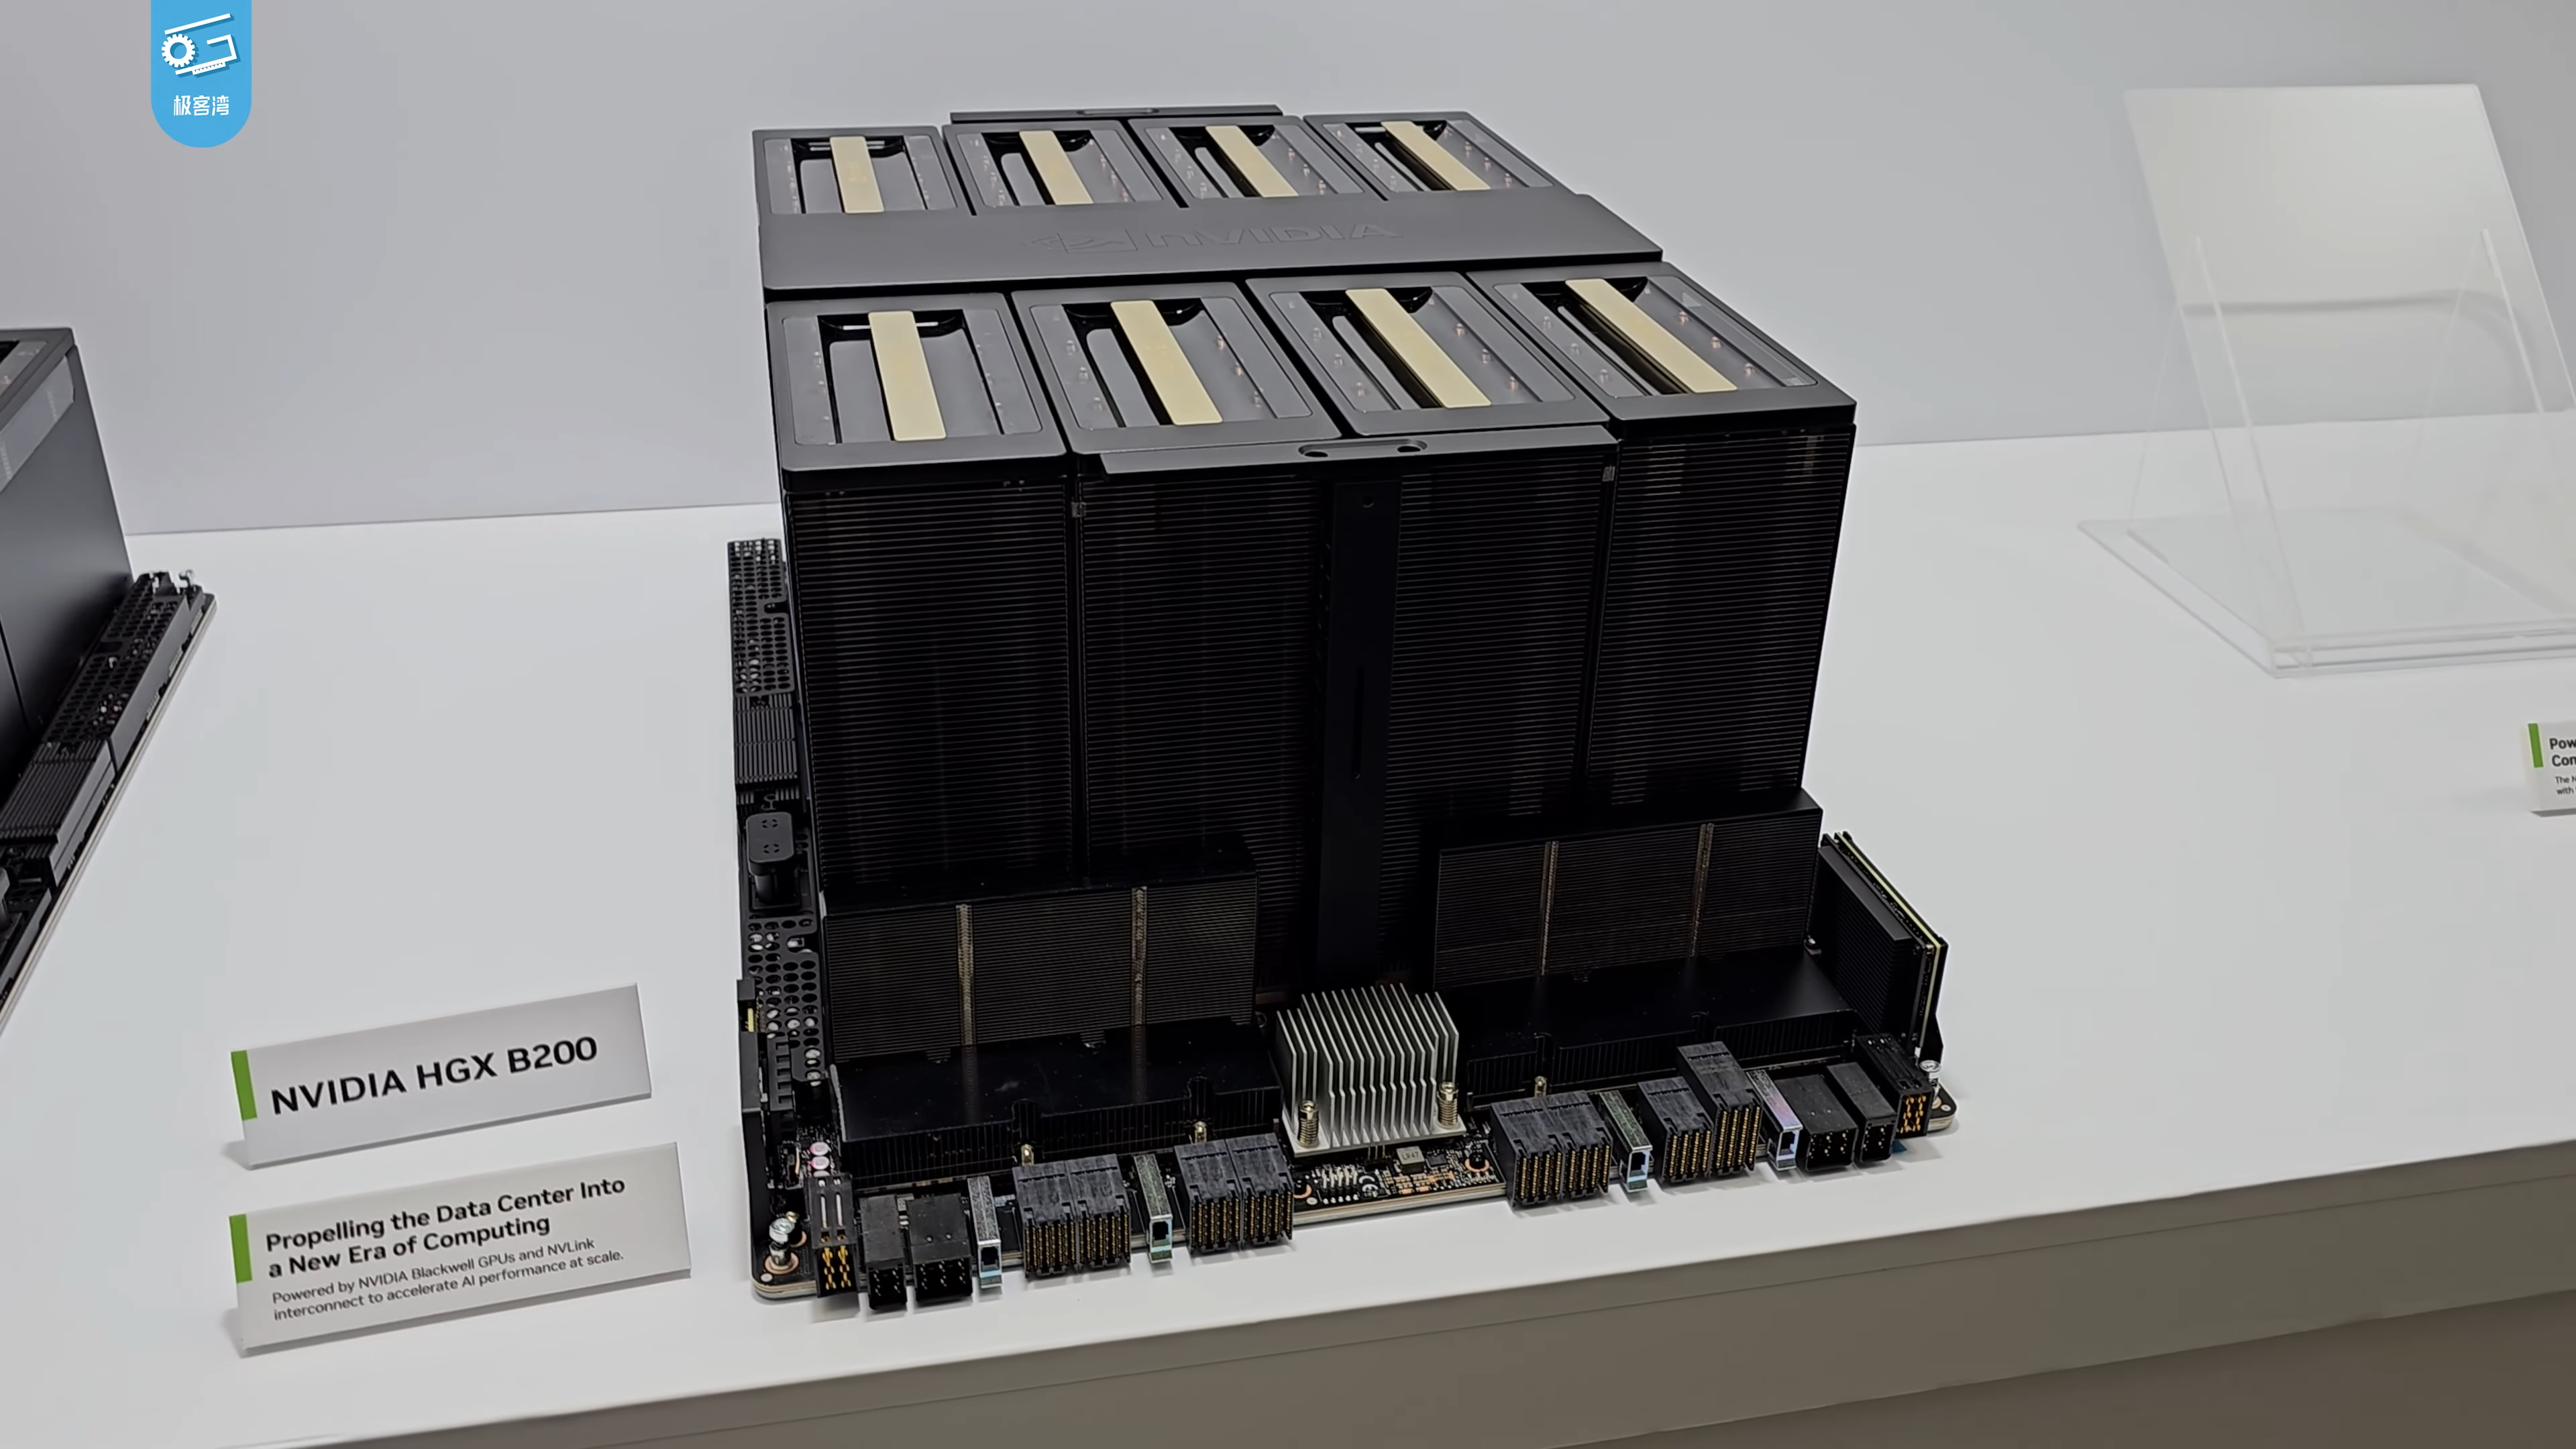
B200を8基使用してDeepSeek-R1を実行したテストでは、コンフィデンシャルコンピューティングによる1トークン当たりの平均レイテンシーの増加率は5%未満だった。この結果はメモリ転送、カーネルの時間計測、GPU間通信の調整に依存しており、実際のサービスのワークロードに即した再検証が必要だ。