 推論系統
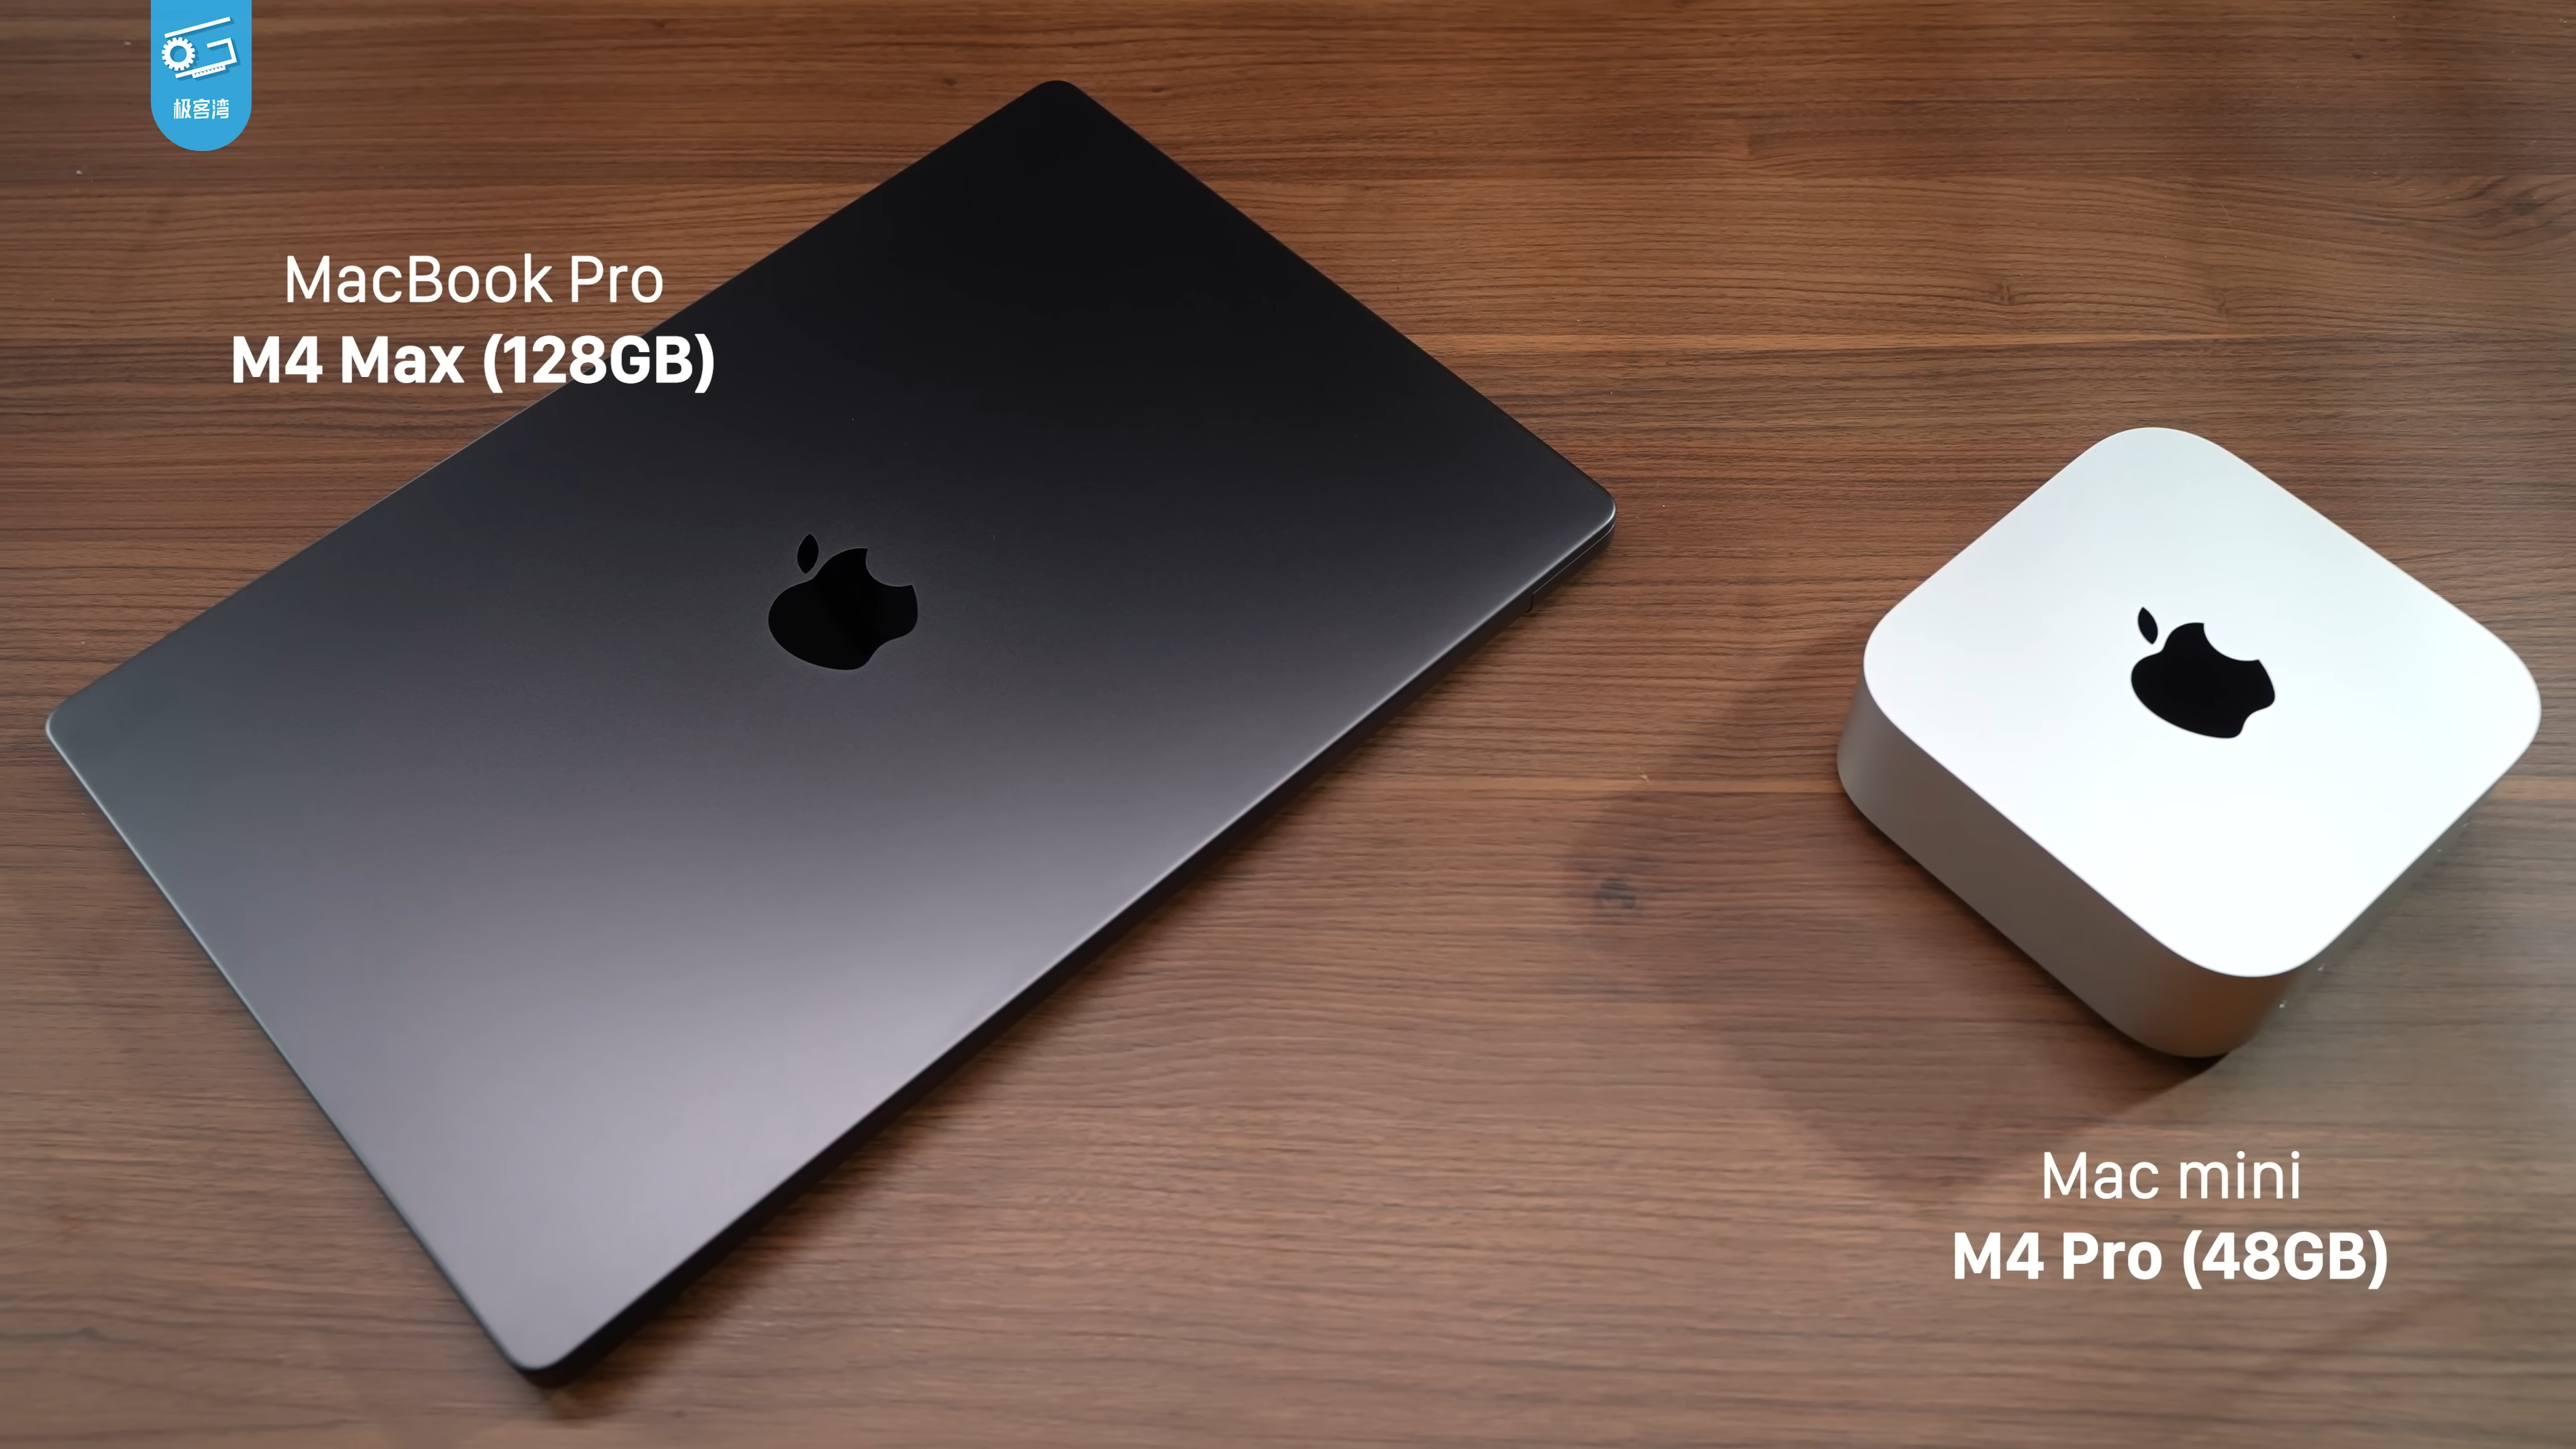
M4 MaxのローカルLLM実測:デコードはGB10より高速、ただし応答全体は依然としてprefillが制約
同価格帯のローカルAIプラットフォームを比較した最新テストでは、546GB/sのユニファイドメモリ帯域幅を備えるM4 Maxが、3種類の量子化モデルにおけるtoken単位のデコードでGB10とStrix Haloを上回った。一方、prompt prefillと総合的な電力効率ではGB10が依然優位であり、tokens/sだけを見ると実際の応答時間を見誤る可能性がある。