 代理工具
Echoverse、進化可能なアプリでコンピューターエージェントを訓練――9Bモデルのテスト横断成功率が67.1%に向上
Microsoft Researchのチームは、静的なWebページを増やし続けるのではなく、エージェントの失敗軌跡に基づいて合成アプリケーション、タスク、評価器を連動して修正する。9Bモデルは14の評価セットにおける平均成功率を36.5%から67.1%へ伸ばしたが、現時点でベンチマークとして公開されている環境は4つのみだ。
Archive
技術ニュース 1541 件
代理工具
Microsoft Researchのチームは、静的なWebページを増やし続けるのではなく、エージェントの失敗軌跡に基づいて合成アプリケーション、タスク、評価器を連動して修正する。9Bモデルは14の評価セットにおける平均成功率を36.5%から67.1%へ伸ばしたが、現時点でベンチマークとして公開されている環境は4つのみだ。
 代理工具
AlibabaのQwenチームは、スマートフォン、デスクトップ、Web、DeepSearchを横断するGUIエージェントの技術レポートを公開した。単一のアクション空間で画面操作、CLIコマンド、バッチアクションを組み合わせる。複数の自己申告ベンチマークで既存システムを上回ったとしているが、モデルの重み、訓練データ、完全な実行フレームワークはまだ同時公開されていない。
 代理工具
OSRewardは、Web、Windows、Ubuntu、モバイルプラットフォームにまたがる1,019件の人手でアノテーションされた軌跡を用い、視覚言語モデルがコンピュータエージェントのタスク完了を正しく判定できるかを検証した。チームは推論過程を含む10万件の判定データも公開し、セルフホスト可能な9Bおよび35BのOS-Shepherd報酬モデルを学習した。
 最新模型
NVIDIAはCosmos 3 Edgeの重みと推論パイプラインを公開した。4BのMixture-of-Transformersに自己回帰推論と拡散ベースのマルチモーダル生成を組み合わせ、テキスト、画像、動作軌跡を入力できる。DROIDデータでファインチューニングしたロボットポリシー版も提供するが、物理的一貫性とエッジデバイスでのレイテンシーについては、独立した検証がなお必要だ。
AISPA 把系統提示拆成八項使用者保障維度,並分析 88 款商用 AI 產品中的 3,249 條指令。雖然 98.9% 的產品至少包含一項保護性規則,完整覆蓋八個面向的比例只有 24%。
 推論系統
WIDEは動的プルーニングをトークン単位のAttentionヘッドグループとFFNチャネルグループにまで細分化し、prefillとdecodeの両方をサポートする。研究では、スパース率50%でコア層のデコードが最大4.95倍高速化した一方、エンドツーエンドの高速化は1.55倍に縮小したと報告している。
 AI 安全
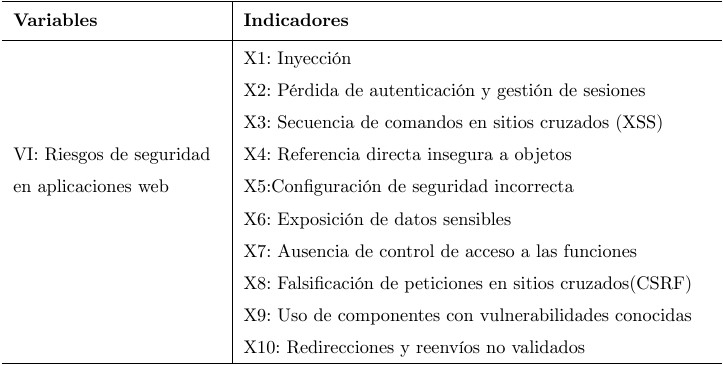
OWASPの「Agentic Skills Top 10」v1ドラフトが公開レビューを終え、悪意あるスキル、過剰な権限、依存関係の混同、クロスプラットフォーム移植のリスクを10種類の管理項目に整理した。このフレームワークは、スキルをモデルとMCPツールの間に位置する振る舞いのレイヤーとして捉え、権限、出所、完全性を宣言できる共通フォーマットを提案している。
 最新模型
VIDRAFTはPOCKETシリーズの重みを公開し、35Bモデルを最小8.2 GBまで量子化しつつ、各tokenで有効化されるパラメータを約3Bに維持した。モデルはアップストリームのllama.cppをそのまま利用できるが、圧縮手法は公開されておらず、性能と品質を示す根拠も現時点では主に開発チームによるものだ。
 AI 安全
GoogleはNano Banana 2を実在の地理画像に統合したが、ユーザーはすぐに爆発や空爆など架空の場面を生成し、そのスクリーンショットを拡散した。同社は翌日、この機能を撤回した。生成結果にはウォーターマークが付与され、共有地図にも書き込まれないものの、今回の事例は、出所表示だけでは入力制限やインターフェースの分離の代わりにならないことを示している。
 最新模型
HuaweiのopenPanguチームは、Ascend NPUで学習した505BのMixture-of-Expertsモデルをリリースした。各tokenで約18Bパラメータをアクティブ化する。階層型疎注意機構と3ヘッドのMulti-Token Predictionを導入しているが、性能値は現時点で主にチームによる自己評価に基づく。
 科學機器學習
UNICONは、河川、交通、電力網、気象、人流などのデータを共通のグラフ系列インターフェースに変換し、少数の数値例を通じてコンテキスト内で新たなタスクを指定する。学習に含まれていないWebトラフィックなどの分野でも専用モデルに迫るが、現時点で検証されているのは予測タスクのみで、重みとコードも公開されていない。
 AI 安全
新たな研究は、限られた人的予算でエージェント群の監査をシミュレーションし、自己申告信頼度の歪みによってランキング戦略がランダム抽出を下回る臨界点を特定した。5つの小・中規模オープンウェイトモデルでは、2つのベンチマークにおける信頼度のAUROCが約0.5にとどまったが、この結論は単一のプロンプトと直接回答という設定に基づく。