 AI 安全
JailbreakSkill 將越獄策略封裝成可進化技能,HarmBench ASR 再增 13.4 個百分點
JailbreakSkill 以統一介面封裝提示改寫、失敗分析及技能演化,讓紅隊代理從未成功的攻擊軌跡產生新程序。第二階段令 AdvBench 與 HarmBench 的跨模型平均攻擊成功率分別再升 17.5 及 13.4 個百分點,但評分依賴 GPT-4o 裁判。
Archive
模型安全、資安、隱私、供應鏈、紅隊與防護。
AI 安全
JailbreakSkill 以統一介面封裝提示改寫、失敗分析及技能演化,讓紅隊代理從未成功的攻擊軌跡產生新程序。第二階段令 AdvBench 與 HarmBench 的跨模型平均攻擊成功率分別再升 17.5 及 13.4 個百分點,但評分依賴 GPT-4o 裁判。
 代理工具
英國 AI Security Institute 開源 optstop,按題目與任務層級的後驗不確定性決定何時停止重複評測。九組影子測試平均省下 81.1% 試驗,但效果依評分型態、題目排序及交換性假設而變。
 AI 安全
Anthropic 說明支援的新 Claude 模型會在文字生成過程嵌入不可見訊號,產生的檔案則可加入簽章式來源資料。官方同時警告,短文、改寫與翻譯會削弱偵測,找不到訊號也不能排除內容曾由 Claude 生成。
 最新模型
GCache 不再只比較相鄰去噪步驟的局部差異,而是估算快取誤差對最終影像或影片的累積影響。它以動態規劃選擇快取刷新點,再用 Bayesian optimization 讓理論權重對齊實際生成品質。
 AI 安全
新版可用 Linux memory cgroup 為代理執行的編譯與測試設定記憶體上限,避免失控程序拖垮整個工作階段。它亦修正 Windows 特殊路徑繞過驗證、MCP 重連迴圈及沙箱閒置佔滿單核等問題。
 代理工具
StateBridge 將發送代理的末層 hidden state 對齊接收端 embedding 空間,作為連續前綴直接注入。四款開放模型的26組測試中有22組並列或取得最佳結果,但方法仍限於可存取內部狀態的同模型代理。
 AI 安全
新開源協定讓代理為記憶、身份與行動建立Ed25519簽章及可見證的追加式紀錄,並提供零依賴離線驗證器。它把持久記憶投毒轉成可偵測的完整性問題,但仍不能證明記憶最初為真,亦尚未成為IETF標準。
 AI 安全
SkillMisevo-Bench 追蹤代理如何從執行軌跡產生、檢索並重用技能,發現所有 21 組具進化能力的設定都曾寫出不安全產物。SafeEvolve 可降低後續傷害,但證據目前限於四款 CLI 代理與受控電腦操作任務。
 最新模型
Z.ai 表示 GLM-5.3 未重新預訓練,程式與資安能力提升均來自更大規模的後訓練。模型在 CyberGym 報告 84.5%成功率,但權重須待雙重用途風險評估完成才會釋出。
 AI 安全
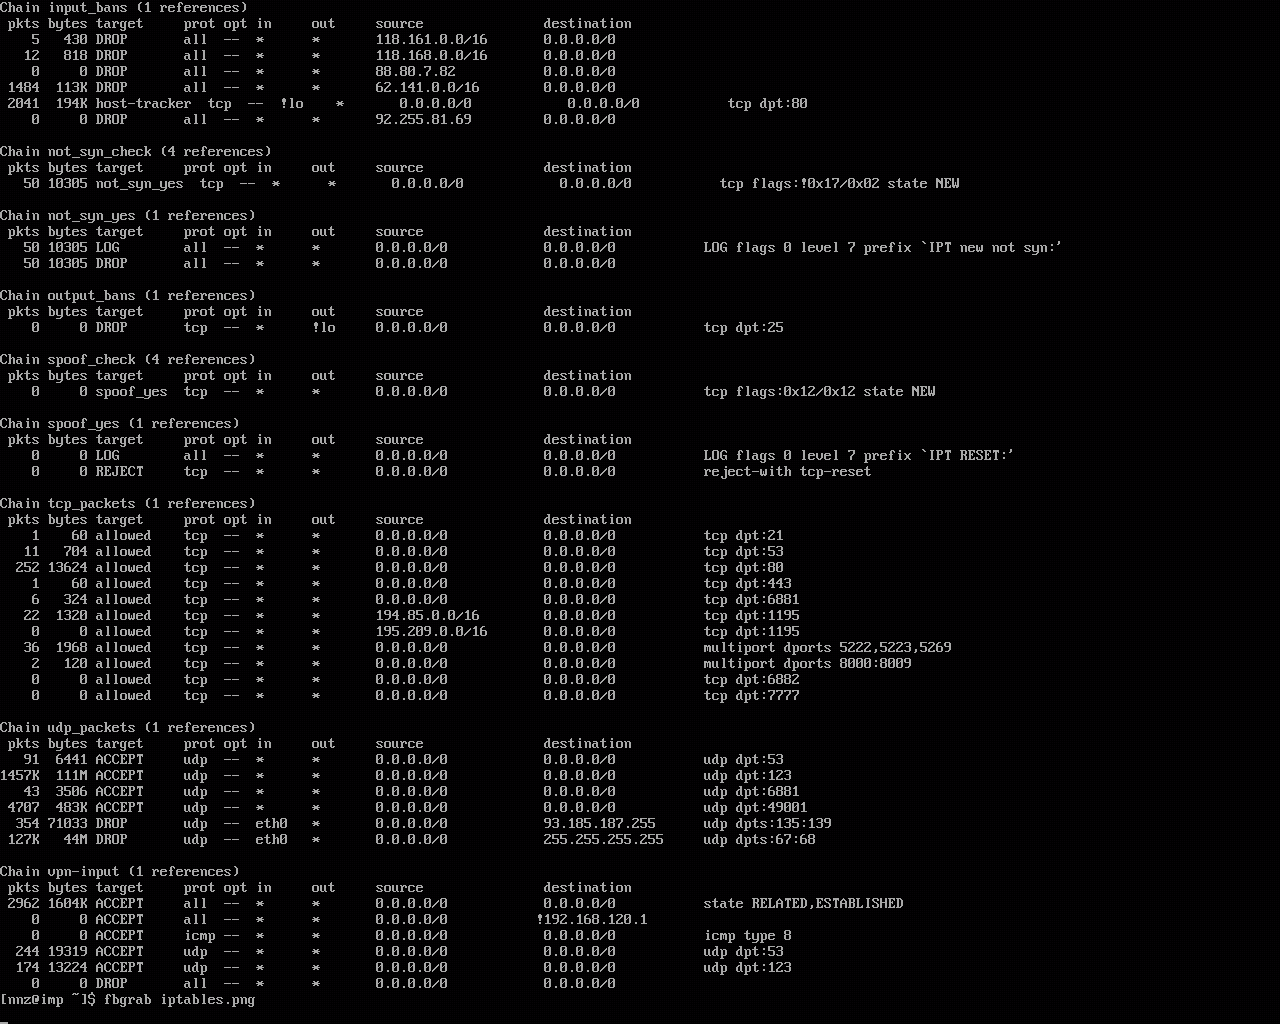
TopoIntent 以結構化 schema、架構檢索及合規檢查,把模糊需求轉成 Mininet 與 iptables 測試環境。留出測試顯示自動修補可補齊拓撲層控制,但資料集只有 14 組未見樣本。
 AI 安全
Synthetic Persona Pretraining 把依據「價值憲章」生成的第一人稱反思寫入約 10% 預訓練文件,再以後訓練把該人格綁定至助理身份。新公開的完整實驗、權重與資料顯示,提早介入主要改善價值泛化,抵抗一般 jailbreak 則未必需要從零開始。
 AI 安全
RAGSieve 不需要可信語料庫或預先標註的毒化樣本,而是分別比較查詢排名尾端與文件的局部語意鄰域。開源實驗涵蓋三個問答集、三款檢索器及六種攻擊,但單篇流暢毒文與已污染的檢索尾端仍可能繞過偵測。