 AI 安全
AgentJail 1.7 將代理權限改為工作階段綁定的單次 grant,主機連接器預設拒絕轉送
AgentJail 1.7.0 以具型別的生命週期管理檔案、命令、網路、MCP 與憑證權限,授權須完成啟用及稽核後才能使用。新版同時建立受信任主機連接器,但正式 MCP 轉送仍維持 fail-closed,避免尚未綁定原生批准證據便開放資料路徑。
Archive
模型安全、資安、隱私、供應鏈、紅隊與防護。
AI 安全
AgentJail 1.7.0 以具型別的生命週期管理檔案、命令、網路、MCP 與憑證權限,授權須完成啟用及稽核後才能使用。新版同時建立受信任主機連接器,但正式 MCP 轉送仍維持 fail-closed,避免尚未綁定原生批准證據便開放資料路徑。
 代理工具
Reasonix 1.34.0 讓 CLI 與桌面端處理 MCP 多輪互動及 Apps,嵌入內容改由沙箱環境呈現。新版也封堵六項 `serve` 與 Git 安全缺口,並為能力調用加入平行排程、審查預算及量測指標。
 AI 安全
Cornell Tech 研究者把原供推測解碼使用的 MTP/Eagle3 模組改造成序列分類器,毋須重跑主模型。方法只訓練約 1.6 萬至 2 萬個參數,但效能取決於草稿頭品質及數千筆任務標註。
 代理工具
DeepSeek Harness 新版讓主代理在授權範圍內替子代理選擇供應商、模型、推理力度與輸出上限,並完成 ACP 的會話、MCP、權限及取消介面。版本亦擴大網路與外部模型整合,但官方明確警告其沙箱和審批尚不能視為安全隔離。
 AI 安全
Fetchgate 對官方 Registry 的 15,329 個遠端網址執行唯讀握手,發現 5,462 個可連線端點會送出伺服器級指令。問題不只在提示注入,也包括每輪重複支付的上下文成本與工具間的隱性優先權競爭。
 最新模型
Z.ai 已公開 GLM-5.3 的 FP8 權重,結束因攻擊能力升高而設下的兩週安全緩衝期。模型可由 vLLM、SGLang 等框架部署,但大型 MaaS 業者另受安全審查條款約束。
 代理工具
Lemmalog 將代理記憶拆成由 LLM 擷取的事實,以及由規則引擎維護的可驗證狀態。初步評測顯示它能大幅縮短回答階段的上下文,但整體準確率仍受事實擷取與實體對齊限制。
 AI 安全
NVIDIA 在 0.0.113 強化本地推論與狀態漂移驗證後,再把沙箱、推論服務及生命週期權限綁定至可持久驗證的身分,避免重試或復原操作接管同名但不同的執行環境。
 AI 安全
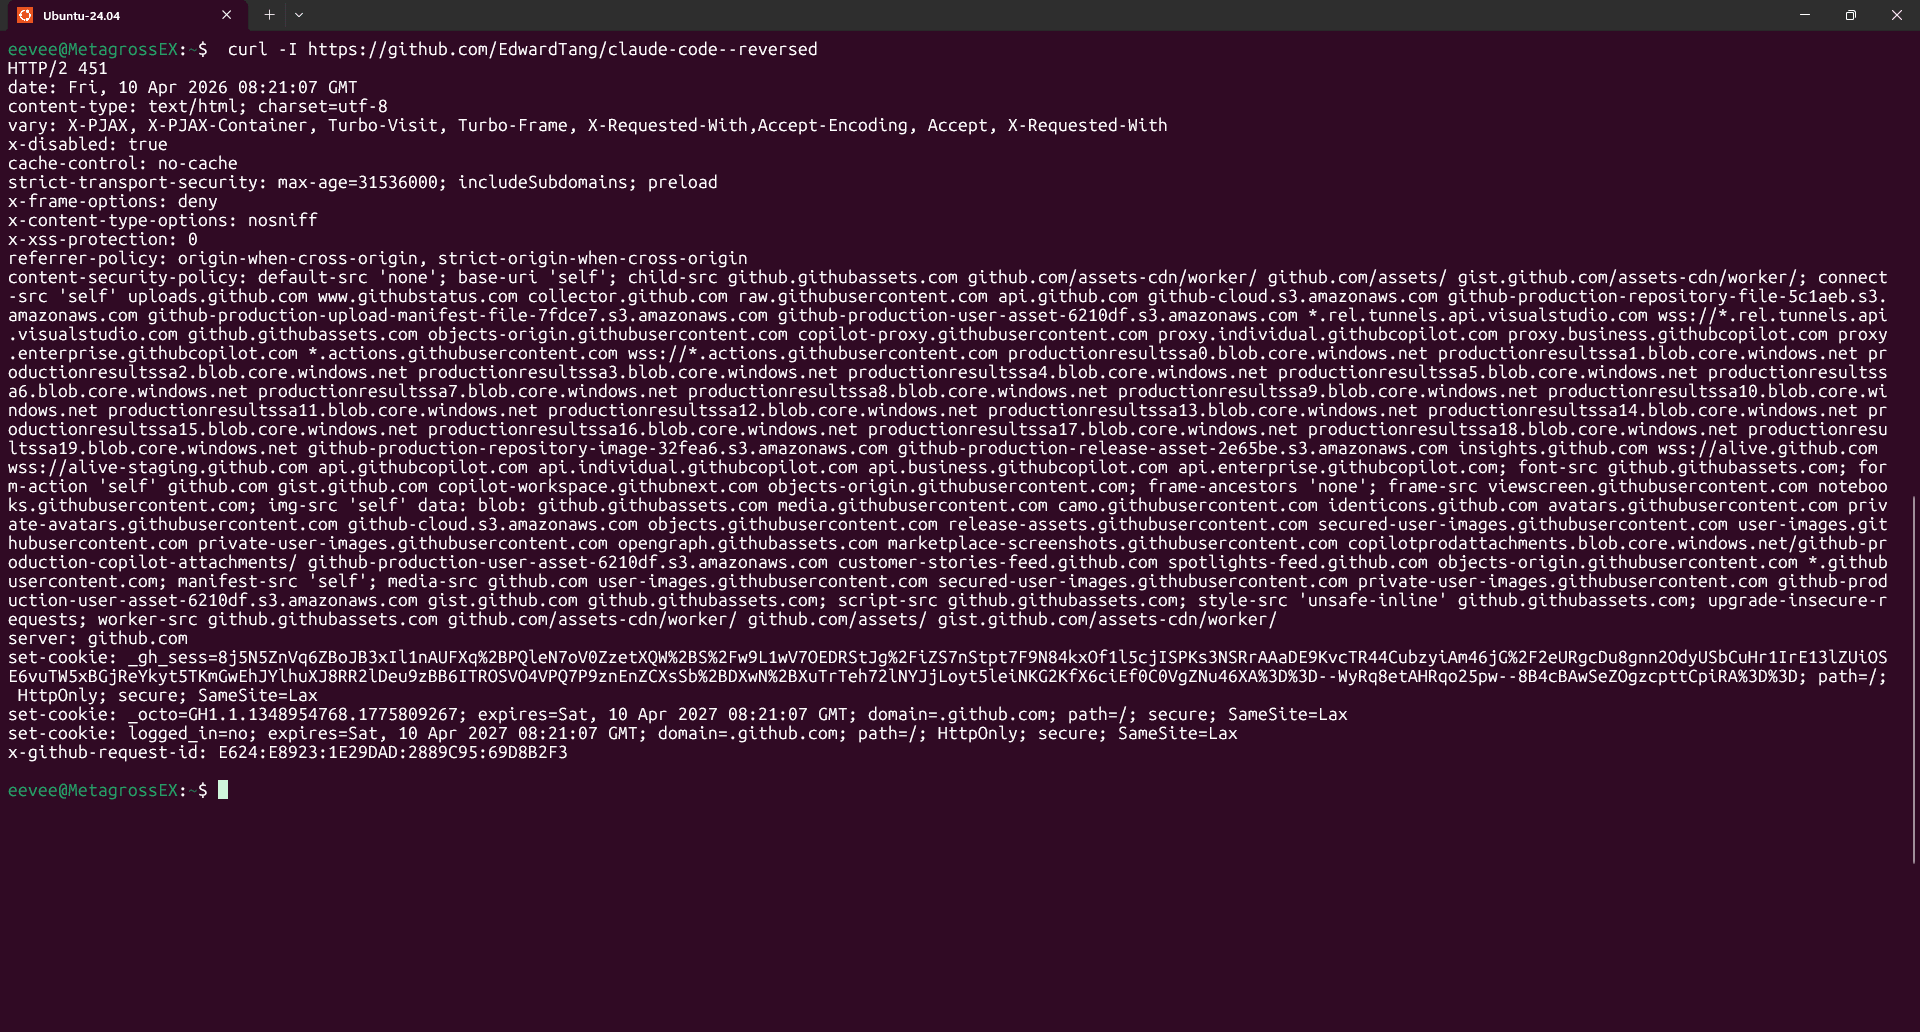
研究人員利用 Python 模組遮蔽,令 Claude Code 自行撰寫的安全解碼器載入惡意 `struct.py`,最終取得遠端程式碼執行。案例顯示逐次工具分類器無法取代作業系統隔離,官方評測的零成功率也不能外推至未見攻擊鏈。
 代理工具
Model Hardware Standard 將儀器能力、自然語言說明及安全限制封裝成可探索的驅動介面,代理可透過 MCP、CLI 或 API 協調多台設備。它目前仍是申請制研究預覽,規格、程式碼與跨模型安全評測尚未公開。
 代理工具
Cursor 不再要求先連接既有 GitHub 等原始碼庫,代理可直接建立專案並透過瀏覽器操作即時環境。新流程縮短原型到部署的距離,也擴大了雲端執行、網路暴露與供應鏈權限的稽核範圍。
 最新模型
CLAP 先以潛在動作從無標註影片學習物理規律,再把表徵接回機器人末端執行器座標。研究團隊已開放程式碼與多種 checkpoint,但生成影片的物理幻覺仍限制其直接參與安全關鍵控制。