AI 安全

模型安全、資安、隱私、供應鏈、紅隊與防護。

最新模型

Gemini 3.8 Flash、長期稼働型コーディングエージェントを強化—ただし移行にはサンプリングと思考パラメータの調整が必要

GoogleはGemini 3.8 Flashを正式に本番提供し、100万tokenのコンテキスト、3段階の思考強度、組み込みツールを提供するとともに、Antigravityマネージドエージェントのデフォルトモデルに設定した。コーディング評価は向上したものの、数値の大半は依然としてGoogle提供であり、モデルカードでは非英語圏の安全性評価が相対的に低下したことも明らかになった。
AI 安全

Cloudflare、コードの脆弱性をリアルタイムトラフィックと照合し、マルチエージェントのワークフローでパッチとWAFルールを生成

Cloudflareの早期プレビューサービスは、ソースコード解析の結果を実際のルーティング、トラフィック、WAFの状態、攻撃イベントと組み合わせ、GPT-5.6 Cyberで脆弱性と修正案を検証する。モデルが環境を直接変更することはないが、データは推論のためOpenAIに送信される。また、公式には誤検知率や修正成功率がまだ公表されていない。

電腦視覺

Scal3R、多参照フレームへの姿勢クエリで長時間動画の3D再構成ドリフトを補正、追加学習パラメータは約1%のみ

Scal3RはCUT3RまたはSTream3Rのバックボーンを凍結したまま、軽量なクエリトークンを使って複数の過去キーフレームに対する相対姿勢を推定し、オンライン姿勢グラフ最適化に渡す。著者らはKITTIにおいて、平均ATEが最も強力なオンライン競合手法を60%以上下回ったと報告している。ただし、結果はSim(3)アライメント後の値であり、実スケールが保持されていると直接解釈することはできない。

AI 安全

Perplexityの引用監査、関連する3サイトが21万件超のソフトウェアランキングページを生成していたと判明

研究者はSonarへの760回のクエリから7,534件の引用を収集し、ロングテールサイトがレコメンデーションシステムの検索証拠に大量に入り込んでいることを突き止めた。同一運営者が関与している疑いのある3サイトが占める引用は2.4%にすぎず、これらのページが実際に推薦結果を変えたことも研究では証明されていない。

AI 安全

Shannon 3.0、並列エージェント型SASTと実環境での脆弱性悪用により、検証済みの発見事項でCIを直接ブロック

オープンソースのAIペネトレーションテストツール「Shannon 3.0」に、多段階コード分析、脆弱性候補の調整、ネイティブSARIF対応が追加された。新バージョンでは、再現に成功した脆弱性だけがパイプラインのゲートを作動させる一方、実際に対象の状態を変更する可能性があり、2.xのワークスペースからは再開できない。

最新模型

GPT-6 Astraが正式提供開始、Codexは検索可能な過去のコンテキストで長期タスクを継続

OpenAIはAstraをAPI、AWS、ChatGPTの有料プランで提供し、Codexではノートと履歴検索を用いてコンテキストウィンドウをまたぐ仕組みを実験している。モデルのエージェント能力とサイバーセキュリティ能力は大幅に向上した一方、思考の連鎖(Chain of Thought)は監視を回避しやすくなり、デプロイ環境が正当な作業を中止する可能性もある。

AI 安全

GitHub Copilot、コンテンツ除外ポリシーをAppとCLIに拡大。ただしシンボリックリンクや間接的なセマンティクスは依然として境界を越える可能性

Copilot BusinessおよびEnterpriseの管理者が設定した除外ルールにより、Copilot AppとCLIが指定ファイルをモデルのコンテキストへ直接追加することを防げるようになった。ただし、この仕組みは完全なデータ漏えい防止策でも実行サンドボックスでもなく、GitHubはシンボリックリンク、リモートファイルシステム、IDE経由の間接的なセマンティクスなどの抜け穴を明示している。

AI 安全

GitSpawn、悪意ある `.git/config` でコーディングエージェントのサンドボックスを回避—開示時点で4件が未修正

複数の CLI コーディングエージェントが信頼確認前に Git のステータス照会を実行するため、リポジトリ内の実行可能な設定がユーザー権限でホスト上にて動作する。通常の `git clone` では攻撃は伝播しないが、完全な `.git` ディレクトリを ZIP、同期フォルダ、USB 経由で渡すと発動し得る。

最新模型

Muse Spark 1.3、エージェントのツール呼び出しを削減――最高推論モードは安全性テスト待ち

MetaはMuse Sparkを更新し、長期的に動作するエージェント、ソフトウェア開発、複数の話題が混在する会話でのタスク追跡を重点的に強化した。社内比較では、ツール呼び出し回数とtoken使用量がともに減少している。モデルはすでにMuse CodeとAPIで提供されているが、最高推論モード、オープンウェイト、完全に再現可能な評価結果はまだ公開されていない。

最新模型

Gemini 3.8 Flash、高強度のエージェント推論へ転換──Cyber版は審査制で脆弱性修正能力を提供

GoogleはGemini 3.8 Flashを正式に本番環境向けとして提供し、100万tokenのコンテキスト、調整可能な推論強度、新たなAPI移行要件を導入した。共通のコアを持つFlash Cyberは脆弱性の発見と自動修正に特化するが、審査を通過した防御側の利用者にのみFairwindプログラムを通じて提供される。

AI 安全

CrowdStrike SafeMind、レッド・ブルーのエージェント閉ループで検知ルールを生成・リプレイ、評価は依然として提携企業主導

CrowdStrikeとNVIDIAはSafeMindを発表した。攻撃エージェントがテレメトリを生成し、Nemotron防御エージェントが検知ルールの作成、検査、リプレイを担う。クローズドテストでは特化モデルが汎用フロンティアモデルを上回ったものの、モデルの重み、データセット、完全な評価プロトコルはまだ公開されていない。

最新模型

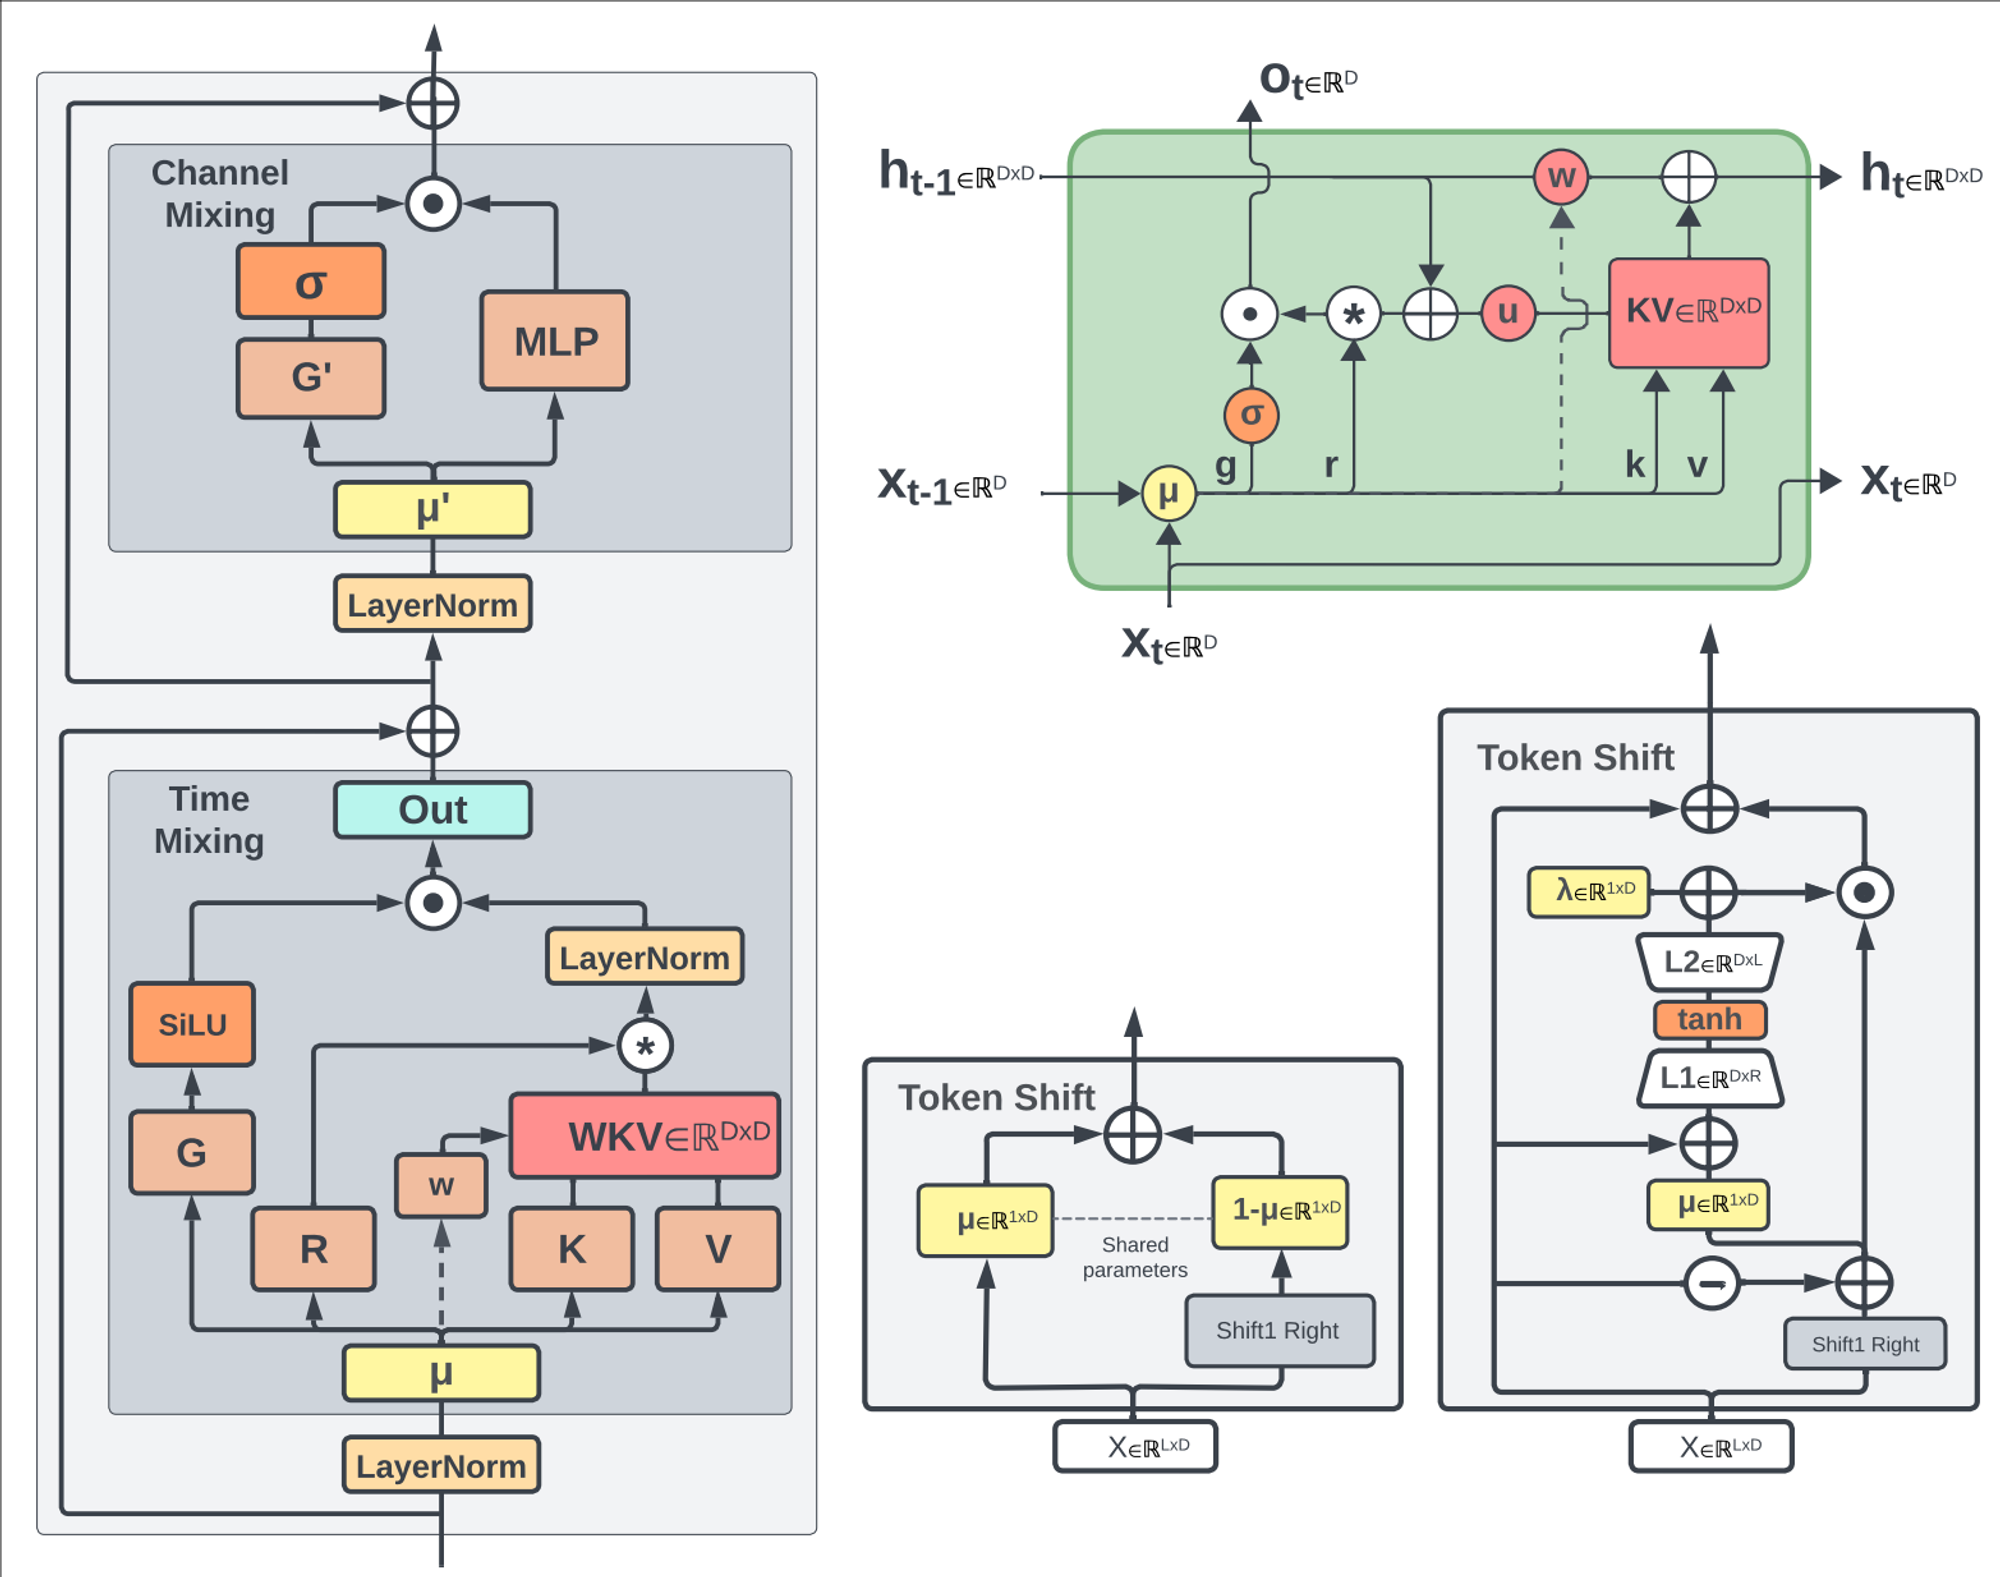
RWKV7-G1j、アテンションフリーの再帰型モデルを13.3Bへ拡張――長いシーケンスのデコードでも固定サイズの状態を維持

RWKVチームは、13.3BパラメータのG1jベースモデルを公開し、Transformers、LoRA、TileLangによる推論サポートをパッケージ化した。固定サイズの再帰状態により、コンテキストとともに増大するKV cacheを回避できる一方、安全性や能力の評価は示されておらず、成熟したチャットアシスタントと直接みなすことはできない。