 代理工具
StateBridge、閉形式アライメントでエージェント間の隠れ状態を伝送――26組のテスト中22組で単独または同率首位
StateBridgeは直交Procrustes変換を用いて、送信エージェントの最終層の隠れ状態を受信エージェントの入力埋め込み空間へマッピングし、プロジェクターの学習を不要にする。4モデルの平均スコアは最強のベースラインを2.4~2.9ポイント上回ったが、現時点では同一のモデル重みを使用するエージェントのみをサポートする。
Archive
模型安全、資安、隱私、供應鏈、紅隊與防護。
代理工具
StateBridgeは直交Procrustes変換を用いて、送信エージェントの最終層の隠れ状態を受信エージェントの入力埋め込み空間へマッピングし、プロジェクターの学習を不要にする。4モデルの平均スコアは最強のベースラインを2.4~2.9ポイント上回ったが、現時点では同一のモデル重みを使用するエージェントのみをサポートする。
 最新模型
AlayaWorldは、インタラクティブ世界モデルの空間メモリと条件付けパイプラインを刷新し、カメラ制御、過去フレーム、生成コンテンツに整合した因果VAE表現を使用するようにした。新たな報告ではWBenchで一貫性の総合スコア首位を記録したが、新版の重みと推論コードはまだ同時公開されていない。
 AI 安全
VICBenchは、人手とエージェントによる二重追跡を通じて、Python、Java、C++プロジェクトにおける100件のCVEのvulnerability-inducing commitをアノテーションした。ファイルをまたぐコード移動やリファクタリングにより、V-SZZとLLM4SZZでは多数の誤判定が生じ、影響を受けるバージョンに関するデータの信頼性にも問題があることが明らかになった。
 AI 安全
Anthropicは、2026年8月2日以降にリリースするClaudeモデルにモデル層のテキスト透かしを導入し、対応ファイルにはC2PA署名付きの来歴データを埋め込む。透かしが証明できるのは、コンテンツがClaudeによって処理された可能性に限られ、作品がAIによって新規生成されたことは証明できない。公開検出ツールや実測精度も、まだ公表されていない。
 AI 安全
IO Factoryは、ナラティブ計画、エージェントによる投稿、プラットフォーム上の露出、オーディエンス状態の更新、ベースライン比較を、追跡可能なシミュレーションのライフサイクルとして統合した。10万体の模擬市民と1万体の工作エージェントという設定で実行を完了しているが、影響を示すすべての数値は、人為的に設定されたルールとLLMジャッジに基づく。
 最新模型
ハイデルベルク大学の研究により、スパースオートエンコーダーでは個々のlatentを解釈できても、活性化したlatentの集合全体は人間の概念と安定して対応しないことが分かった。名詞の前に整合性のある形容詞を加えるだけで、元の活性化集合の20~60%が消失する可能性があり、集合の重なりからモデル状態を解釈する手法の信頼性には限界がある。
 最新模型
MetaはMuse Glimmer 30Bのウェイト、ビジョンエンコーダー、DFlashドラフトモデルを公開した。17GB版では、24GBのVRAM内でテキスト、画像、投機的デコーディングを同時に実行できる。公式測定ではRTX 5090上で平均233.4 token/sを記録したが、安全性評価とデプロイの詳細から、依然として外部の保護策と新しいruntimeが必要であることが分かる。
 最新模型
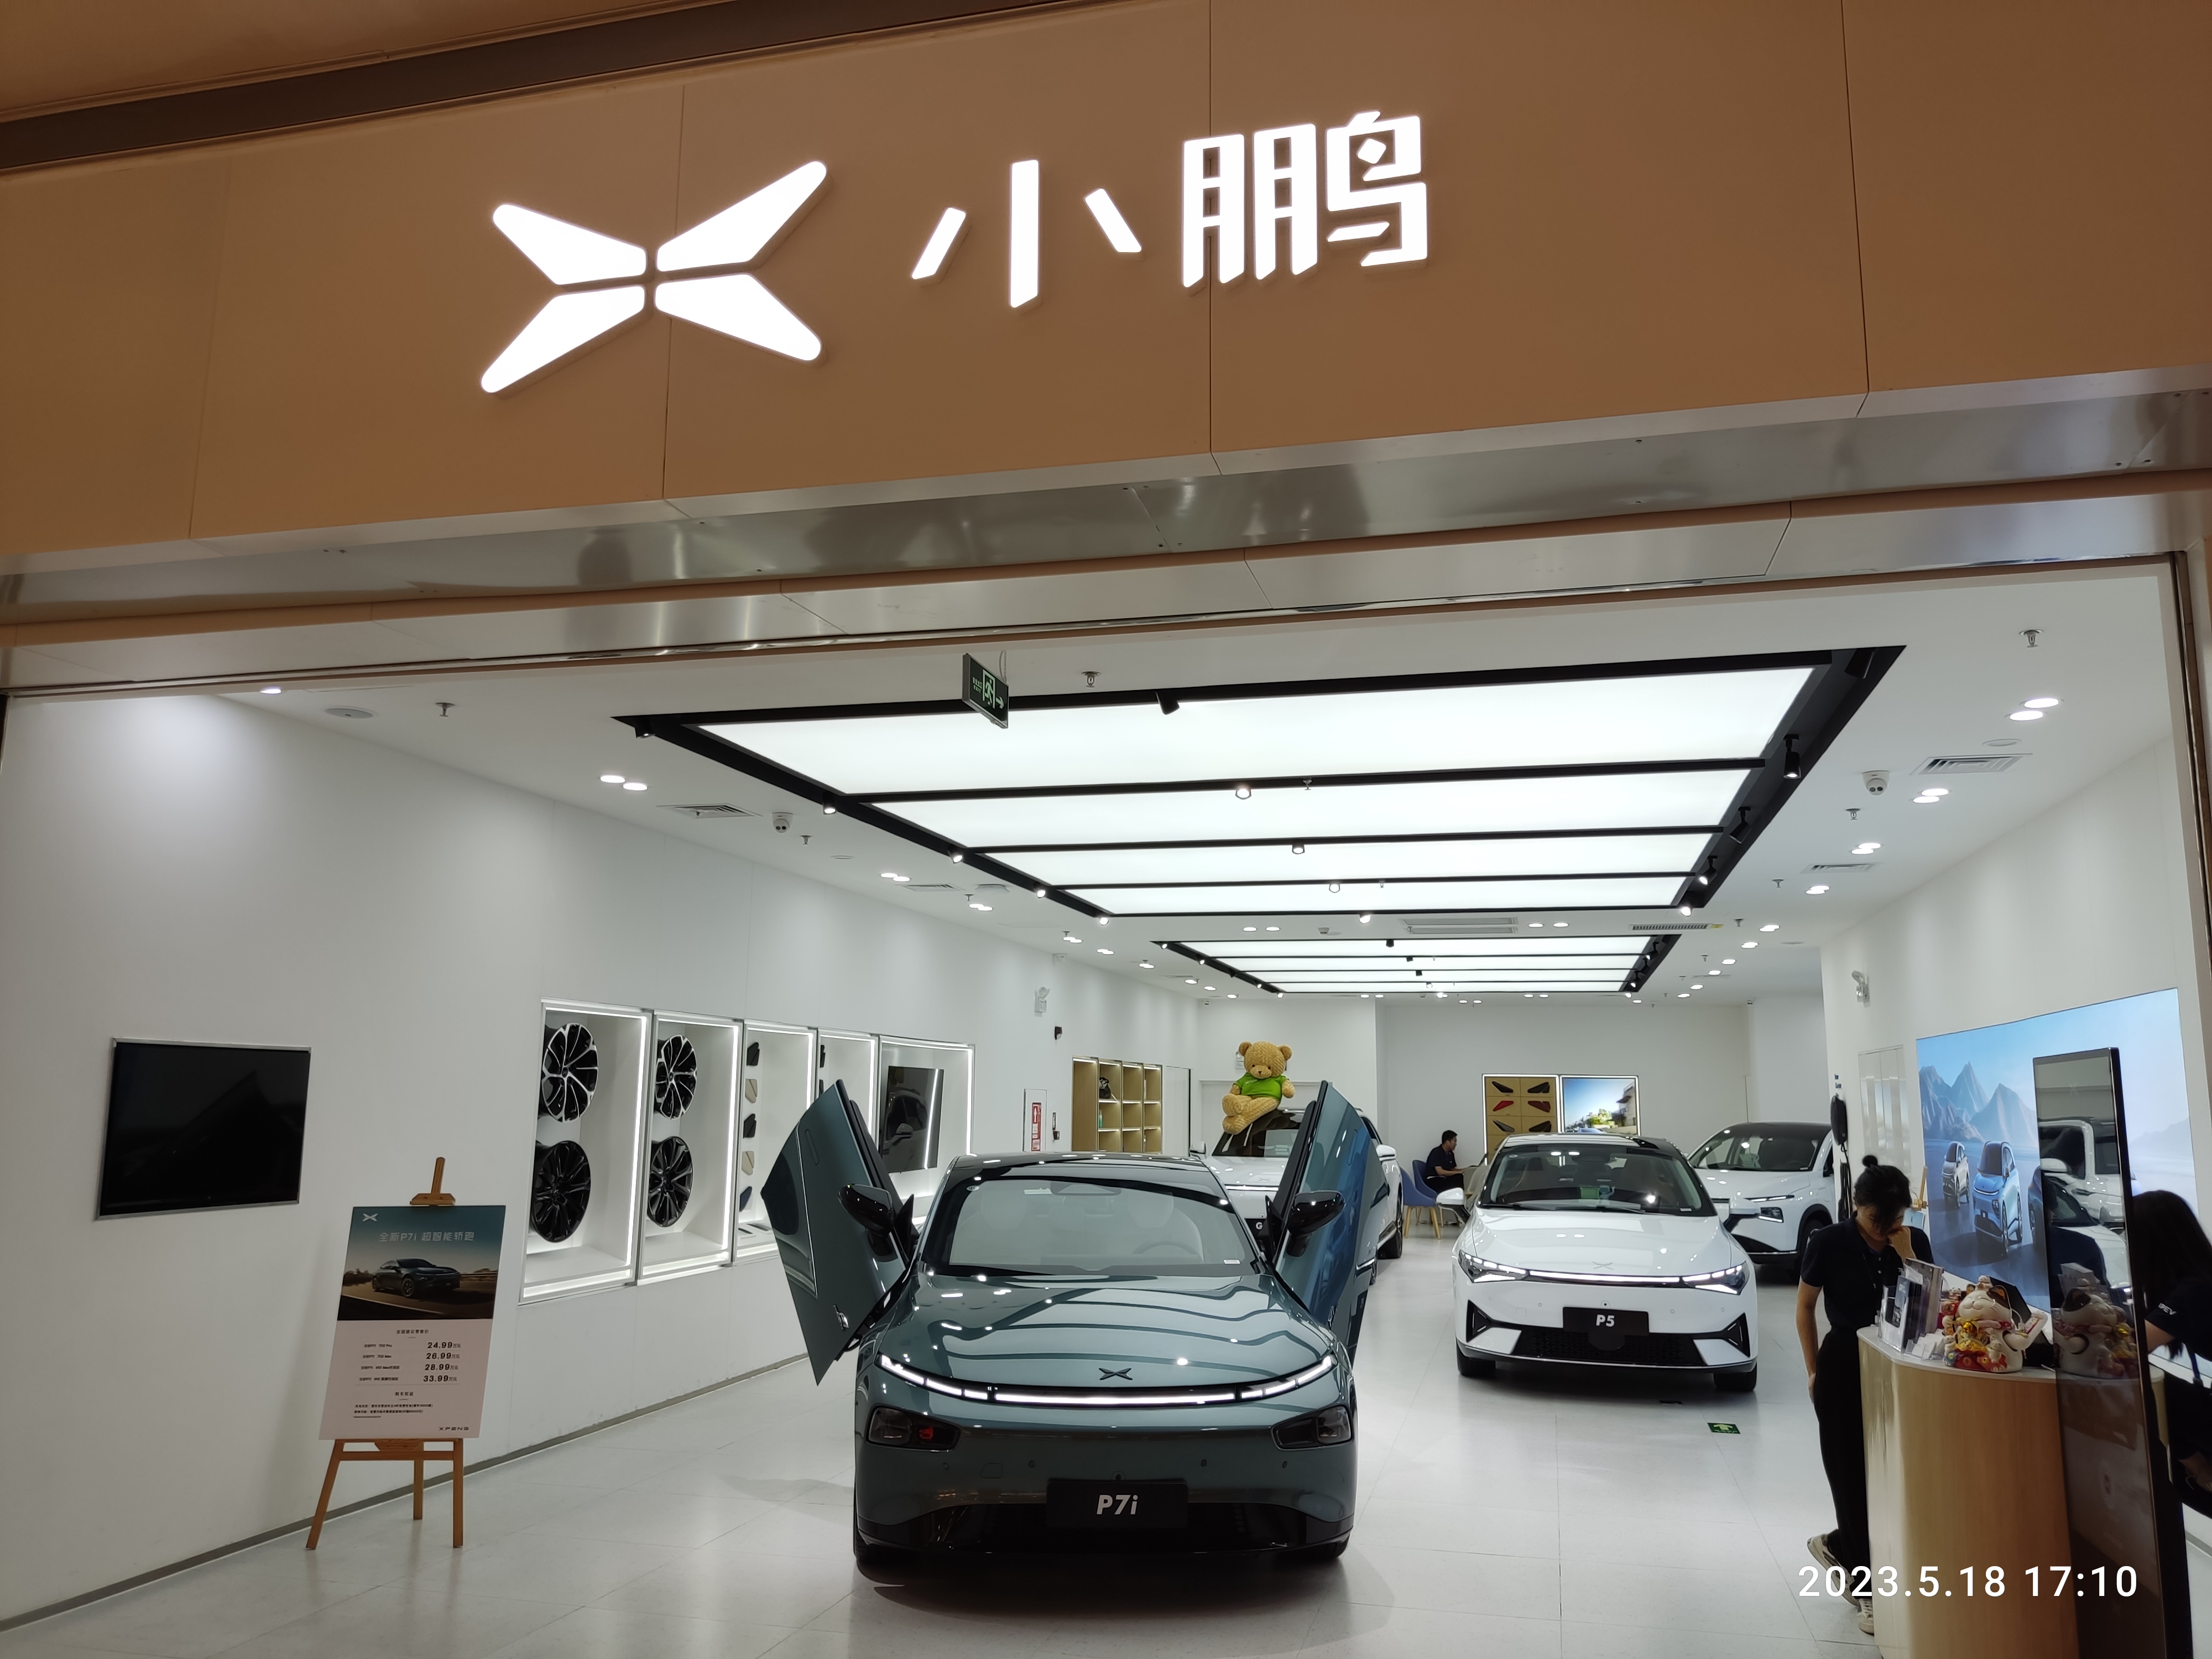
XPengはXCoT-VLAを提案し、数十個の自然言語推論トークンを有限の意味的アクショントークンに置き換え、flow matchingによって連続軌跡を生成する。オープンループ試験では横方向誤差が低減したものの、クローズドループでの安全性評価はまだなく、レイテンシの数値にも車載ソフトウェア/ハードウェアスタック全体は含まれていない。
 AI 安全
REDAgentBenchは、ワークスペース、メール、ブラウザ、銀行、外部ファイルの各サンドボックスで1,661件の攻撃ケースを実行し、被害の発生をエージェントの回答だけで判定する手法を改めた。同一の実行結果をサービスのレシートと最終状態で再評価すると、6モデルすべてで攻撃成功率が軌跡のみの評価より7.73~11.72ポイント高くなった。
 AI 安全
事前登録された再現性監査により、実行可能でクラッシュを引き起こす脆弱性PoCであっても、指定されたCVEを実際に再現しているとは限らないことが判明した。調査対象30件のうち20件では修正版でも同じシグナルが発生しており、AIエージェント向けセキュリティベンチマークには、文字列や終了コードより厳格な判定器が必要であることが示された。
 最新模型
Universal Activation Busは、5つの言語モデルの中間表現を固定された3,072次元の空間に整列させる。新しいモデルは、それぞれ独自の線形エンコーダーとデコーダーを学習するだけでよい。実験対象のモデルは同一のプローブ、スパースオートエンコーダー、自然言語インタープリターを再利用できたが、より幅の広いモデルでは表現の再構成に依然として顕著な歪みが生じた。
 AI 安全
ElasticBackは悪意あるルールを`SKILL.md`に隠し、自然言語内の特定の概念を起動スイッチとして利用するため、モデルの重みを変更する必要がない。実験では、複数の静的チェックと実行時チェックを回避できた一方、Claudeでの誤作動率は依然として20~24%に達した。