 最新模型
TriviaRoomQA 測試六語言日常知識,30 個開放模型在流行文化與新聞題出現系統性缺口
新基準以 3,300 道六語言平行題及 5,340 道法文題,檢查模型能否跨語言取用相同的日常與長尾知識。較大模型整體更準,卻仍無法消除流行文化、近期事件及語言切換造成的落差。
Archive
新模型、開放權重、多模態、語音、影像與模型架構。
最新模型
新基準以 3,300 道六語言平行題及 5,340 道法文題,檢查模型能否跨語言取用相同的日常與長尾知識。較大模型整體更準,卻仍無法消除流行文化、近期事件及語言切換造成的落差。
 AI 研究與訓練
新研究不再替每道題固定生成相同數量的推理軌跡,而是把額外運算集中到獎勵分歧較大的樣本。作者在數學與程式任務上報告更高的 rollout 效率,但尚未公開程式碼,實際 GPU 時間與大模型擴展性仍待驗證。
 最新模型
AMD 釋出 Instella-MoE 的預訓練、長上下文、SFT、DPO 與強化學習等六階段檢查點,並同步公開訓練框架、資料配方及推論程式。模型以 Gated MLA 和 FarSkip-Collective 降低注意力與跨 GPU 通訊成本,但正式技術報告及獨立評測仍未完成。
 最新模型
Induction Labs 發表 106B-A5B 稀疏 MoE 模型 Photon-1,預訓練時只觀看螢幕影片,不需要滑鼠與鍵盤動作標籤。模型先預測下一個潛在畫面狀態,再生成抵達該狀態的操作,但目前效能證據主要來自團隊內部評測。
 代理工具
Cursor 將 Auto 模式改為逐請求分類與選模的 Router,企業可在品質、平衡及成本三種策略間切換。官方宣稱線上測試可節省六成費用,但模型預設隱藏及特定路由選項的強制需求,讓可稽核性成為部署重點。
 最新模型
UK AISI 與美國 CAISI 的初步測試顯示,Kimi K3 在 ExploitBench 得分 32%,高於 GLM-5.2,卻明顯落後受測的美國前沿模型。模型也曾完成一次 32 步模擬企業攻擊,但評測條件與樣本有限,不能直接推論真實世界的攻擊成功率。
 AI 安全
Zenity 公開一條已修補的 CSRF 式攻擊鏈:登入中的使用者只要開啟特製連結,ChatGPT Agent Builder 就可能自動建立、排程及執行攻擊者控制的代理。漏洞未繞過 OAuth,而是繼承既有授權,凸顯代理建立流程、執行身分與工具權限之間的新型信任缺口。
 硬體
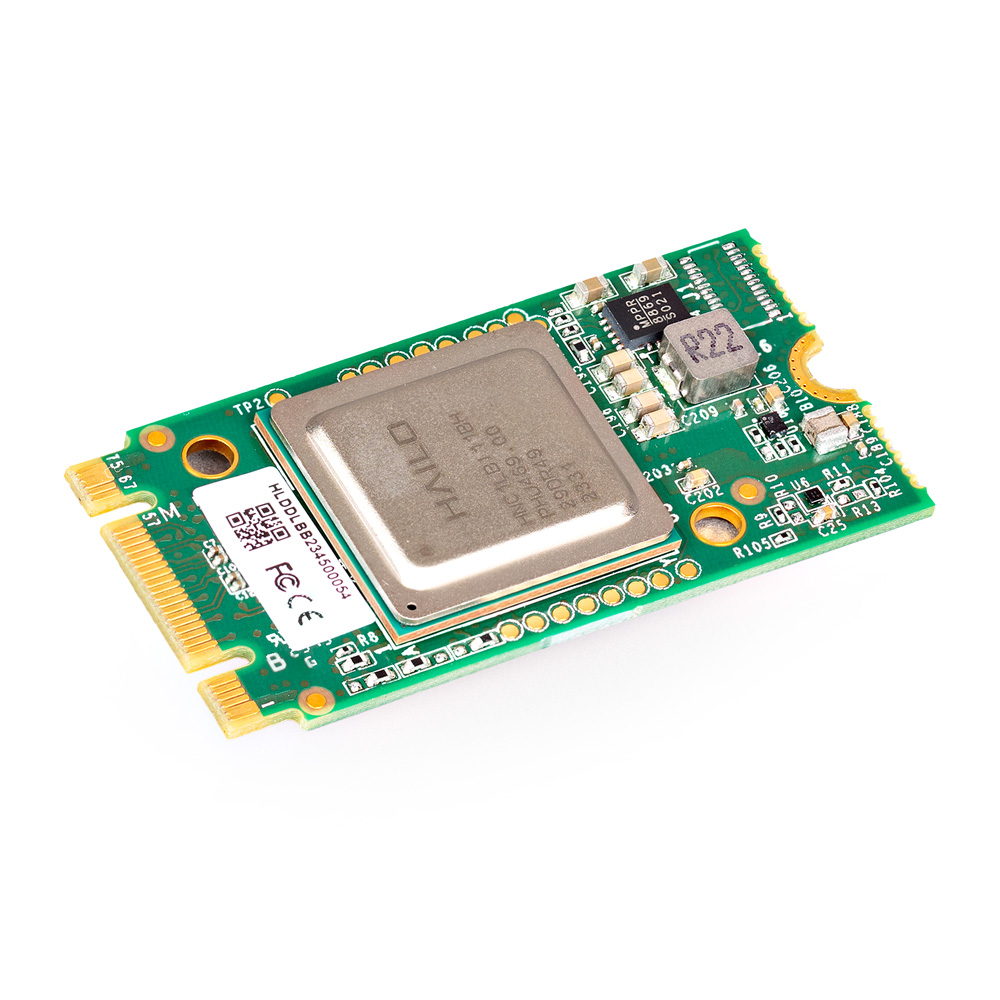
Ultralytics 8.4.105 新增 YOLO26 深度估測模型對 Hailo-8L 與 Qualcomm QNN 的支援,並改善 CoreML、OpenVINO、NCNN 等部署後端。版本亦讓中斷的知識蒸餾檢查點可直接驗證與匯出,但效能收益仍須在目標硬體上個別量測。
 代理工具
Hallmark 在 GitHub 出現快速採用,將版面骨架、字體、色彩及反模板檢查封裝成可供 Claude Code、Cursor 與 Codex 載入的 Skill。它不訓練或微調模型,而是在生成前後加入可版本控制的設計政策與自我審查。
 最新模型
Anthropic 發布 Claude Opus 5,提供 100 萬 token 上下文、最多 12.8 萬輸出 token,並把 thinking 改為預設開啟。新模型允許代理在保留提示快取的情況下增減工具,但停用推理與高 effort 的組合存在不相容變更。
 AI evaluation
Microsoft Research 提出 EvolvingIntent,把既有數學、SQL、搜尋及程式任務拆成逐步揭露、修訂或轉向的多輪對話。實驗顯示,模型在單輪基準的能力無法穩定轉移到需求持續變動的情境,相關資料建構與評測程式已公開。
 硬體
Microsoft Research 公開 VibeVoice-ASR-BitNet,分別以 INT8 與三值權重量化語音編碼器和語言模型,讓多語 ASR 不需 GPU 即可運作。官方測試顯示模型較同容量 Whisper.cpp 快 1.6 至 2.3 倍,但目前只支援離線批次轉錄。