 代理工具
Fisher-R1 以可驗證 p 值訓練統計代理,P-Hard 嚴格 pass@1 達 33.0%
P-Bench 要求代理自行選擇統計方法、執行 R 程式並回報 p 值,不再只檢查程式能否執行。14B 模型在困難題的嚴格指標領先所列開放模型,但目前公開儲存庫仍只有說明文件。
Archive
新模型、開放權重、多模態、語音、影像與模型架構。
代理工具
P-Bench 要求代理自行選擇統計方法、執行 R 程式並回報 p 值,不再只檢查程式能否執行。14B 模型在困難題的嚴格指標領先所列開放模型,但目前公開儲存庫仍只有說明文件。
 推論系統
社群部署配方在單台 DGX Spark 上啟用 CUDA Graph 與一層 MTP 推測解碼,把 Ling-3.0-flash INT4 的生成速度由 20.8 提至 38.7 token/s。更關鍵的發現是主線 vLLM 尚未支援 V3 架構,強行套用舊注意力路徑不一定報錯,卻可能輸出看似流暢的錯誤內容。
 最新模型
MiniMax H3 將文字、圖片、影片與音訊封裝成單一序列,聯合預測視覺及音訊 latent,輸出最高 768p、24 FPS、32 kHz 立體聲。官方工作流程宣稱可再生至 2K,但提示編排與高解析度模組仍只提供託管 API。
 代理工具
Scale AI 將提示、工具、記憶與控制流程視為可由模型修改的程式,並以隱藏測試集衡量實際增益。111 次實驗顯示,原生編碼代理並未穩定勝過共用外殼,驗證階段看到的最佳分數也普遍偏樂觀。
 代理工具
CalibForge 不再保留所有能執行的合成題,而是反覆修改任務,直到不同求解代理出現預定的成功與失敗關係。用校準軌跡微調的兩款模型在三項程式代理基準均有增益,但完整訓練需要 64 張 H20,且部分結果只執行一次。
 AI 安全
新基準用四種配對情境區分模型是正確判斷證據,還是索性忽略所有外部資訊。SCOPE 只改造 DPO 的偏好資料配置,降低錯誤情境造成的答案翻轉,同時維持正確與無關情境下的準確率。
 最新模型
擴充版 Low Frequency Trap 以 2,190 段可程式化影片,把事件數量與頻率分開測量。Gemini 3.6 Flash 的彈球計數準確率隨取樣增加而上升,但時間戳序列 F1 反而只有 3.7%。
 最新模型
新研究以反事實裁切測試六款開放模型,區分「呼叫工具」與「工具回傳內容實際改變答案」。多數正向增益集中在少數校準良好的軌跡,單看最終準確率可能高估視覺工具能力。
 代理工具
EnvACE 在訓練時不查詢外部環境,而由同一策略交替產生工具動作與想像中的環境回應。它降低建立可執行訓練環境的依賴,但也把模擬錯誤直接吸收到代理參數中。
 最新模型
DASH 不再等量處理每個 token 的師生差異,而是根據整段推理中的分歧變化調整監督範圍。三種 Qwen3 規模均優於同條件 OPSD,但最佳 checkpoint 由測試基準平均分挑選,可能高估泛化增益。
 推論系統
PaDoc 讓版面序列與各區域內容共用頁面前綴並行解碼,避免把整頁文件串成單一路徑。2.1B 模型在 OmniDocBench 維持 94.24 整體分數,但效能數字來自單一 GPU 與特定排程設定。
 硬體
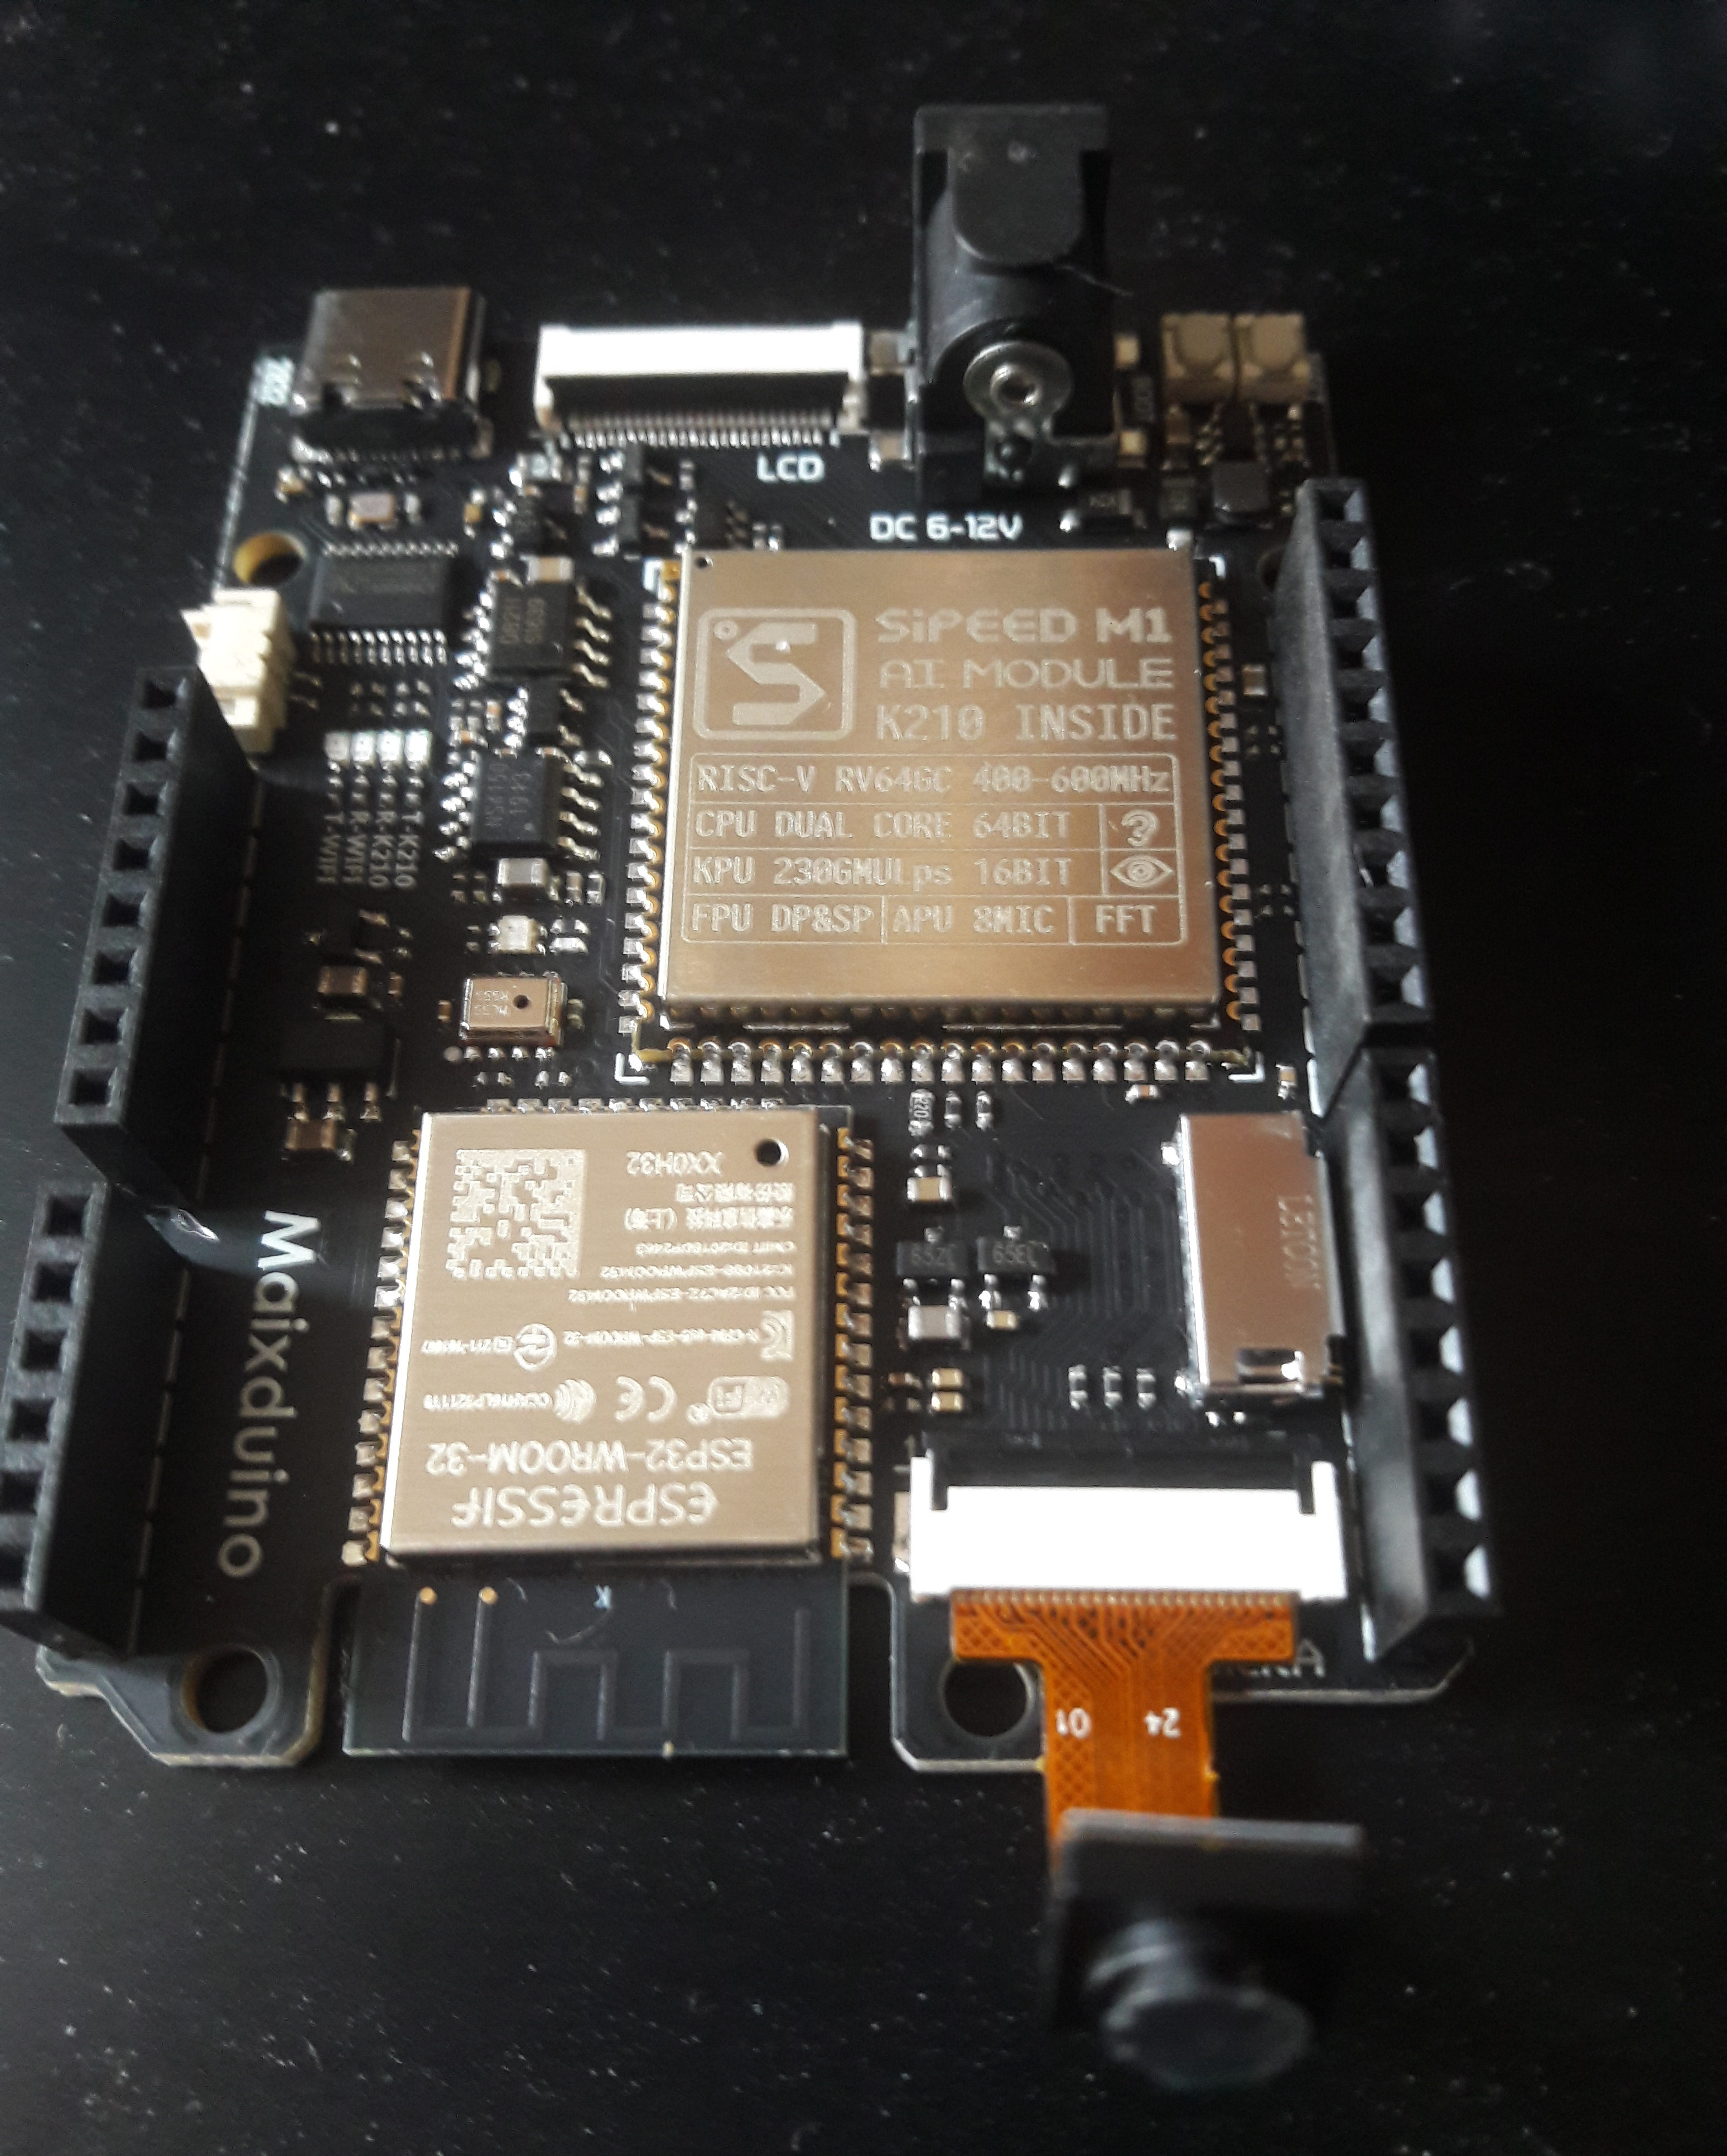
開源專案 esp32-ai 以 4-bit 量化及分層記憶體配置,把約 2,500 萬個嵌入參數留在快閃記憶體,只按 token 讀取所需列。模型能在低於 10 美元的微控制器上離線生成文字,但能力仍限於簡短故事與單一領域問答。