 AI 研究
CliffCompaction 釋出代理壓縮套件,以原文片段縮減上下文
套件透過 API 代理服務刪除或截短舊內容,讓既有程式代理接入規則式壓縮。論文成本比較採理想快取模型,公開預設值也與實驗不同。
Archive
新模型、開放權重、多模態、語音、影像與模型架構。
AI 研究
套件透過 API 代理服務刪除或截短舊內容,讓既有程式代理接入規則式壓縮。論文成本比較採理想快取模型,公開預設值也與實驗不同。
 AI 研究
方法保留全部遞迴步驟,透過早期探索縮小後續注意力運算範圍。效能數字僅涵蓋注意力負載,4K 上下文的品質下降與公開重現材料仍須核對。
 AI 基礎設施
BioNeMo 結合分組專家運算、專家平行與 MXFP8,提高特定訓練負載的吞吐量。最快配置同時改變精度與平行策略,收益仍須連同收斂品質評估。
 GitHub Repo
新路徑重用 ggml Metal 核心,讓量化權重留在 Transformers 流程中執行。功能目前須從主分支安裝,模型覆蓋、批次處理及核心相容性仍有限制。
 GitHub Repo
新版在純文字生成碰到輸出上限時,先嘗試釋放上下文再重試。已出現工具活動的回合不會由此機制重播,實際恢復率仍待量測。
 AI 研究
研究利用英文無標註語音蒸餾,部分恢復剪枝後的辨識能力。測速中的 1.75 倍包含批次改變,相同批次效益與中文品質須分別評估。
 AI 研究
資料集保留逐人音軌與共同時間軸,供全雙工語音及輪替研究使用。中文部分未列出人工標註時數,自動逐字稿也不宜直接作為訓練標準答案。
 推論系統
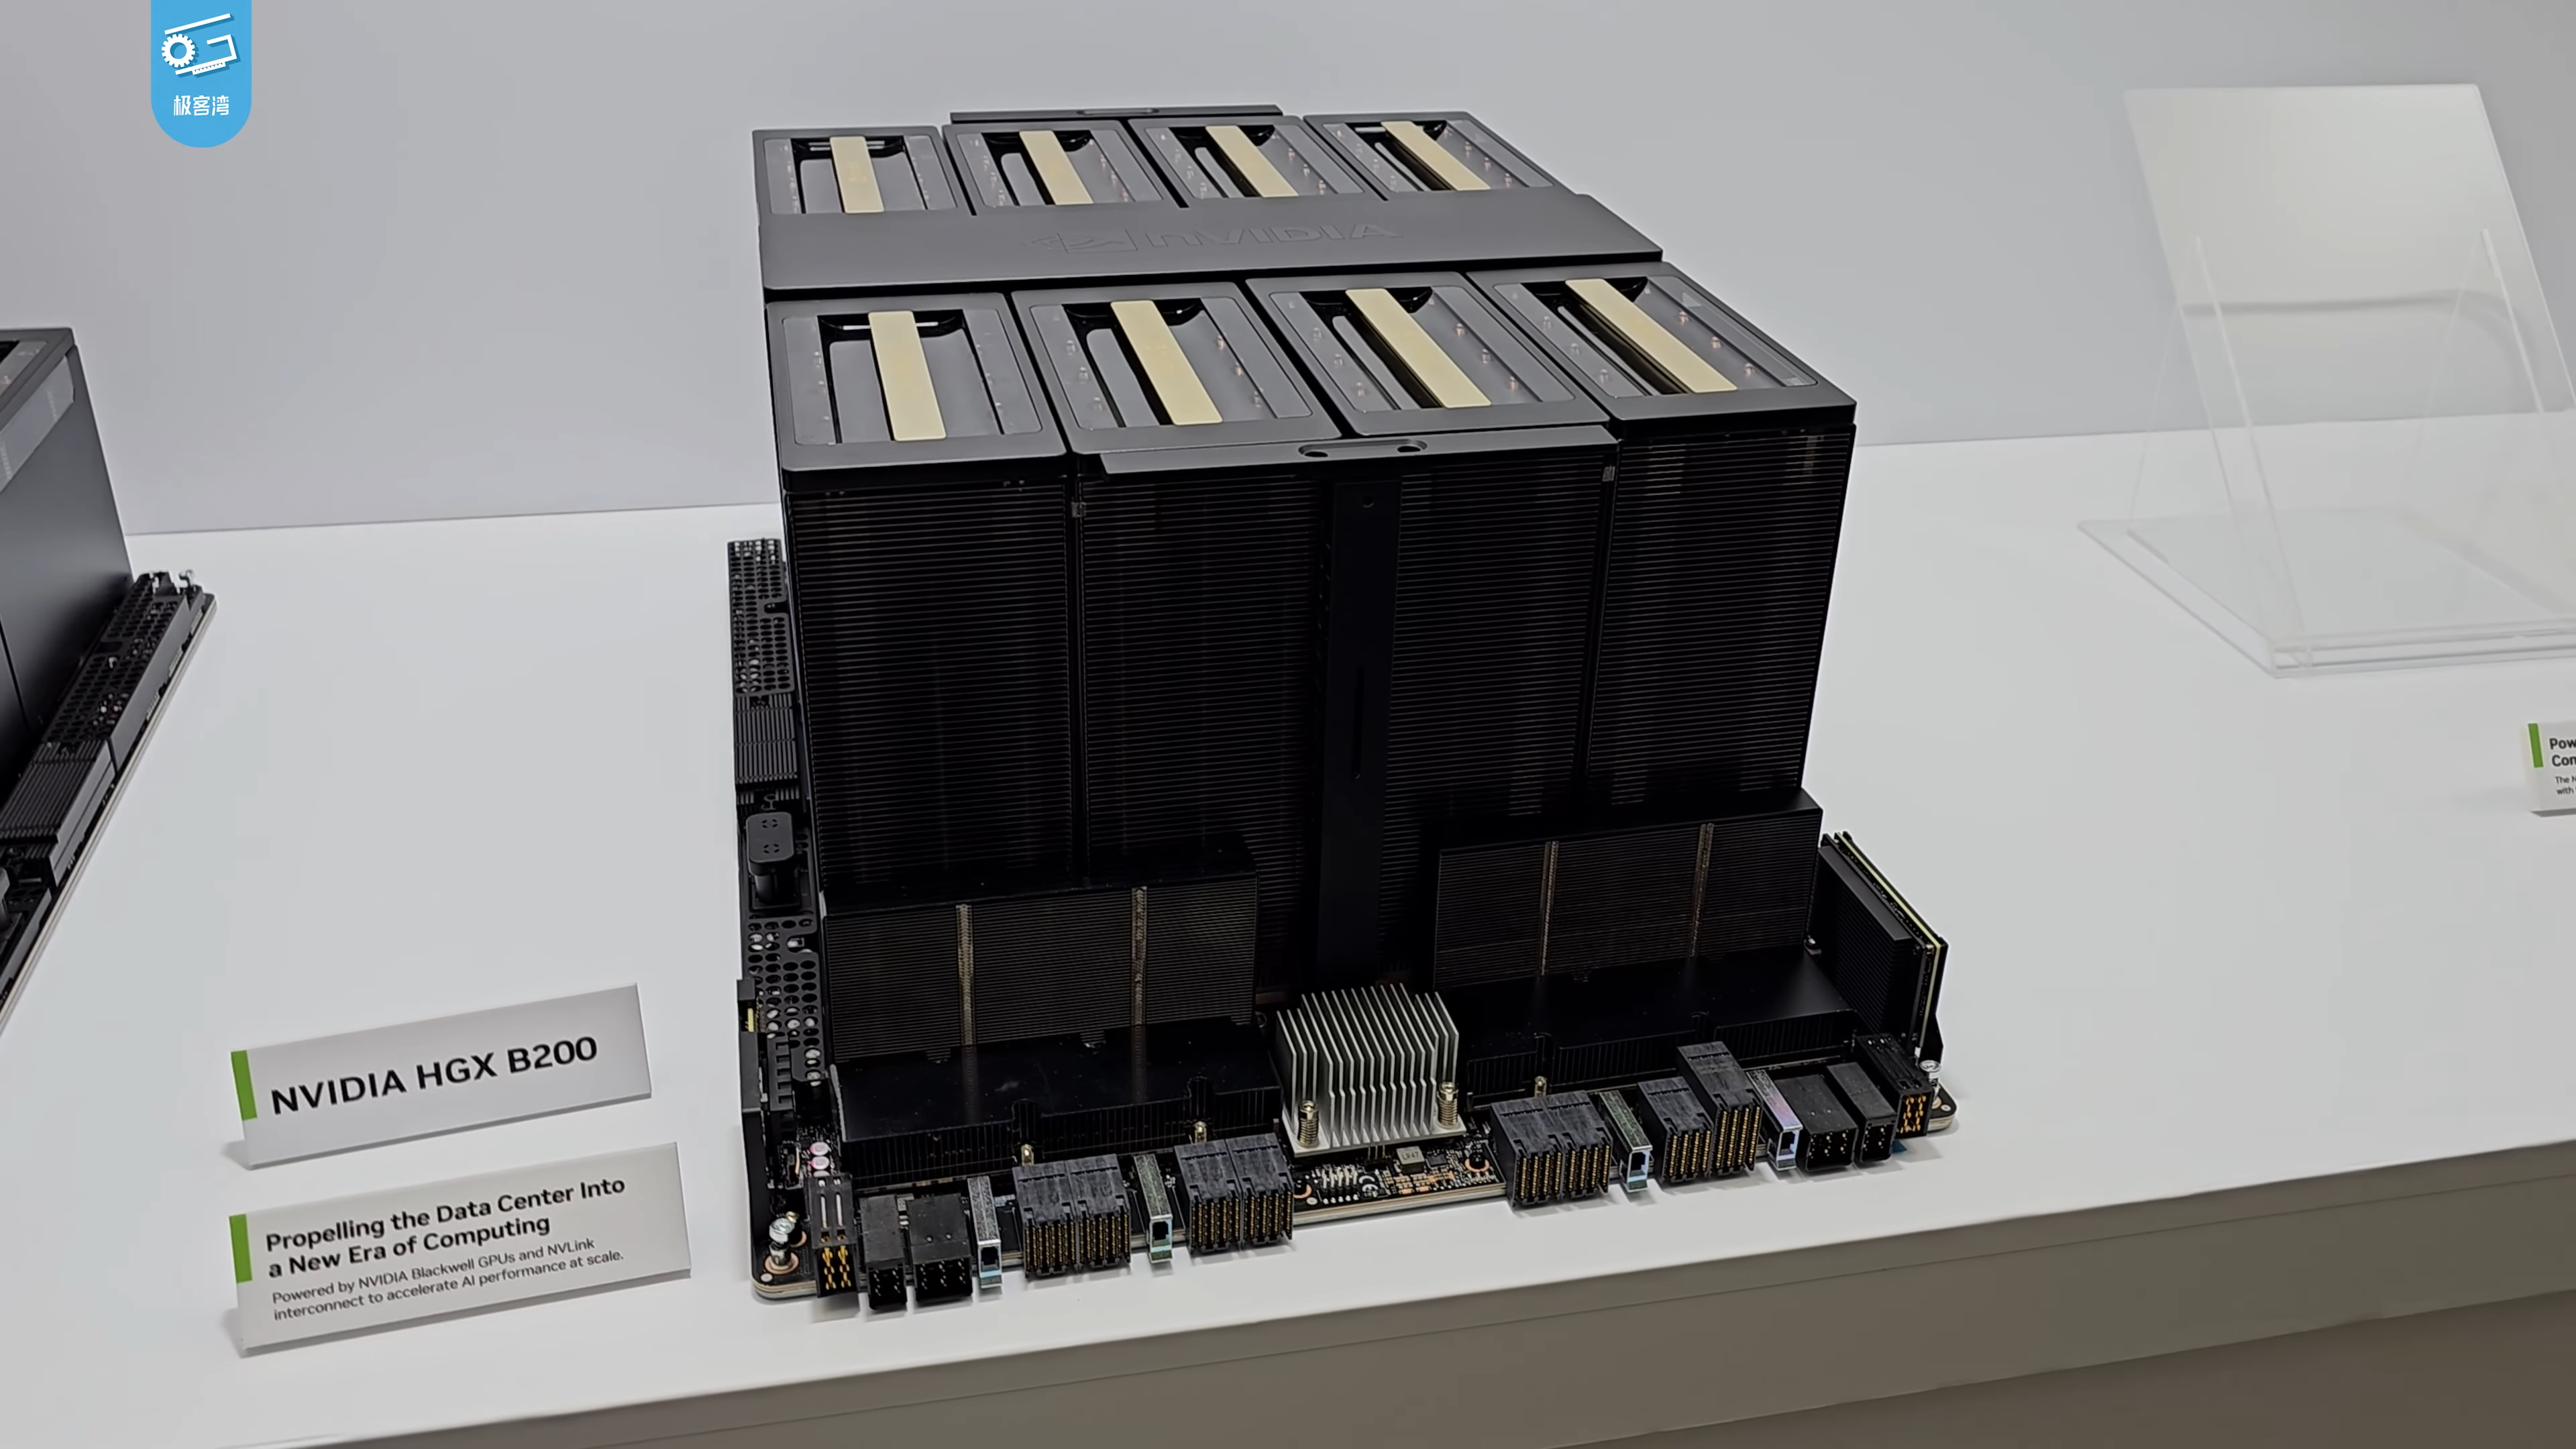
八張 B200 執行 DeepSeek-R1 的測試顯示,機密運算下平均每 token 延遲增幅低於 5%。結果依賴記憶體搬移、核心計時與多卡通訊調整,仍須按實際服務負載重驗。
 最新模型
Google 推出 Flash 與 Flash-Lite 兩款文字轉語音模型,加入可重用的自訂聲音資源。新版調整提示結構及預設音訊格式,自訂聲音的多人對話仍須逐輪合成。
 AI 安全
漏洞涉及預填充/解碼分離節點的 RPyC 服務,攻擊者須能連上控制埠。公開重現顯示利用後健康檢查仍可正常,公告尚未列出已修補版本。
 GitHub Repo
新路徑將可攜模型層與硬體專用最佳化隔離,首批元件已接入 Transformers 後端。H100 初測顯示吞吐量接近原有路徑,但層覆蓋與跨平台效能仍須核對。
 推論系統
Physical AI Toolchain 新增遠端 GPU 推論部署,提供兩種機械臂範例。既有研究顯示,額外延遲與影像頻寬可能抵銷運算收益,部署須評估完整控制流程。