 代理工具
HarnessOpt-Bench、モデルによるエージェント・ハーネスの書き換えを評価——モデル選択の影響はコーディングツールの約1.8倍
Scale AIは、プロンプト、ツール、メモリ、制御フローをモデルが変更可能なプログラムとして扱い、非公開テストセットで実際の改善を測定した。111回の実験では、ネイティブのコーディングエージェントが共通ハーネスを安定して上回ることはなく、検証段階で得られた最高スコアも概して楽観的だった。
Archive
新模型、開放權重、多模態、語音、影像與模型架構。
代理工具
Scale AIは、プロンプト、ツール、メモリ、制御フローをモデルが変更可能なプログラムとして扱い、非公開テストセットで実際の改善を測定した。111回の実験では、ネイティブのコーディングエージェントが共通ハーネスを安定して上回ることはなく、検証段階で得られた最高スコアも概して楽観的だった。
 代理工具
CalibForgeは、実行可能な合成問題をすべて残すのではなく、異なる解答エージェント間で所定の成功・失敗関係が生じるまでタスクを繰り返し修正する。キャリブレーション軌跡でファインチューニングした2つのモデルは、3種類のコーディングエージェント・ベンチマークすべてで性能が向上したが、フルパラメータ学習には64基のH20が必要で、一部の評価は1回しか実施されていない。
 AI 安全
新ベンチマークは4種類の対照的なコンテキストを用い、モデルが証拠を正しく評価しているのか、それとも外部情報を一律に無視しているだけなのかを判別する。SCOPEはDPOの選好データ構成のみを変更し、正解・無関係コンテキストでの精度を維持しながら、誤情報による回答反転を抑える。
 最新模型
拡張版Low Frequency Trapは、プログラム可能な2,190本の動画を用いて、イベント数と頻度を分離して測定した。Gemini 3.6 Flashのボール衝突回数の計数精度はサンプリングの増加に伴って向上したが、タイムスタンプ系列のF1は逆にわずか3.7%だった。
 最新模型
新たな研究は、反実仮想クロップを用いて6つのオープンモデルを検証し、「ツールを呼び出すこと」と「ツールの返却内容が実際に回答を変えること」を区別した。正の増益の大半は、適切に較正された少数の軌跡に集中しており、最終精度だけを見ると視覚ツールの能力を過大評価する恐れがある。
 代理工具
EnvACEは訓練時に外部環境へ問い合わせず、同一の方策がツールアクションと想像上の環境応答を交互に生成する。実行可能な訓練環境を構築する必要性を低減する一方、シミュレーションの誤りもエージェントのパラメータへ直接取り込まれる。
 最新模型
DASHは、各tokenにおける教師と生徒の差異を一律に扱うのではなく、推論全体にわたる分岐の変化に応じて監督範囲を調整する。3種類のQwen3モデル規模すべてで同一条件のOPSDを上回ったが、最良のcheckpointはテストベンチマークの平均スコアで選定されており、汎化性能の向上を過大評価している可能性がある。
 推論系統
PaDocは、レイアウト系列と各領域のコンテンツでページ接頭辞を共有し、並列デコードを行うことで、ページ全体を単一の系列として処理することを回避する。2.1BモデルはOmniDocBenchで総合スコア94.24を維持したが、性能値は単一GPUと特定のスケジューリング設定に基づく。
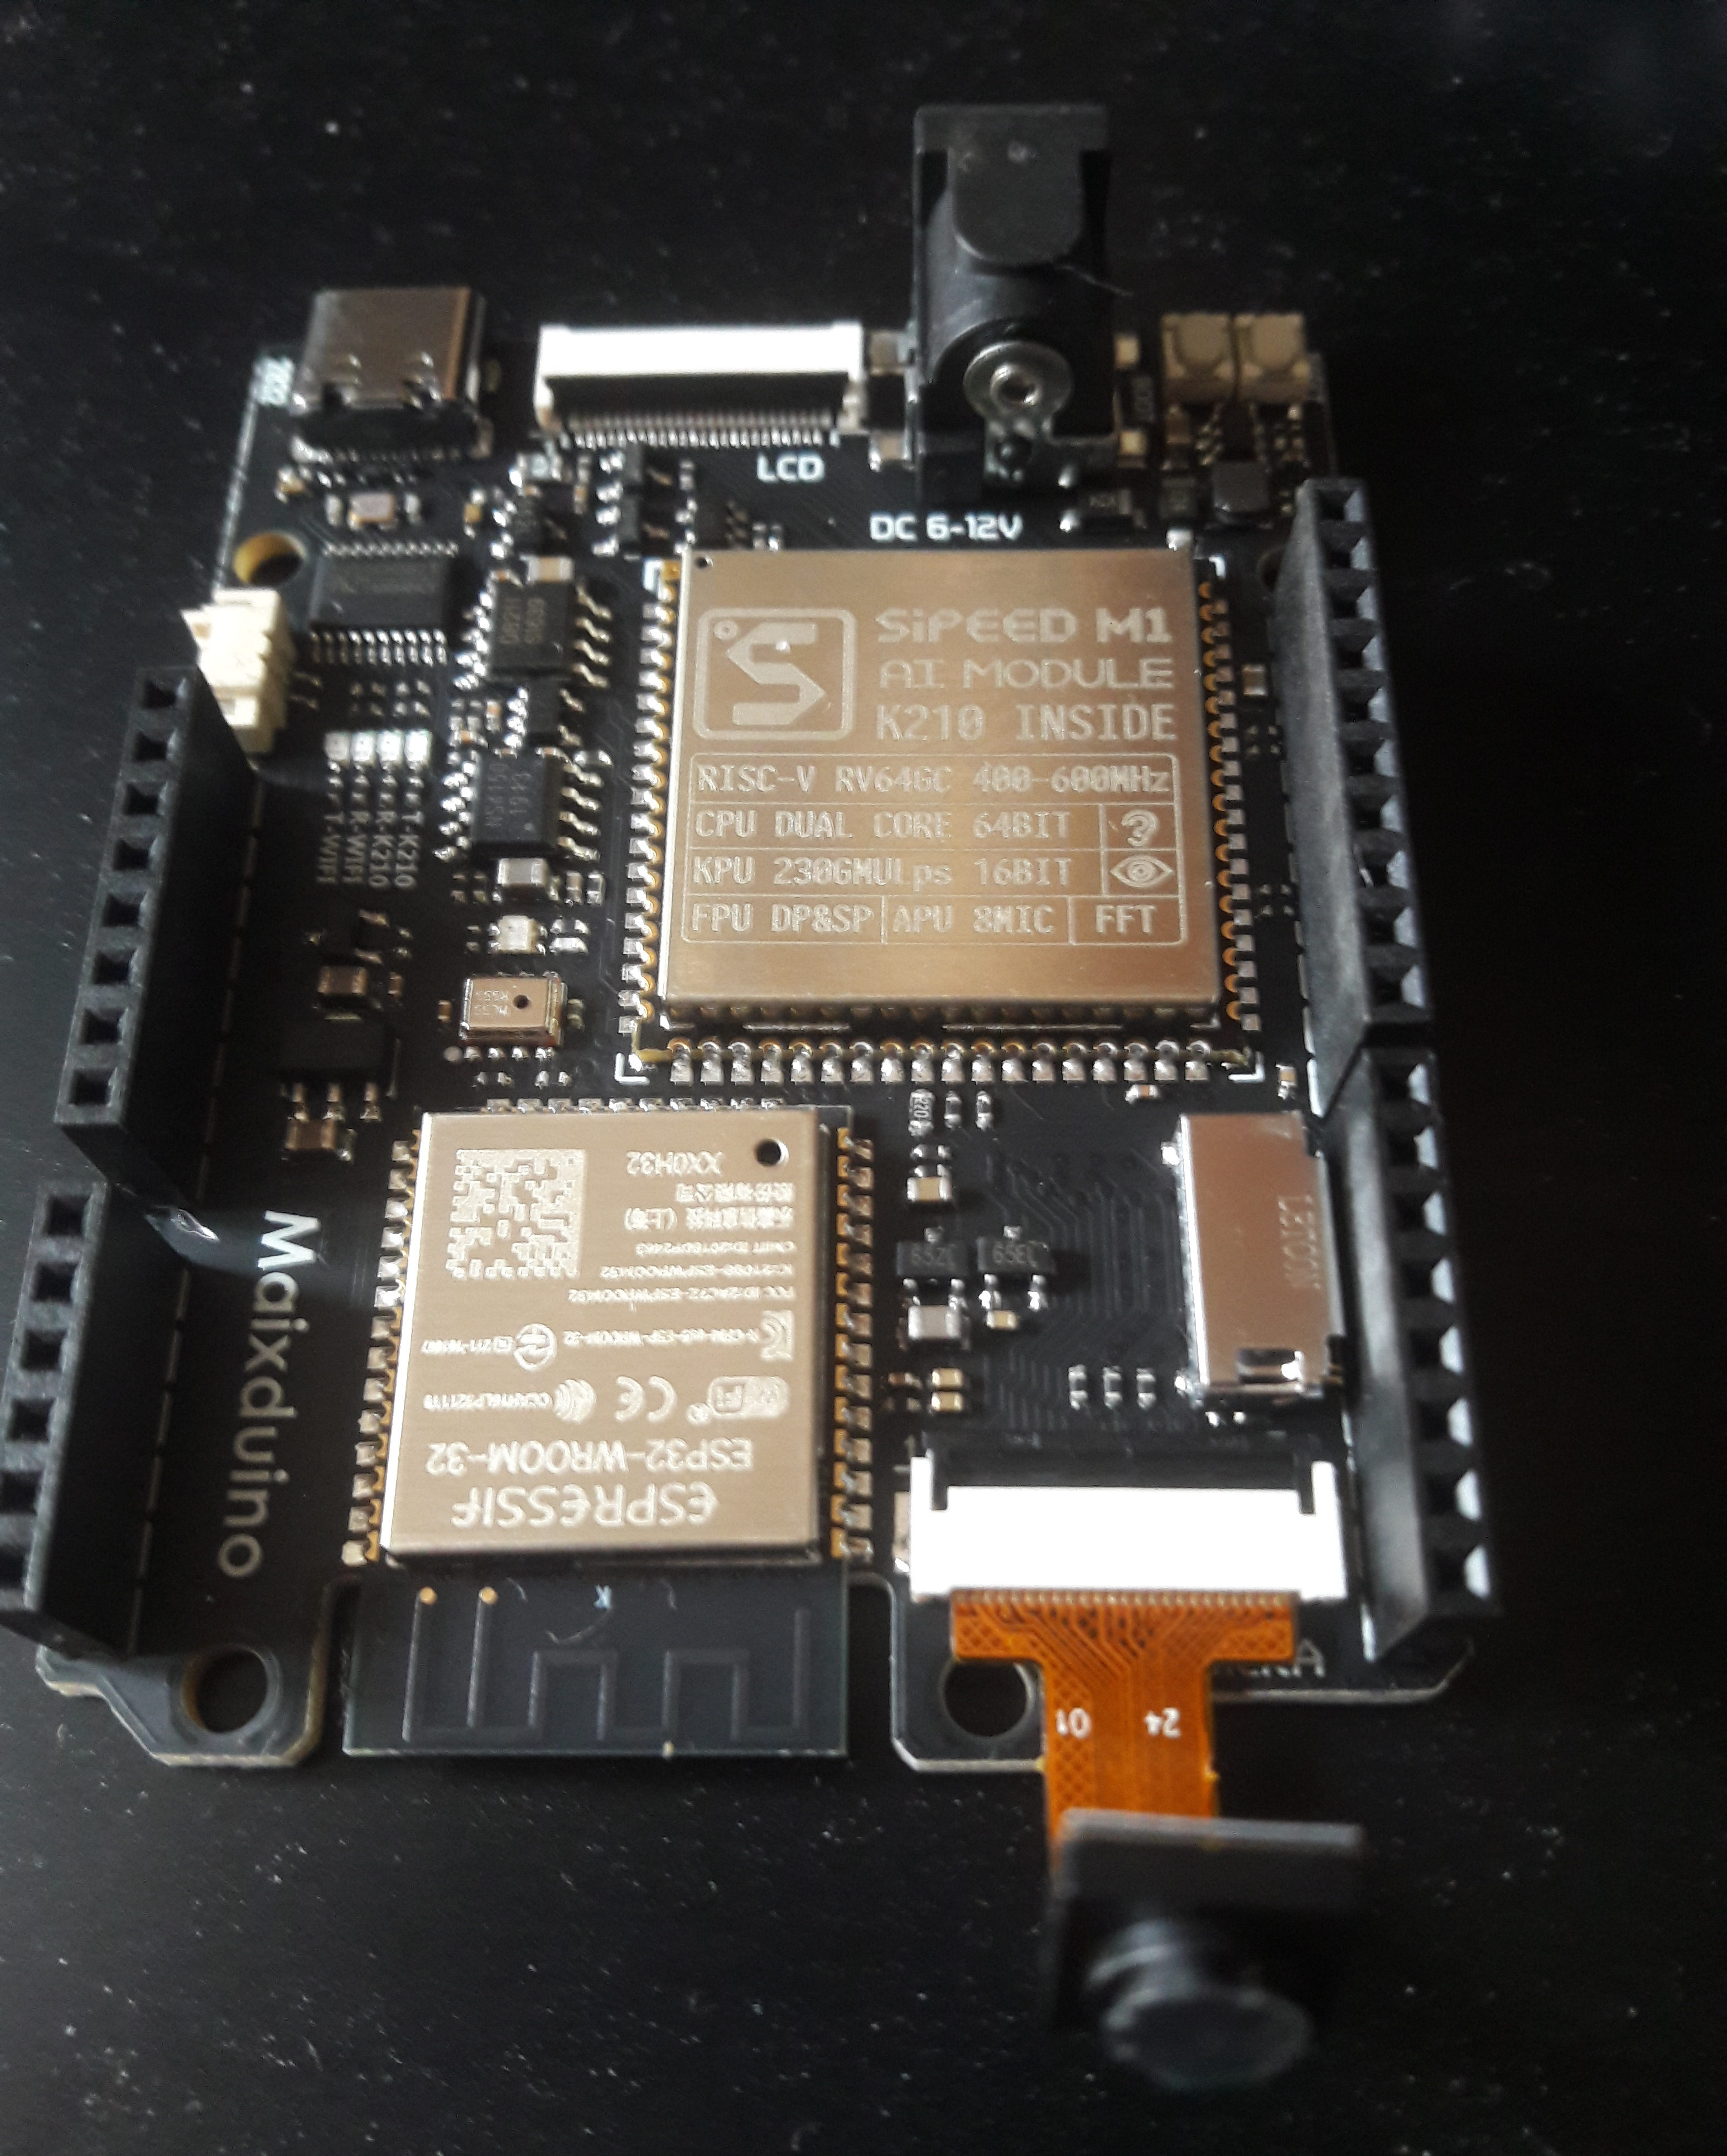 硬體
オープンソースプロジェクトのesp32-aiは、4-bit量子化と階層型メモリ配置を採用し、約2,500万の埋め込みパラメータをflashに保持して、tokenごとに必要な行だけを読み出す。10米ドル未満のマイクロコントローラ上でオフラインのテキスト生成が可能だが、その能力は依然として短い物語や単一分野の質問応答に限られる。
 推論系統
PhyAIはモデルアダプターにより各アーキテクチャの条件、ソルバー、行動セマンティクスを維持しつつ、グラフ実行、カーネル、キャッシュ、マルチGPUサービスを共通化する。公開テストはπ0、π0.5、GR00T N1.7、Cosmos3、MiniCPM-Robotを対象とするが、一部の比較では数値精度が完全には統一されていない。
 代理工具
Ai2は、実際の数学個別指導のトランスクリプト462件を基に再現可能な評価を構築し、モデルに「足場かけを提供する」か「生徒に深い推論を求める」かを選択させた。両者のトレードオフを明示すると7つのモデルすべてで性能が向上したが、生徒のシミュレーションとモデルによる採点だけでは、実際の学習効果を証明できない。
 應用研究
Otterは各盤面を独立したサンプルとして扱わず、直近20手と時間制御の情報も同時に取り込む。著者らのLichess rapidテストではMaia-2を上回ったが、すでに公開されているMaia-3との同一データ分割による直接比較は行われていない。