 代理工具
Harness‑IF、「もともとできる」ことと真の指示遵守を分離──12種類のコーディングエージェントで最大7.4ポイント差
Harness‑IFは、ルールをシステムプロンプト、プロジェクトファイル、ユーザー指示、ツール記述、スキル記述に分散させ、実際の実行証拠に基づいて一つずつ評価する。12種類の最先端モデルはいずれも、自身のデフォルト傾向に反するルールに直面すると正確率が低下した。
Archive
新模型、開放權重、多模態、語音、影像與模型架構。
代理工具
Harness‑IFは、ルールをシステムプロンプト、プロジェクトファイル、ユーザー指示、ツール記述、スキル記述に分散させ、実際の実行証拠に基づいて一つずつ評価する。12種類の最先端モデルはいずれも、自身のデフォルト傾向に反するルールに直面すると正確率が低下した。
 最新模型
LTX‑2.5は、学習可能な22Bモデルと8ステップ蒸留モデルの重みを公開し、ショットをまたぐキャラクター、音声、シーンの一貫性を追加した。完全なクイックスタート用コンポーネントは約66 GiBで、Diffusers対応には依然としてmainブランチのインストールが必要だ。また、モデルには売上高基準のコミュニティライセンスによる制限もある。
 最新模型
AlibabaのQwenがQwen3.8‑2.4T‑A95Bを公開した。512のエキスパートと、線形Attentionおよび標準Attentionのハイブリッド構成により、最長約101万tokenに対応する。推論深度は調整できるものの、入力はテキストのみで、思考モードを無効化できない。実際のデプロイ要件は、一般的なオープンウェイトモデルをはるかに上回る。
 最新模型
新たな研究で、4つのオープンウェイトモデルの生成上限を64から4,096 tokenまで引き上げたところ、3つの推論ベンチマークすべてで首位モデルが入れ替わった。打ち切られた出力を除外しても、予算を増やした際に正解から不正解へ転じた問題が3~19%あり、単一のtoken設定だけではデプロイするモデルを十分に選定できないことが示された。
 代理工具
Amazonの研究チームは、既存のツール使用ベンチマークを「再試行、切り替え、停止」を制御できる障害環境へと改造した。Qwen3-4Bに構造化された復旧情報を追加すると、障害下の小売タスクの合格率は最大16.8ポイント向上したが、解決不能なタスクで正しく棄権できるかは、まだ実際には検証されていない。
 AI 安全
Anthropicは、2026年8月2日以降にリリースするClaudeモデルにモデル層のテキスト透かしを導入し、対応ファイルにはC2PA署名付きの来歴データを埋め込む。透かしが証明できるのは、コンテンツがClaudeによって処理された可能性に限られ、作品がAIによって新規生成されたことは証明できない。公開検出ツールや実測精度も、まだ公表されていない。
 生成式影音與 3D
StateFlowは、オブジェクトのジオメトリ、姿勢、セマンティック状態、カメラを編集可能な3D世界として保存し、動画モデルには視覚的な仕上げを担わせる。30人による実験では動画プリビジュアライゼーションの総合評価が4.5/5に達したが、システムは複数のクローズドモデルに依存しており、コードもまだ公開されていない。
 代理工具
強いモデルから弱いモデルへのテスト時転移実験で、より強力なモデルが、重みを更新することなく固定された小型モデル向けにルーティング、フォーマット検査、決定論的ソルバーを実装した。最良の harness はベースラインの誤りの約83%を修正したが、その成績は規則としてコンパイル可能な心の理論ベンチマークに大きく依存している。
 最新模型
Liquid AIは、31億パラメータのLFM2.5‑VL‑3Bを公開した。画面上の位置特定、レイアウトOCR、複数画像の理解、関数呼び出し機能を備える。公式測定ではApple M5 Maxで228 token/s、H100 1基での高並行スループットは約11,000 token/sを記録したが、データはまだ独立した再現検証を経ていない。
 AI 數學與形式驗證
OEIS Openは、汎用言語モデルに固定予算内で492件の整数列予想を証明または反証させ、当初のSafeVerify評価では147件が合格した。別のLean検証器による再確認では144件となり、形式化ベンチマークが依然として仕様や検証器の違いに左右されることが浮き彫りになった。
 代理工具
IBMのVAKRAは、API、ドキュメント検索、自然言語ポリシーを単一の実行可能な軌跡に統合する。最も高性能なモデルでも、APIインターフェース別の完全正答率は50%〜70.4%にとどまった。ポリシーによって回答不能となる問題では、一部モデルの成功率が2.4%まで低下した。
 最新模型
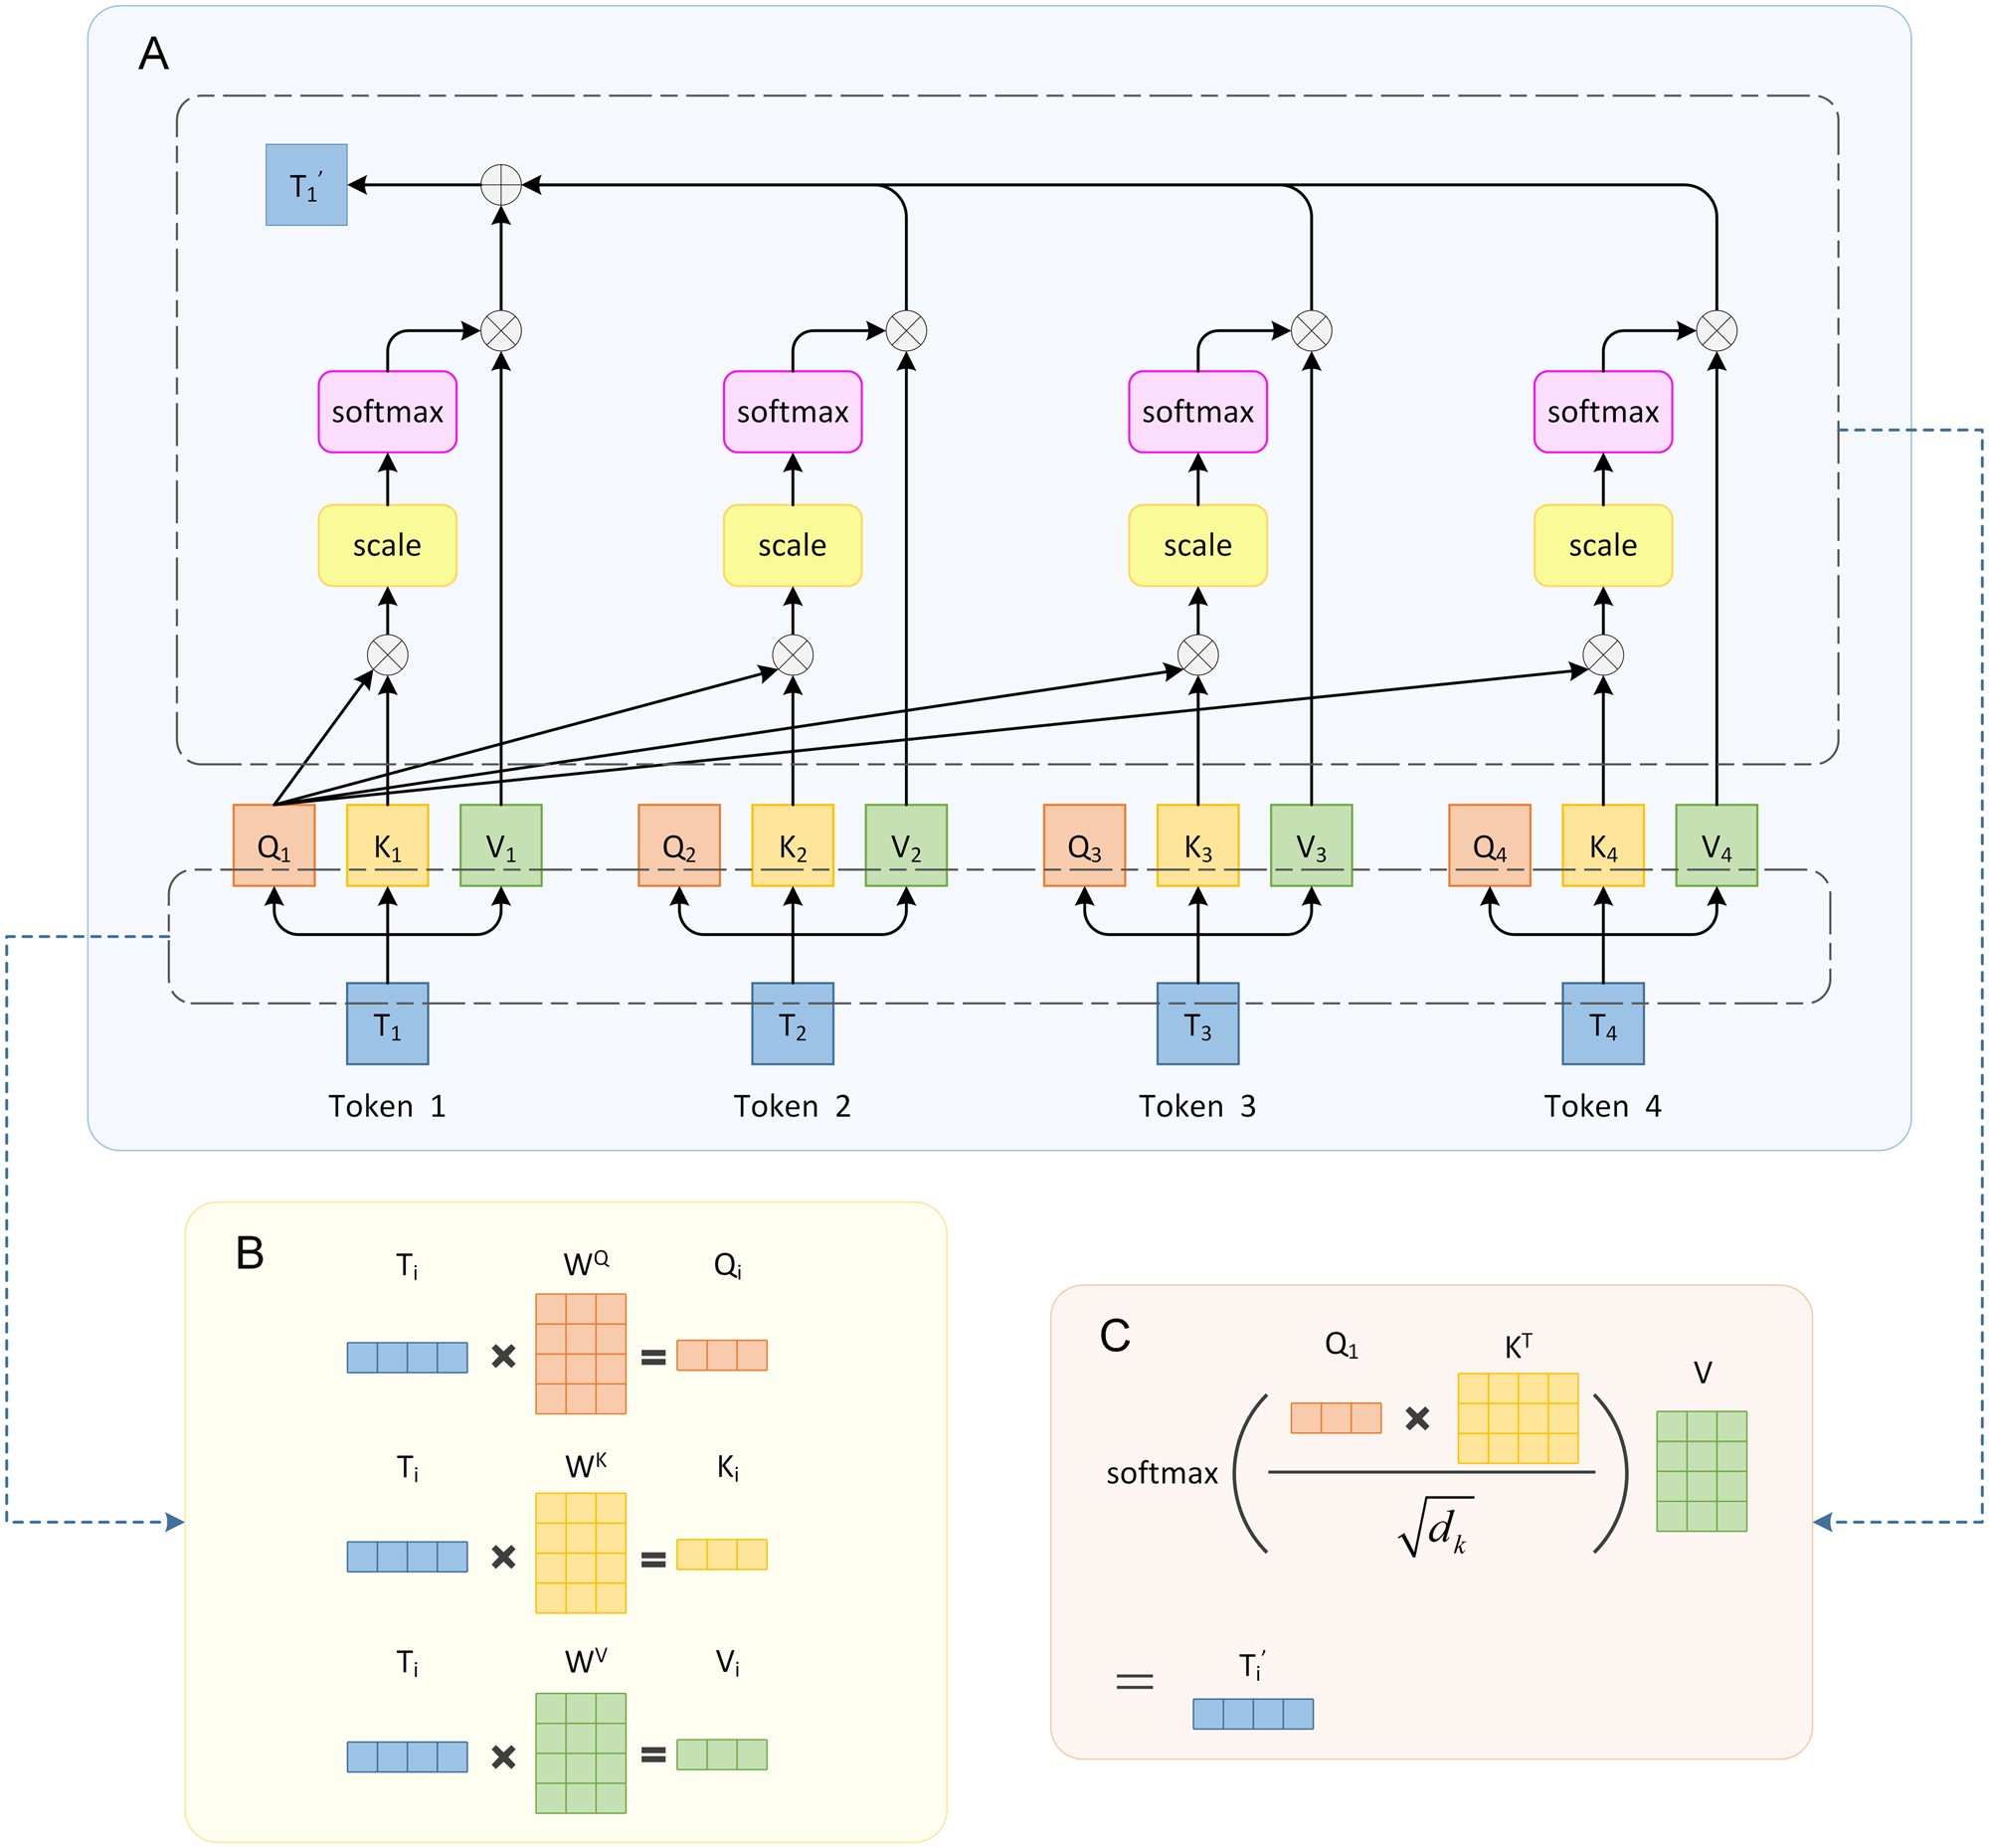
InclusionAIは、線形AttentionとスパースMoEを組み合わせた7.9BパラメータのLing‑3.0‑tinyを公開し、BF16、FP8、INT4の重みを提供している。公式によると、FP8はM4 Proで毎秒86〜90 tokenに達するが、vLLMとOllamaのサポートは現時点で上流の安定版に完全には取り込まれていない。