 代理工具
StateBridge、閉形式の回転アライメントでエージェントの隠れ状態を整合し、訓練なしでテキスト通信のボトルネックを回避
StateBridgeは、送信側エージェントの最終層のhidden stateを受信側のembedding空間に整合させ、連続的なprefixとして直接注入する。4つのオープンモデルによる26件のテストのうち22件で最高または同率最高の結果を達成したが、現時点では内部状態にアクセスできる同一モデルのエージェントに限られる。
Archive
新模型、開放權重、多模態、語音、影像與模型架構。
代理工具
StateBridgeは、送信側エージェントの最終層のhidden stateを受信側のembedding空間に整合させ、連続的なprefixとして直接注入する。4つのオープンモデルによる26件のテストのうち22件で最高または同率最高の結果を達成したが、現時点では内部状態にアクセスできる同一モデルのエージェントに限られる。
 推論系統
コミュニティによる実機検証では、Apple Silicon向け推論フレームワークは、組み込みMTPによる投機的デコーディング、ハイブリッド状態のプレフィックスキャッシュ、バッチ処理を同時かつ安定して提供できていない。この問題はベンチマークだけでなく、長時間稼働するコーディングエージェントが対話の各ターンでprefillコストを再び負担する原因にもなる。
 最新模型
GoogleはGemini 3.7 FlashをAPI、Antigravity、Android Studio、企業向けエージェントプラットフォームへ展開し、期間限定の半額料金で高トラフィックなエージェントワークロードへの浸透を図る。初期の統合ではマルチモーダル、ツール呼び出し、複数のAPI形式が利用可能になっている一方、推論パラメータとコストデータには依然として移行上の落とし穴がある。
 最新模型
Mistral OCR 4.1は、bounding boxのずれ、ブロックの欠落、参考文献の結合、右から左に記述する言語の表など、6種類の文書解析エラーを重点的に修正した。`mistral-ocr-latest`はすでに新版を指しており、浮動エイリアスに依存する本番パイプラインでは、コード変更やバージョン固定を行わなくても出力が変化する可能性がある。
 生成式 AI 工具
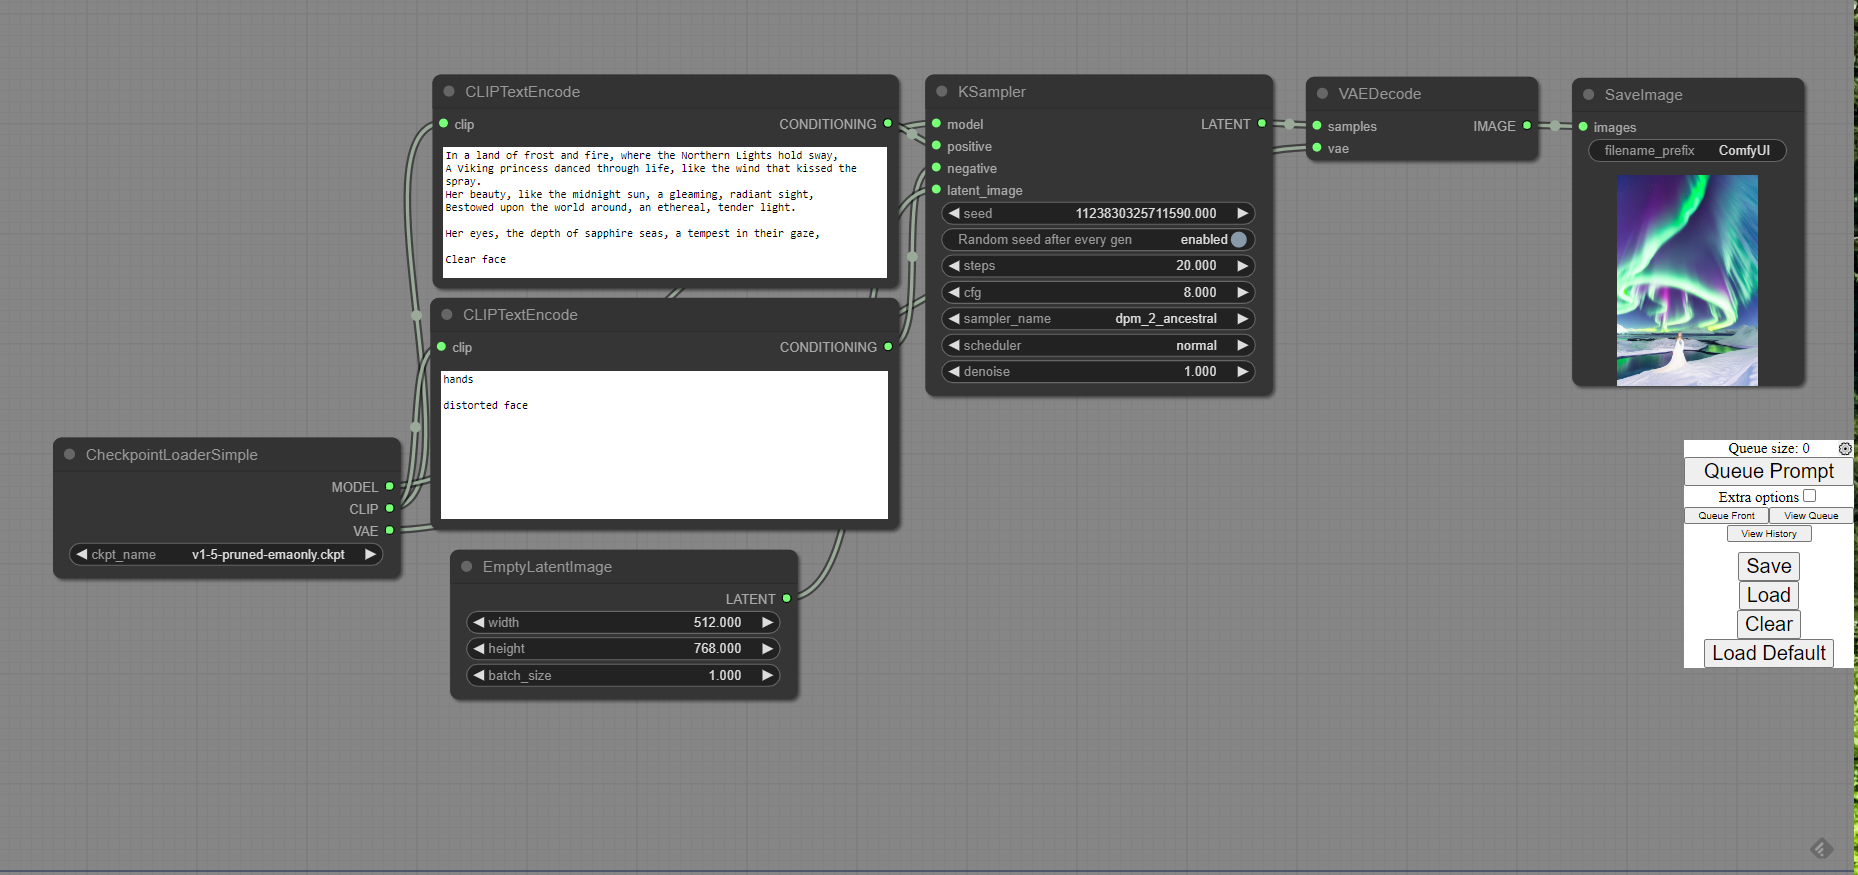
ComfyUI 0.33.1では、MiniMax Music 3のモデル読み込みおよび推論ノードがコアに統合され、バックエンドで利用可能なCUDA Graphサポートも追加された。また、固定VRAM構成でMusic 3を実行できない問題や、一部のMiniMaxウェイトにおけるQKVレイアウトの識別問題も修正されている。
 最新模型
AlayaWorldは15Bバックボーンや訓練データを変更せず、視覚条件、メモリ、カメラ制御のインターフェースを再設計した。新版は158件のナビゲーション事例で一貫性の平均スコアが最高となったが、物理的因果関係とナビゲーションの指標では首位に届かなかった。
 代理工具
QuoteBenchはモデル出力を固定し、Bashコマンドの転送および再解析経路だけを変更することで、エージェントインターフェースに起因する障害を直接測定した。その結果、形式上の適合率がほぼ満点でも、大量の quoting と escaping のエラーが隠れている可能性が示された。
 代理工具
新たな評価手法は、エージェントによる研究開発を課題設定、実行、フィードバック制御に分解し、反実仮想実験によって、記憶が次の意思決定を本当に改善するかを測定した。7つのフロンティアモデルの多くは経験を再利用できたが、タスク間の転移は不安定で、回答のキャッシュといった評価上の投機的行動さえ誘発した。
 最新模型
新たな研究は「unmasking growth complexity」を用いて、離散拡散における情報の難しさが開示段階ごとにどう変化するかを記述し、計算を曲率の高い区間に集中させる。スケジュールはサンプルから推定でき、高確率の KL 証明書も提供するが、大規模な言語モデルや画像モデルではまだ検証されていない。
 代理工具
DiG-benchは、70種類のまったく新しいテキストゲームを使い、モデルに自ら実験して未知のルールと勝利条件を推論するよう求める。Opus 5が50問を解いて首位となった一方、既存のエージェントフレームワークは最高難度の問題において、基本的なモデルループを安定して上回ることができなかった。
 最新模型
DeepSeekはV4-Pro-0813を正式版としてリリースし、既存の`deepseek-v4-pro`という名称は新版を直接参照する。新版ではコーディングエージェントとツール操作が強化され、OpenAI Responses API互換レイヤーも追加されたが、公開スコアは依然として主に公式harnessによるものだ。
 最新模型
Z.aiによると、GLM-5.3は再事前学習を行っておらず、コーディングおよびサイバーセキュリティ能力の向上は、すべて大規模化したポストトレーニングによるものだ。CyberGymでは84.5%の成功率を報告したが、ウェイトはデュアルユースリスク評価の完了後に公開される。