CForce 以後期去噪結果監督早期預測,LLaDA2.1 每次前向處理 token 數由 6.94 升至 9.08
CForce 沿用擴散語言模型自己的生成軌跡,把後期較完整的預測蒸餾回早期遮罩狀態。LLaDA2.1-mini 在提高平行解碼量的同時維持準確度,但證據目前集中於同一模型家族與作者控制的評測。
Archive
新模型、開放權重、多模態、語音、影像與模型架構。
CForce 沿用擴散語言模型自己的生成軌跡,把後期較完整的預測蒸餾回早期遮罩狀態。LLaDA2.1-mini 在提高平行解碼量的同時維持準確度,但證據目前集中於同一模型家族與作者控制的評測。
 最新模型
sMuonは、完全な重み行列に対する直交化方向を、LoRA因子で表現可能な低ランク空間へ射影したうえで、純粋な行列乗算によって更新を計算する。ReLoRA実験ではRiemannionと同じ最低検証損失を達成した一方、複数モデルのファインチューニング結果は、基盤モデルの事前学習に用いられたオプティマイザに大きく依存した。
 代理工具
ScienceFlowは会話の要約を保存するだけでなく、コード、検証エビデンス、リソース記録、ワークスペースのスナップショットを、復元可能なStageとしてパッケージ化する。公式報告では、MLE-bench全75問でAny-Medal率70.22%を達成したが、システム間の比較は依然としてモデル、ハードウェア、時間予算の違いに左右される。
 推論系統
新版では量子化ブロックのサイズに応じてスレッド数とワークグループ数を設定し、SYCL copy kernelの過剰または不十分なサブスクリプションを回避。Arc 70のマイクロベンチマークではスループットが20.21 GB/sから158.19 GB/sに向上したが、これはモデル全体のtoken生成速度が同じ比率で向上することを意味しない。
 最新模型
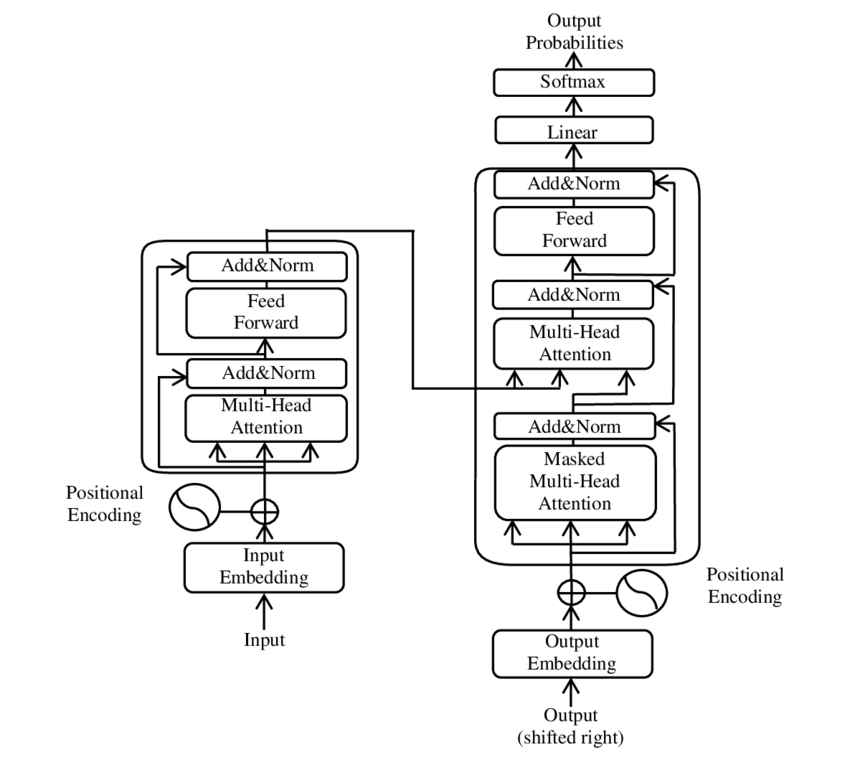
Intern-S2-Mobiusは、従来のTransformerで各層に結び付いていた知識ストレージと注意機構による推論を分離し、複数のReasonerが同一のグローバルMemoryを繰り返し参照できるようにする。オープンウェイトはLMDeploy、vLLM、Transformersで読み込めるが、約4倍という高速化は、あくまで公式の特定ベンチマークにおける結果だ。
 最新模型
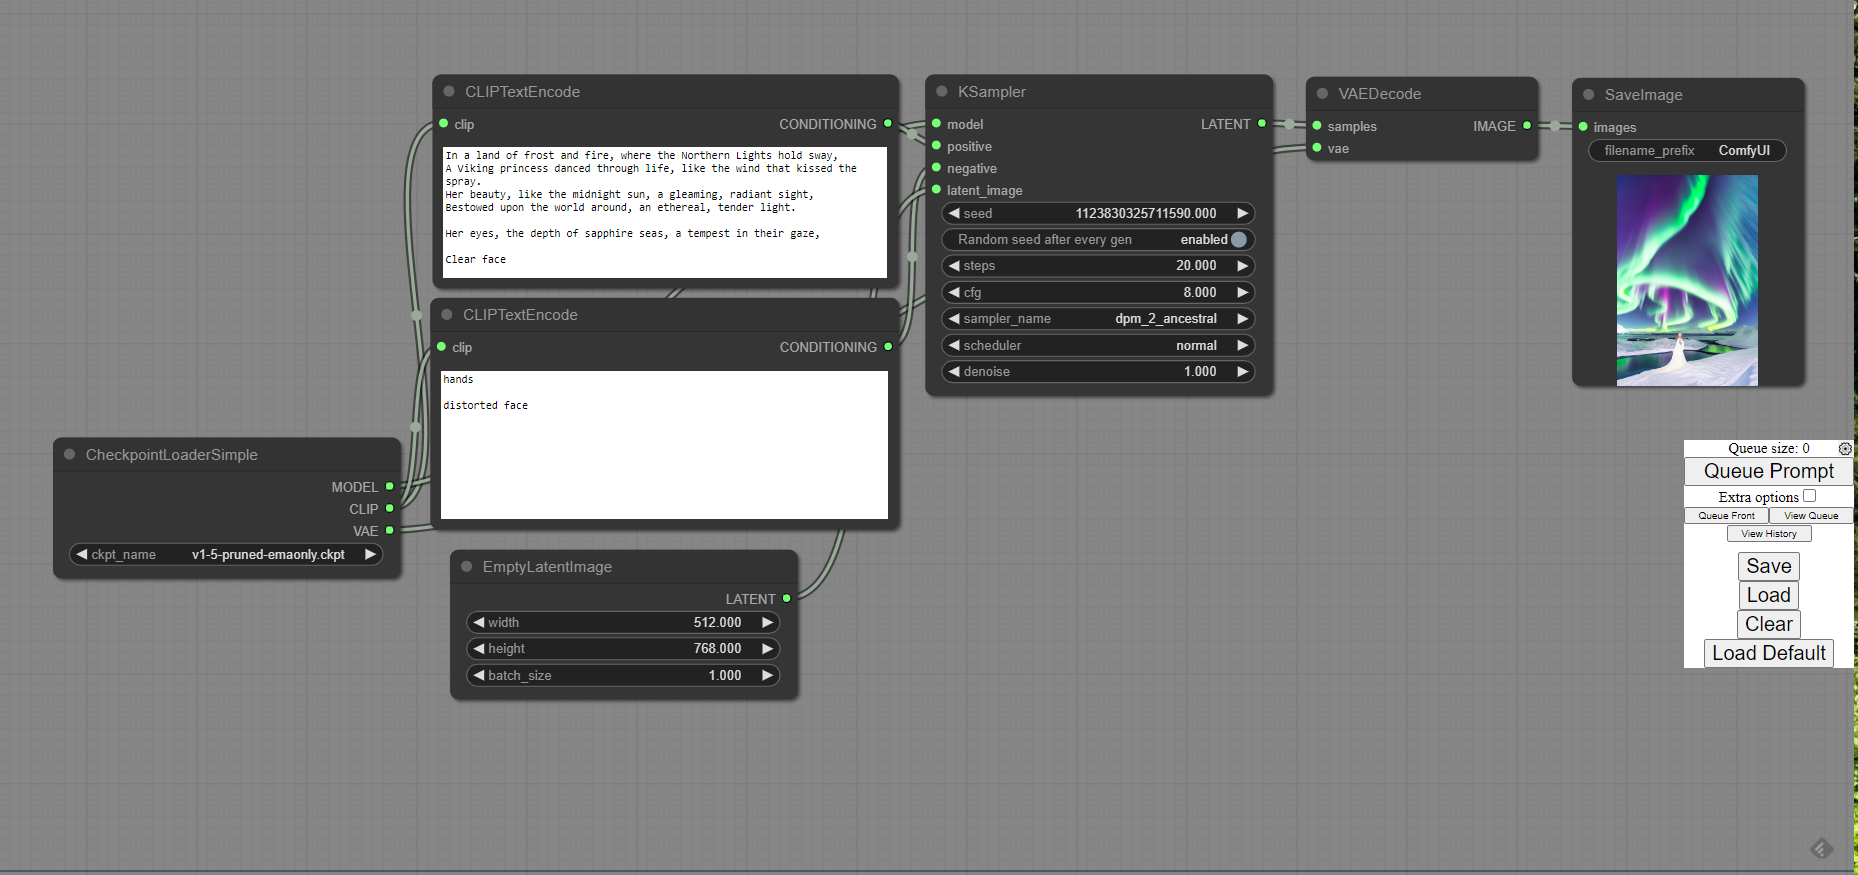
コミュニティが動画モデルMiniMax H3向けに5.21GBの単一フレームVAEを学習し、reference-to-videoパイプラインで1フレームのみを生成して、衣装変更、ポーズ変更、視点変換を実行できるようにした。この手法は、動画モデルを画像編集モデルとして再利用できる可能性を示す一方、現時点では非公式の重み、特定のワークフロー、まだ完全には実装されていないComfyUIの単一フレームインターフェースに依存している。
 最新模型
QwenはQwen3.8-27Bの重みを公開した。64層のGated DeltaNet/Gated Attentionハイブリッド構成によって長大なコンテキストのコストを抑えつつ、ネイティブな視覚理解と調整可能な推論深度を提供する。公式のエージェント評価では大幅な向上が示されているが、一部のデータセット、修正版の問題、実行フレームワークはQwen自身が設定しているため、ベンダー横断の公平なランキングと直接見なすことはできない。
 推論系統
FreeBalanceは前層の残差状態から次層のエキスパート負荷を予測し、重みの交換とattention計算をオーバーラップさせる。最終的なルーティングやモデル出力は変更しないが、現時点での検証範囲は2つのMoEモデル、単一の8 GPUトポロジー、prefillワークロードに限られる。
 代理工具
TWINでは、エージェントがまず未知の環境を実行可能なPython世界モデルとして記述し、過去の履歴を完全に再現できた場合にのみ、実環境での行動を許可する。同一の基盤モデルによるARC-AGI-3のスコアは、直接操作時の7.8から93.3へ向上した。
 AI 安全
Anthropicは、対応する新しいClaudeモデルがテキスト生成時に不可視のシグナルを埋め込み、生成ファイルには署名ベースの来歴データを付加できると説明した。一方で、短文、書き換え、翻訳は検出精度を低下させ、シグナルが見つからなくてもClaudeによる生成を否定できないと警告している。
 AI 基礎設施
Groqは8月16日、FreeおよびDeveloperプランで2つのLlamaエンドポイントを廃止した。現在、旧モデルIDを使用するとエラーが返される。公式はGPT-OSSまたはQwenへの移行を推奨しているが、モデルファミリーをまたぐ移行となるため、ツール呼び出し、構造化出力、プロンプトの挙動を改めて検証する必要がある。
 推論系統
DeepSeekはV4 FlashとProに時間帯別料金を導入し、ピーク時間帯の価格をオフピークの2倍に設定した。最も大きな影響を受けるのは通常の入力ではなく、長い会話やコーディングエージェントで大量に使用されるキャッシュヒットtokenだ。