 資訊檢索/RAG
DEPT、文書ベクトルを固定したままクエリ拡張をエンドツーエンドで学習、Qwen3-4BのBEIR平均スコアが42.59に上昇
DEPTは、同一のデコーダーでクエリ拡張の生成と文書のエンコードを同時に行い、保存損失によって既存のベクトルインデックスがファインチューニングに伴ってドリフトするのを防ぐ。5つのBEIR評価で段階的なベースラインを上回ったが、結果は依然として1回の実験と2つの小型モデルに基づく。
Archive
新模型、開放權重、多模態、語音、影像與模型架構。
資訊檢索/RAG
DEPTは、同一のデコーダーでクエリ拡張の生成と文書のエンコードを同時に行い、保存損失によって既存のベクトルインデックスがファインチューニングに伴ってドリフトするのを防ぐ。5つのBEIR評価で段階的なベースラインを上回ったが、結果は依然として1回の実験と2つの小型モデルに基づく。
 最新模型
OYSはモデルの変更や蒸留を行わず、ベイズ最適化によってモデルとタスクごとに少ステップのノイズ除去スケジュールを探索する。研究では6種類のtext-to-imageモデルと画像修復タスクで改善が報告されたが、探索コストを多数の事前生成サンプルによって償却する必要がある。
 代理工具
Alibaba Cloudチームは、ブラウザエージェントのエラー回復、複雑なUI操作、長期的な信用割当を単一の訓練パイプラインに統合した。27Bモデルは、新たに構築された中国語・英語バイリンガルのBrowserBenchでPass@1 65.1%を達成したが、モデルの重みと評価データが一般公開されているかどうかは、依然として確認が必要だ。
 推論系統
Qwen3.8-27B 讓 27B 級模型進入單張 24GB 消費級 GPU 的可用範圍。公開資料顯示,一般 GGUF 部署約落在 30 至 60 tok/s;在 RTX 4090 上啟用 KV cache 量化、MTP 與新版 llama.cpp 後,社群實測可提升至 70 至 85 tok/s,但這仍不是開箱即得的基準。
 推論系統
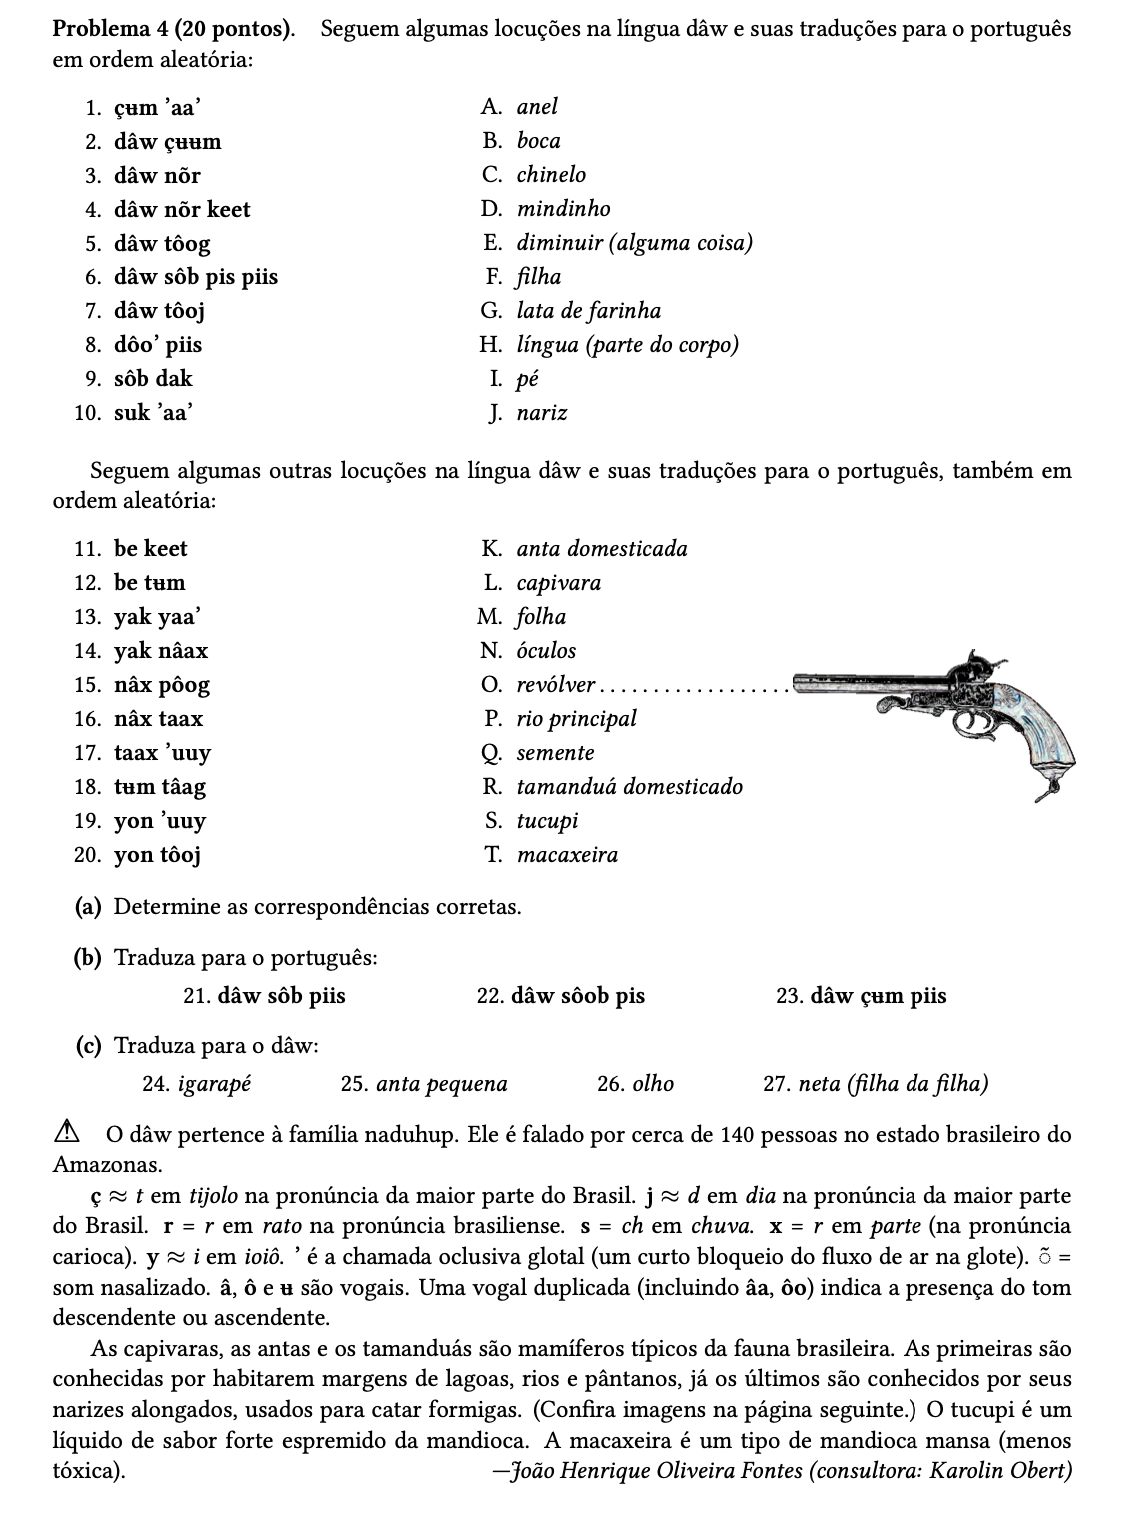
IOL-AI Challengeでは、少数の例から未知の言語の規則を導き出し、翻訳、転写、訂正を行うことがシステムに求められる。T4 GPU 1基という制約下で、最高提出は同一モデルのベースラインGMを9.40から19.79へ引き上げたが、金メダル水準に達したクローズドモデルとの差は依然として大きい。
 AI 安全
PACEは、取引が安全かどうかを言語モデル自身に判断させるのではなく、取引意図、シミュレーション結果、実際のcalldataを決定論的ルールで検証する。署名済みのPolicy Decision Recordは実行前にスマートアカウントによって再検証されるが、現時点で失敗ゼロという結果が得られているのは、単純化されたDeFiサンドボックスに限られる。
 AI 安全
Google DeepMindの研究では、同一のGemini方策に問題解決者と批評者の役割をそれぞれ担わせ、より弱い凍結モデルに判定させた。ディベートは判定モデルの識別能力を維持し、RLVRとの差の約45%を取り戻したが、より多くの訓練ステップと批評文の長さ制限を必要とした。
 推論系統
NVIDIAはTensorRT Model Connectをオープンソース化した。2つのコマンドで、サポート対象のHugging Faceモデルまたはローカルcheckpointを、C++アプリケーションに引き渡せるバージョン管理されたbundleとしてビルドできる。モデル移植の工程を短縮する一方、現時点ではreference implementationという位置付けであり、対応範囲と性能はモデル、精度、ハードウェアごとに検証する必要がある。
 硬體
PTXBenchは、生成されたカーネルの正確性、指定された命令が実際に実行されたか、さらにcuBLAS、cuDNN、FlashInferに対する速度を同時に検証する。その結果、新アーキテクチャ向け命令を生成できても、それを実効的な高速化につなげられるとは限らず、特にB200のAttentionカーネルが難しいことが示された。
 推論系統
Qualcomm AI Researchは、凍結したTransformerの各層に高速重みを追加し、コンテキストを512-token単位で取り込む手法を開発した。クエリ時に原文を再読み込みする必要はない。Qwen2.5-0.5Bを用いた128Kの実験では、メモリ使用量を一定に保ちながらICLとRAGを上回ったが、現時点でのエビデンスは3つの合成検索タスクに限られる。
 最新模型
TokEvalは、数値の桁位置、プログラムのAST境界、UTF-8の完全性、言語間コストをtokenizer評価に導入した。対照実験では、一部の指標が特定の下流能力を予測できることが示されたが、現時点の結果は単一の1.27Bアーキテクチャに限られる。
 代理工具
MicrosoftはAgent Lightningを全面的に書き直し、モデルAPIのプロキシ層を通じて既存のエージェントフレームワークの完全なインタラクションを取得できるようにした。ツールループをトレーニングエンジンへ移植する必要はない。公式発表によると、6,000件のデータでQwen3.5-9Bを訓練し、SWE-bench Verifiedのスコアを41.8%から56.4%へ向上させた。