 硬體
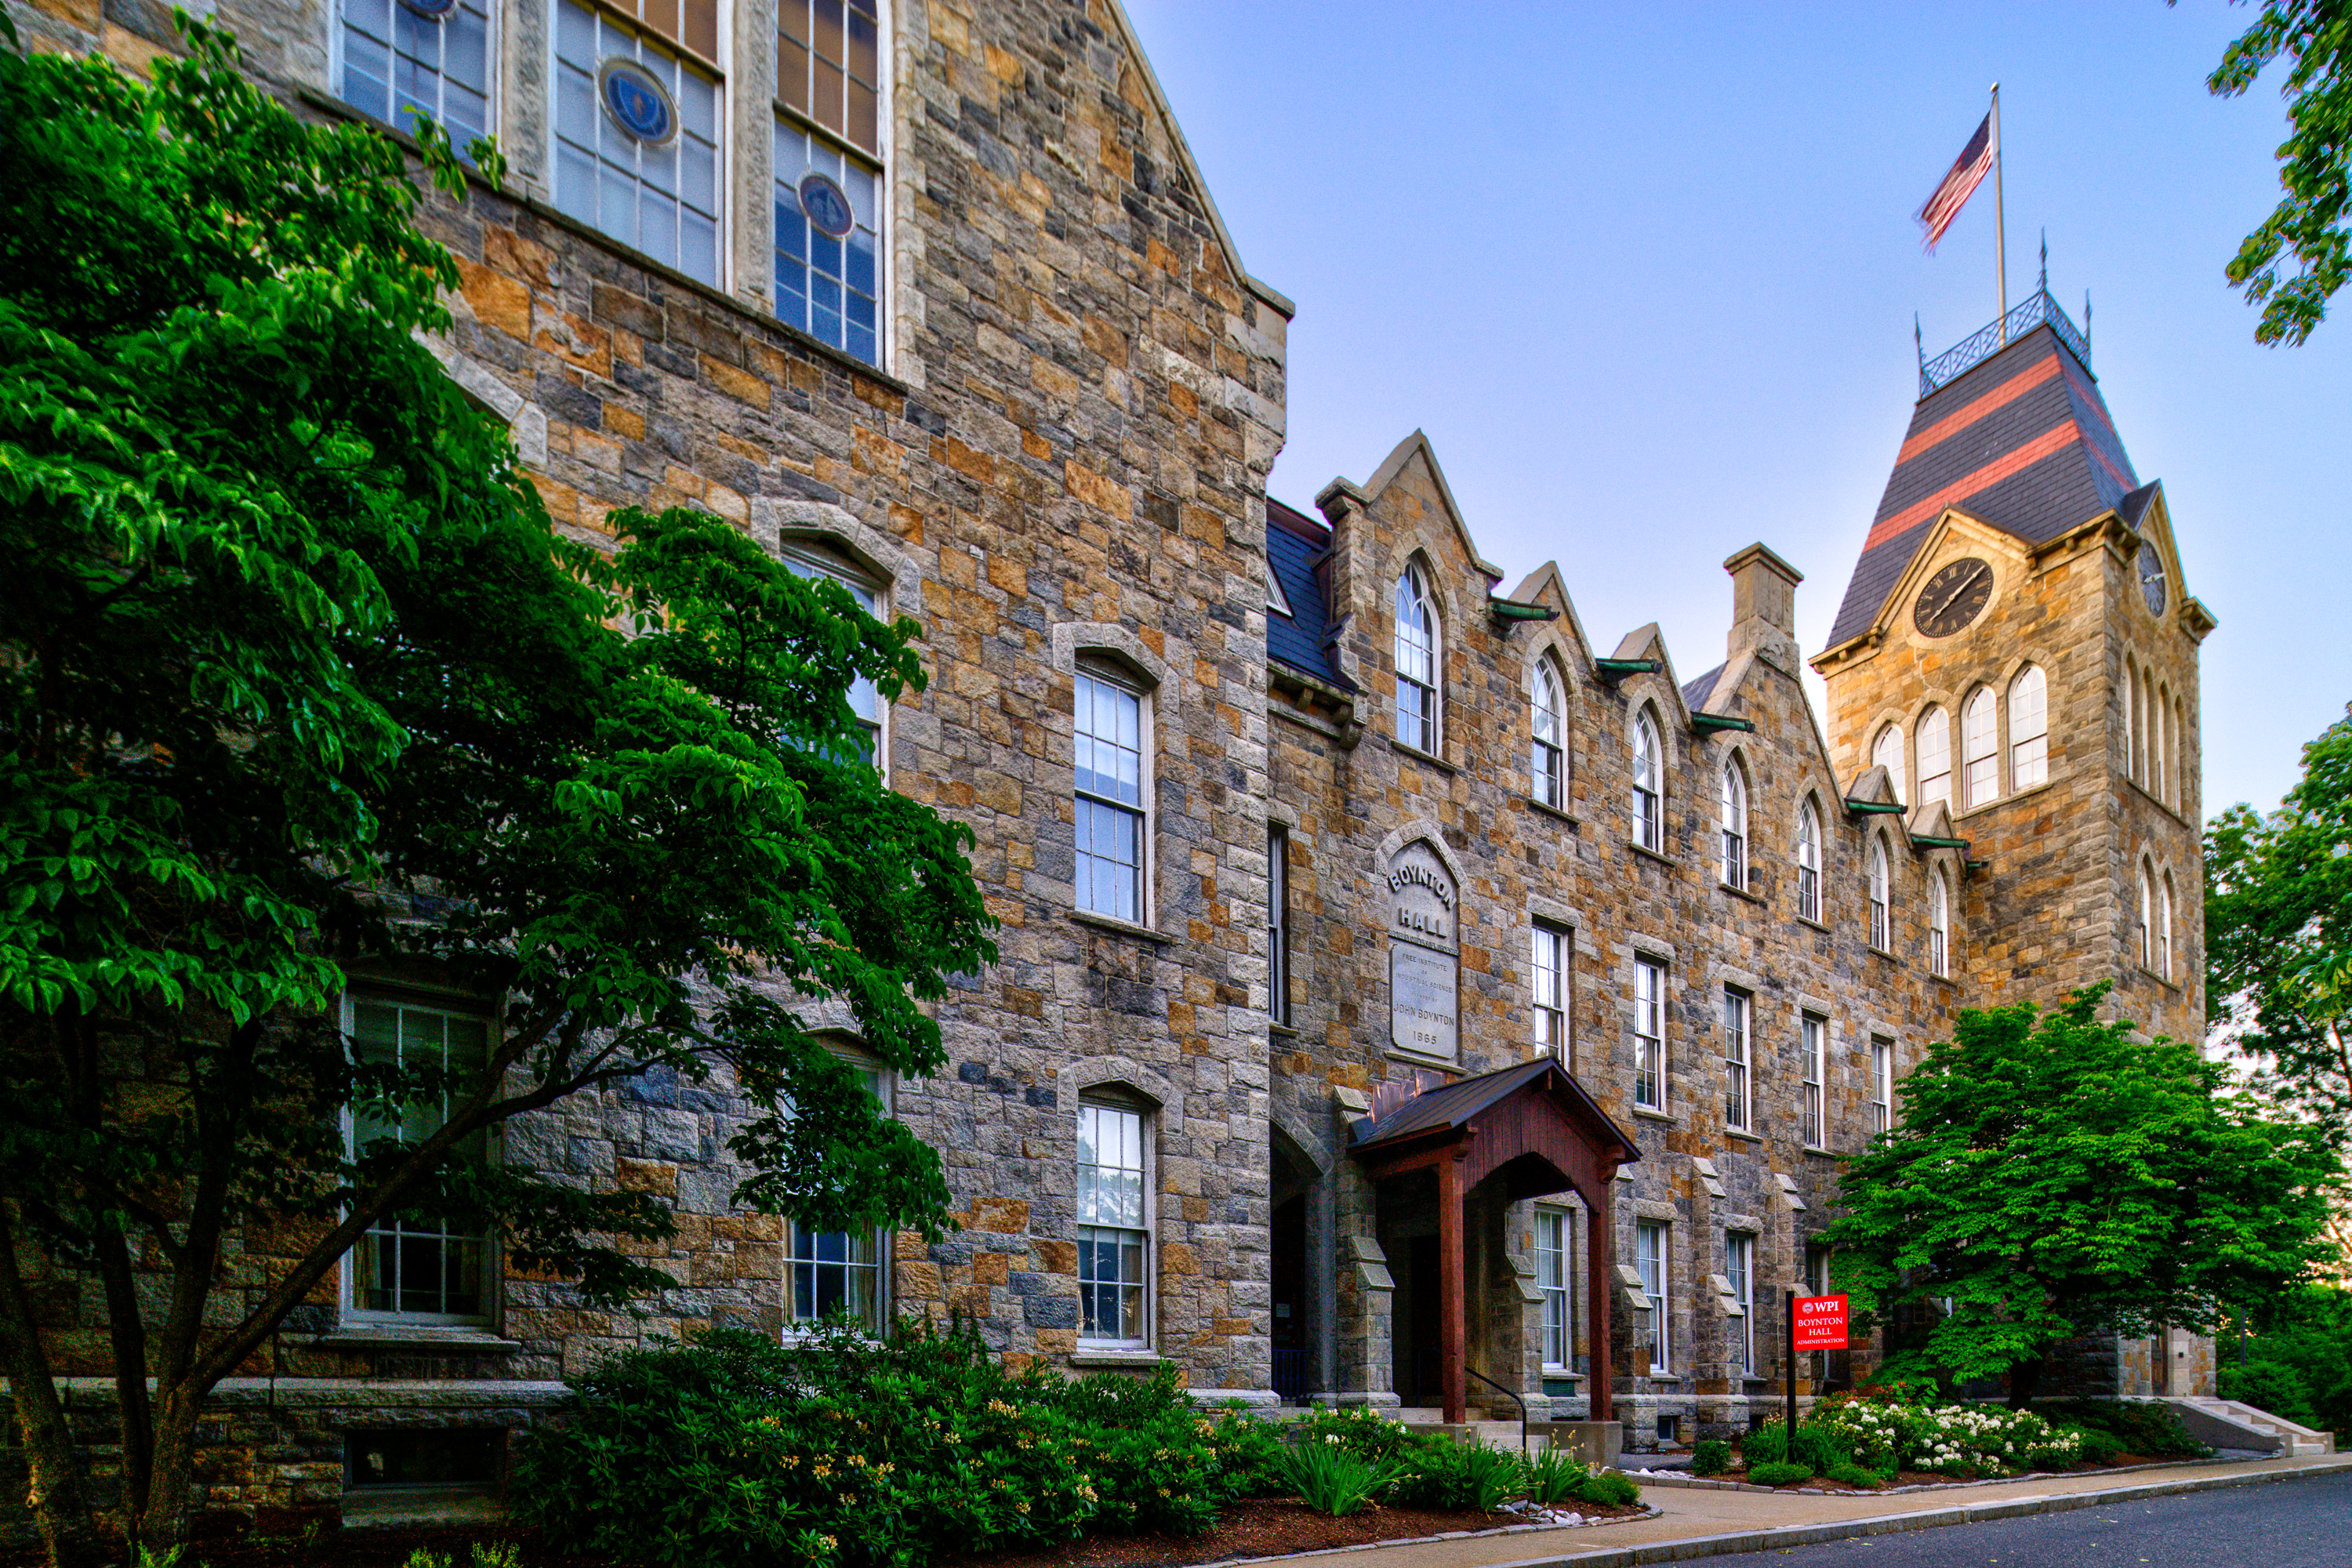
LLMscope、レーザー電圧イメージングでFPGA上のモデル重みと推論状態を読み出す
WPIの研究チームは、FPGAのレジスタとブロックRAMから、量子化された重み、activation、その他のLLM資産を復元する手法を実証した。この攻撃にはチップへの物理アクセスと再現可能な状態が必要であり、実験では商用の大規模モデル全体を抽出したわけではない。
Archive
新模型、開放權重、多模態、語音、影像與模型架構。
硬體
WPIの研究チームは、FPGAのレジスタとブロックRAMから、量子化された重み、activation、その他のLLM資産を復元する手法を実証した。この攻撃にはチップへの物理アクセスと再現可能な状態が必要であり、実験では商用の大規模モデル全体を抽出したわけではない。
 最新模型
新たなフレームワークでは、coding agentがルールと長期的な帰結を管理し、状態を深度およびセマンティックproxy videoへコンパイルして、MiniMax-H3による映像生成を制約する。プロトタイプでは5組の制御されたシーンが示されたが、定量ベンチマーク、アブレーション実験、リアルタイム生成結果は提示されていない。
 最新模型
Z.aiは、初のネイティブ・マルチモーダルGLM-5モデルを公開した。総パラメータ数320Bのうち、各回でアクティブになるのは18Bのみで、最大100万tokenをサポートする。公式測定では、GLM-5.3と比べてアテンション演算量を3分の1、KV cacheを4.4分の1に削減したとしているが、性能とコストは依然として主にベンダー自身による評価に基づく。
 最新模型
ByteDance Seedの手法は、最終時点の報酬をすべてのノイズ除去ステップへ直接適用する代わりに、報酬勾配を用いて正例・負例のクリーン画像予測目標を構築する。2種類のバックボーンによる20組のペア比較のうち19組で最高性能を達成したが、結果は依然として主に自動報酬モデルと著者自身による測定に依存している。
 推論系統
新版ではDecode Context Parallel、融合FlashKDAカーネル、適応型speculative token予算も導入され、DeepSeek V4の疎なMLAが通常デコードとspeculative decodingの両方で利用可能になった。一部の速度値は個別カーネルまたは特定のDSpark構成のみを測定したものであり、アップグレード前にはデフォルト値とプラグインインターフェースの破壊的変更にも対処する必要がある。
 最新模型
GlanceWAMは約3秒ごとにバックグラウンドで未来映像の潜在表現を生成し、複数の0.8秒アクションチャンクで再利用する。論文ではRoboCasaで72.2%の成功率を報告しているが、現時点のエビデンスは依然としてシミュレーション環境と著者による独自計測に集中している。
 代理工具
AlibabaのMAIチームは、変動するアプリケーションデータベース、権限エラー、ツール依存関係を用いてモバイルの中央プランニングエージェントを評価し、静的なfunction callの照合から脱却した。最高性能のモデルはツールの直接利用に強い一方、メモリの適用とエージェント間連携では依然として大きく後れを取っている。
 AI 安全
新たなベンチマークは、脆弱性を含む完全なプログラム、ファジングインターフェース、sanitizerをオフラインのDockerイメージに封入し、再現可能かつ互いに異なるクラッシュシグネチャに基づいて採点する。この設計ではモデルが偶然発見した欠陥も評価対象にできるが、現行の難易度係数は評価対象と同じモデル群から算出されており、ランキングには依然として循環性がある。
 代理工具
NVIDIA は COMPASS にエージェント駆動型ワークフローを追加し、coding agent が環境の検証、シーンの準備、residual policy の訓練、checkpoint の比較を支援できるようにした。エージェントが担うのは開発オーケストレーションのみで、実際のナビゲーションはエクスポートされた視覚ポリシーと ROS 2 コントローラーが実行する。
 代理工具
京都大学の研究チームは、4カ月間の実環境への導入を通じてMemUseを構築し、「記憶を取り出せるか」と「適切な応答で記憶を使用するか」を分けて評価した。その結果、記憶容量の拡大は直接QAを明確に改善する一方、自然な統合率や全体的な満足度の向上にはつながらなかった。
 AI 安全
上海人工知能研究所などのチームが、4BパラメータのStepGuardを発表した。安全/危険な軌跡のペアとBalance-GRPOを用いて、過剰なブロックと見逃しを調整する。2つのエージェント環境で攻撃成功率を大幅に低減した一方、訓練コーパスとデータ生成器はまだ公開されておらず、規範上の違反も見逃すことがある。
 推論系統
SemiAnalysisは、長いコンテキスト、マルチターン、サブエージェントの並行実行に対応するAgentXを公開した。これにより、推論システムの比較は、固定長プロンプトのスループットだけに依存しなくなる。データはリクエストのタイミングとKV cache再利用の形状を保持しているが、ソースはClaude Codeに集中しており、測定対象はプログラミングタスクの正答率ではなく、サービングシステムの効率である。