 AI 研究
WISE 重用遞迴模型注意力範圍,注意力流程測得 1.36 倍加速
方法保留全部遞迴步驟,透過早期探索縮小後續注意力運算範圍。效能數字僅涵蓋注意力負載,4K 上下文的品質下降與公開重現材料仍須核對。
Archive
推論 runtime、量化、 serving、KV cache、成本與效能。
AI 研究
方法保留全部遞迴步驟,透過早期探索縮小後續注意力運算範圍。效能數字僅涵蓋注意力負載,4K 上下文的品質下降與公開重現材料仍須核對。
 推論系統
實作以單次 Pallas 呼叫串起 92 層,透過跨層預取權重提高記憶體頻寬利用率。官方比較限於特定拓撲與小批次,推測解碼成績也取決於草稿接受率。
 GitHub Repo
新版同時封裝 Intel 與 Apple Silicon 所需的 Node.js、uv,啟動時依架構選取。桌面版仍屬早期預覽,完整代理流程與後端設定須在實際環境驗證。
 GitHub Repo
新路徑重用 ggml Metal 核心,讓量化權重留在 Transformers 流程中執行。功能目前須從主分支安裝,模型覆蓋、批次處理及核心相容性仍有限制。
 推論系統
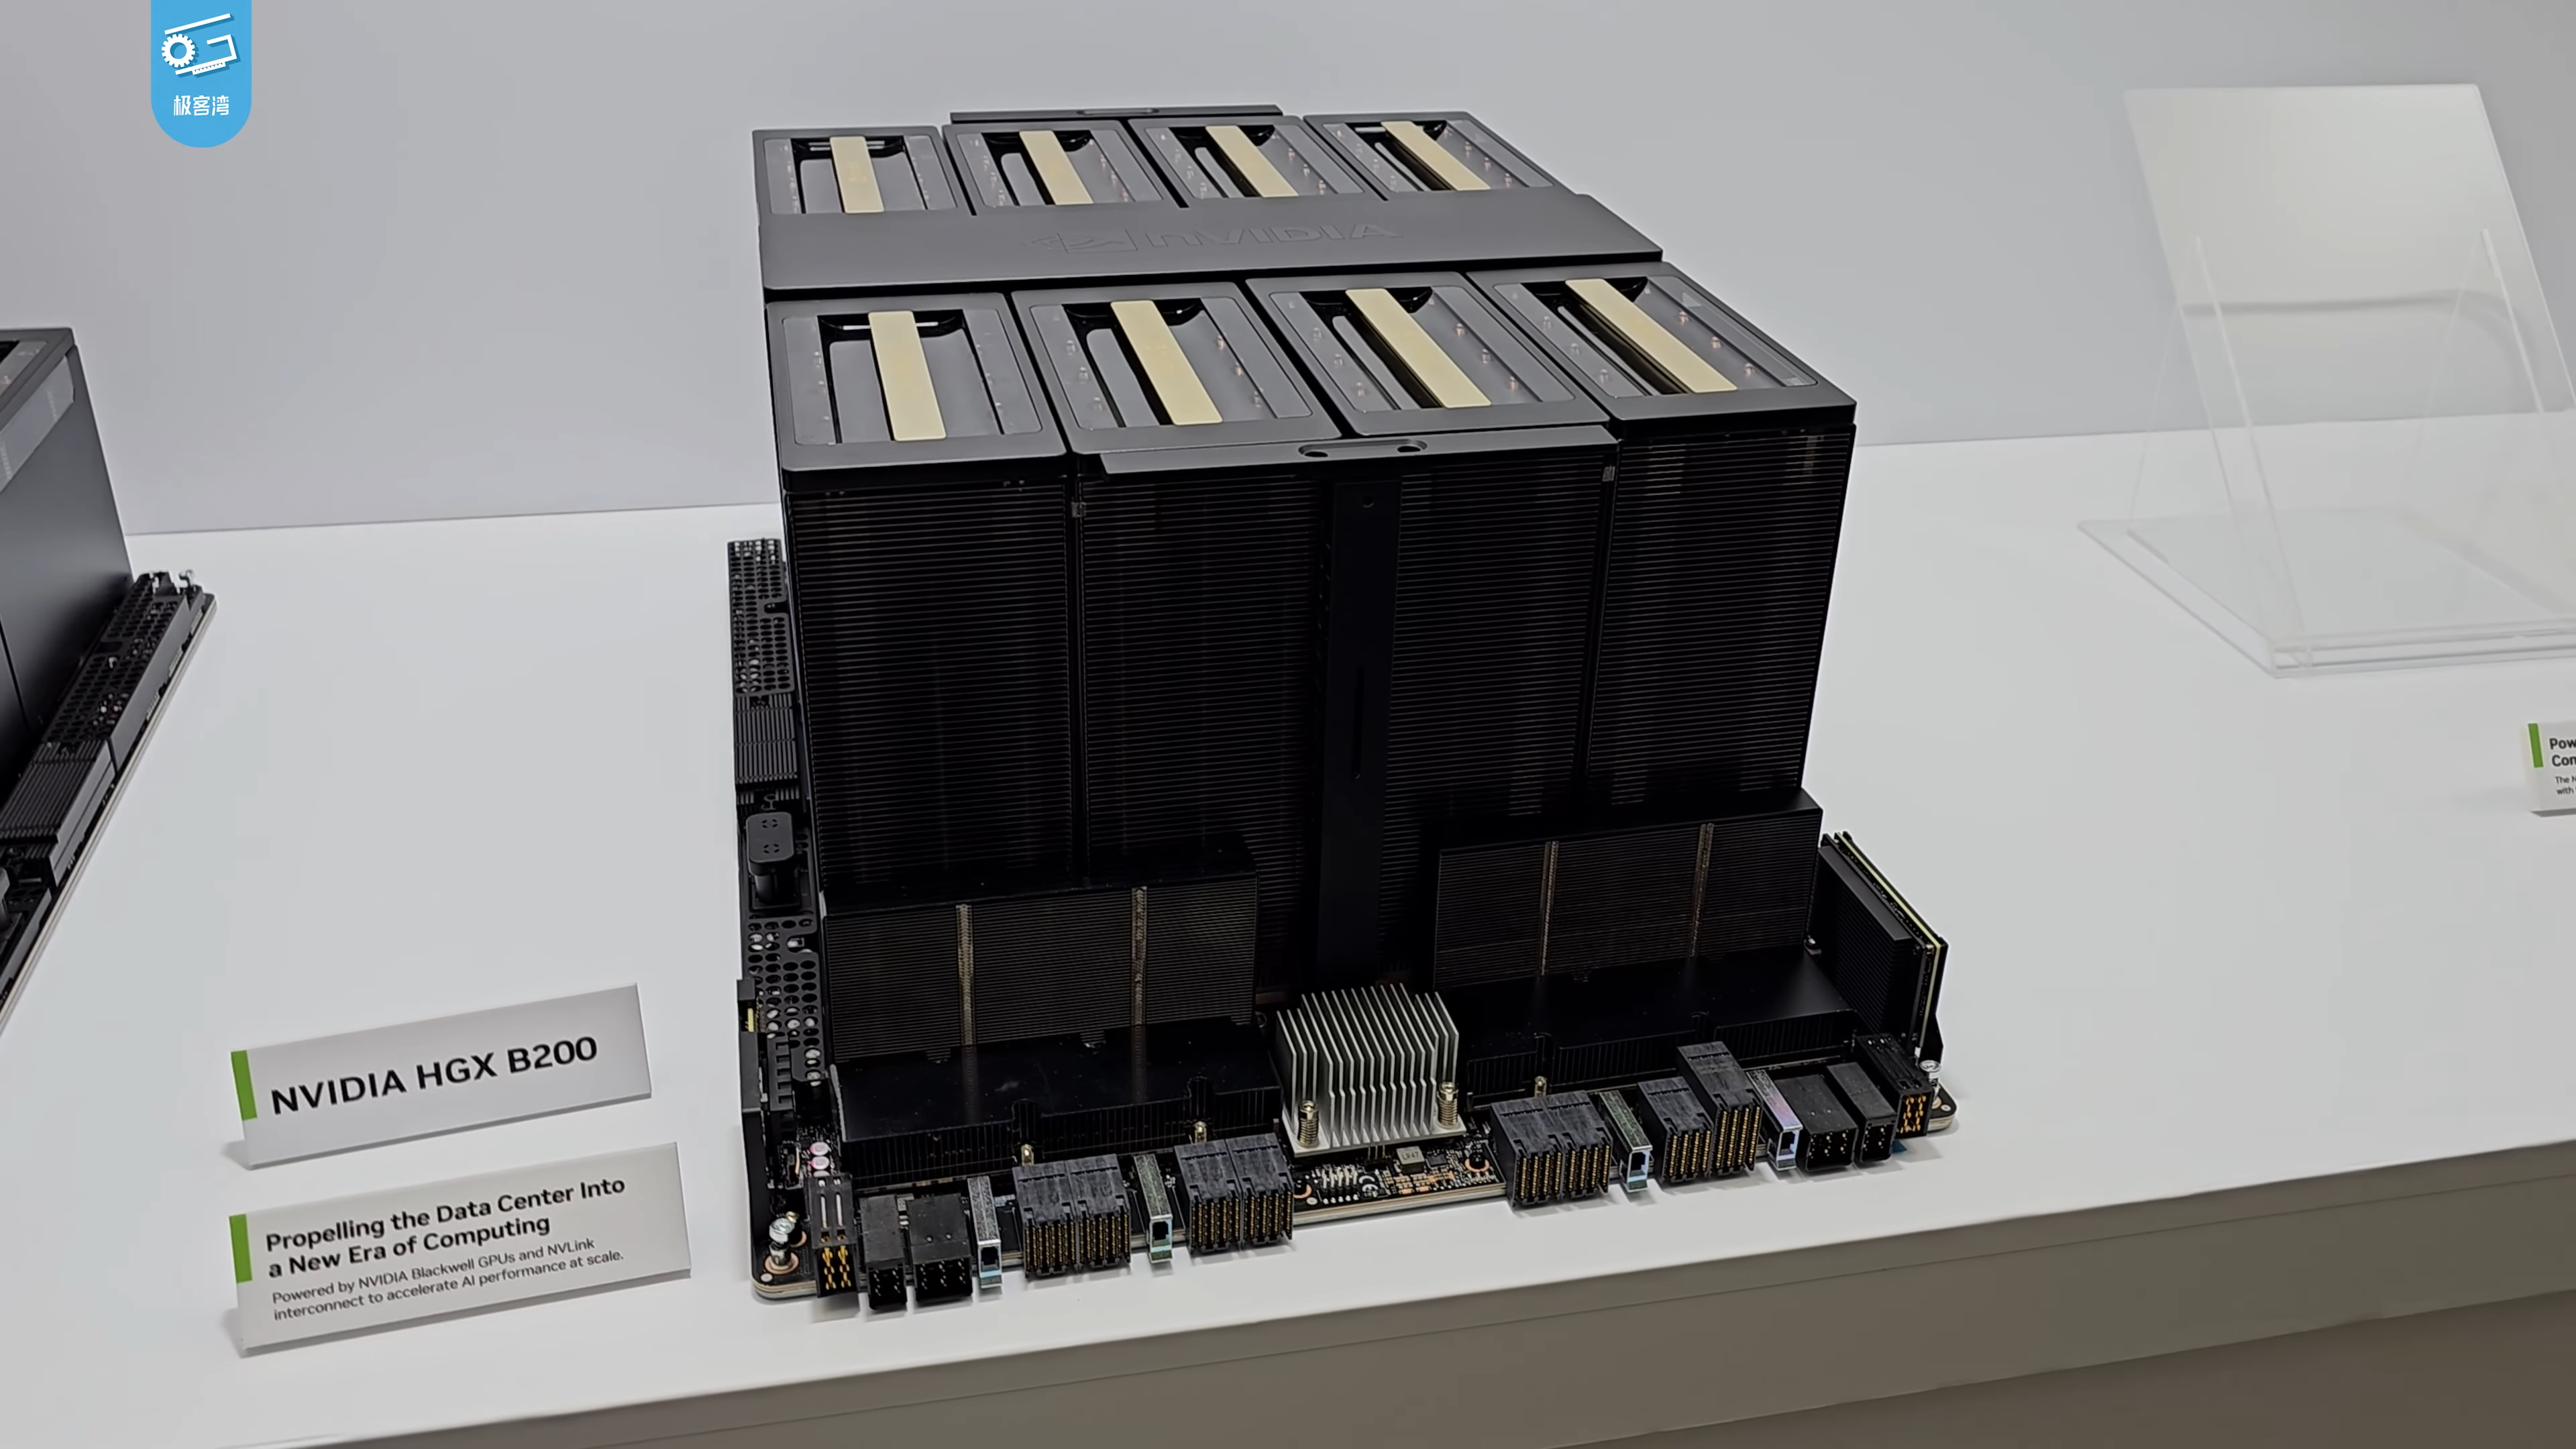
八張 B200 執行 DeepSeek-R1 的測試顯示,機密運算下平均每 token 延遲增幅低於 5%。結果依賴記憶體搬移、核心計時與多卡通訊調整,仍須按實際服務負載重驗。
 推論系統
新文章整理八張 MI350X 上的推論測試流程,數據採集於七月。指定提交的 README 與文章負載不同,各引擎設定差異也限制效能比較。
 AI 安全
漏洞涉及預填充/解碼分離節點的 RPyC 服務,攻擊者須能連上控制埠。公開重現顯示利用後健康檢查仍可正常,公告尚未列出已修補版本。
 推論系統
Physical AI Toolchain 新增遠端 GPU 推論部署,提供兩種機械臂範例。既有研究顯示,額外延遲與影像頻寬可能抵銷運算收益,部署須評估完整控制流程。
 AI 研究
新基準以 53 項 SGLang 任務評測程式代理,發現部分通過其他檢查的修補仍無法正常提供模型服務。結果限於特定測試環境,通過基準也不代表程式已可上線。
 GitHub Repo
Hugging Face 結合 SIMD 切分、暫存重用與快取,降低文字編碼成本。測速限於特定分詞負載,Python 呼叫開銷與完整服務效益仍須另測。
 最新模型
模型提供 DROID 與 SO-101 權重及微調流程,RoboLab 公開榜單列出約 42.9% 成功率。控制迴圈仍須由應用程式處理,規劃涵蓋時間不能當成推論延遲。
 AI 研究
研究限制修改規模,並以評測波動與推論成本篩選代理框架的變更。公開實作提供重驗入口,但節省 token 的幅度取決於比較基準。