 最新模型
SGLang 0.5.16 以信心動態調整推測驗證長度,並重整混合架構快取
SGLang 新版加入 DSpark,依草稿模型信心改變每輪驗證窗口,並把 UnifiedRadixTree 設為滑動窗口、Mamba 與稀疏注意力模型的預設快取。版本也移除數條量化後端及更改 rollout 傳輸格式,升級現有服務前必須檢查相容性。
Archive
推論 runtime、量化、 serving、KV cache、成本與效能。
最新模型
SGLang 新版加入 DSpark,依草稿模型信心改變每輪驗證窗口,並把 UnifiedRadixTree 設為滑動窗口、Mamba 與稀疏注意力模型的預設快取。版本也移除數條量化後端及更改 rollout 傳輸格式,升級現有服務前必須檢查相容性。
 最新模型
NVIDIA 公開以少步擴散、自生成歷史蒸餾及串流 KV 快取打造的手術機器人生成式模擬器。系統已能即時接收機器人運動資料並合成下一段畫面,但視覺逼真度仍不能替代物理正確性及臨床驗證。
 最新模型
inclusionAI 開放 100B 級 LLaDA2.2-flash,以 Levenshtein Editing 讓平行解碼可插入、刪除及替換內容。模型在部分代理測試與吞吐上勝過自家自回歸基線,但程式修復與函式呼叫準確率仍落後,服務支援也尚未齊備。
 推論系統
vLLM 0.26 讓不同 KV-cache 群組選用各自的注意力後端,並把物件儲存納入分層快取。新版也集中最佳化 DeepSeek-V4、ROCm、XPU 與推測解碼,但官方微基準不能直接代表實際服務吞吐。
 推論系統
Nativ v0.0.1 把模型下載、聊天、監控及 OpenAI、Anthropic 相容端點整合進原生 SwiftUI 應用,近期在本機 AI 社群獲得關注。首版僅支援 Apple Silicon 與 macOS 26,且尚未公布跨模型效能或相容性測試。
 推論系統
AMD 釋出 ROCm Hyperloom 1.0.0a1,讓代理從效能剖析一路執行核心與主機程式修改,再以正確性及速度測試決定是否保留變更。首版只支援三款 Instinct GPU,且「數週縮至數小時」仍是官方說法,導入者需要以自身模型重現。
 AI 研究與訓練
新研究不再替每道題固定生成相同數量的推理軌跡,而是把額外運算集中到獎勵分歧較大的樣本。作者在數學與程式任務上報告更高的 rollout 效率,但尚未公開程式碼,實際 GPU 時間與大模型擴展性仍待驗證。
 最新模型
AMD 釋出 Instella-MoE 的預訓練、長上下文、SFT、DPO 與強化學習等六階段檢查點,並同步公開訓練框架、資料配方及推論程式。模型以 Gated MLA 和 FarSkip-Collective 降低注意力與跨 GPU 通訊成本,但正式技術報告及獨立評測仍未完成。
 最新模型
UK AISI 與美國 CAISI 的初步測試顯示,Kimi K3 在 ExploitBench 得分 32%,高於 GLM-5.2,卻明顯落後受測的美國前沿模型。模型也曾完成一次 32 步模擬企業攻擊,但評測條件與樣本有限,不能直接推論真實世界的攻擊成功率。
 硬體
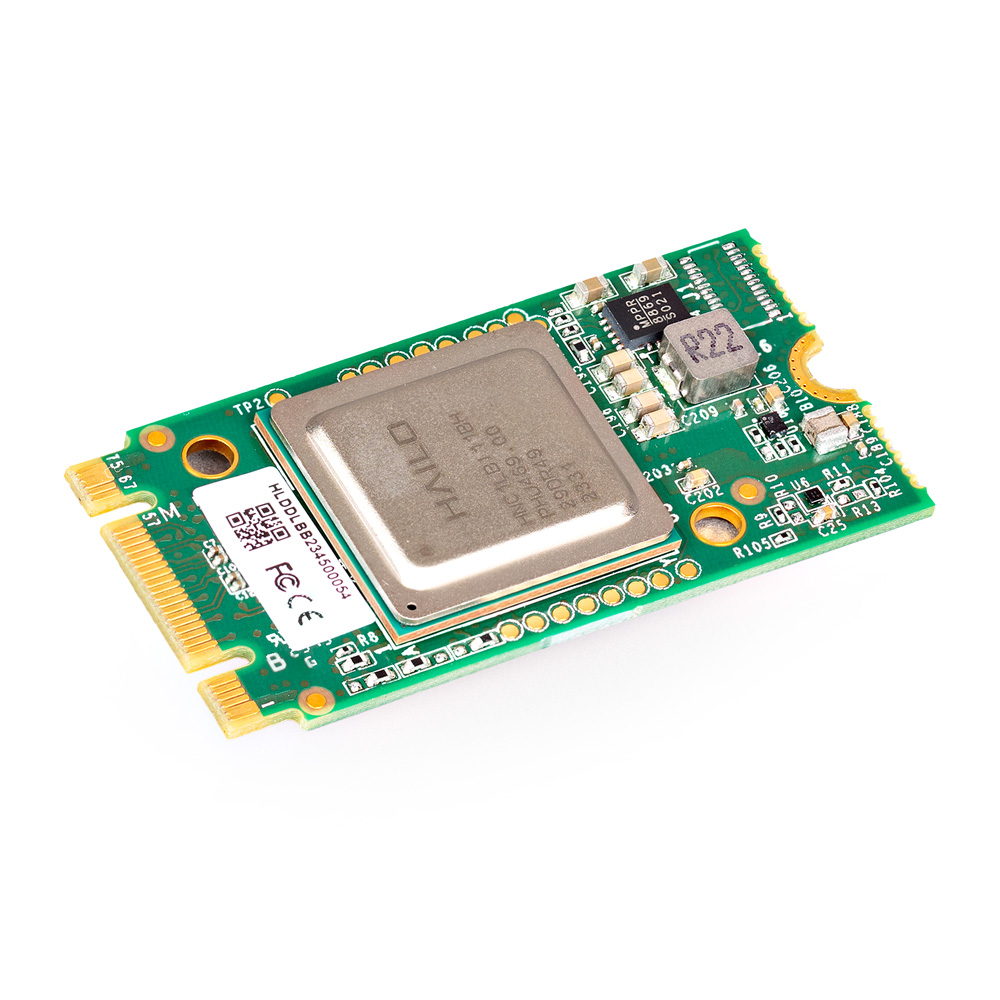
Ultralytics 8.4.105 新增 YOLO26 深度估測模型對 Hailo-8L 與 Qualcomm QNN 的支援,並改善 CoreML、OpenVINO、NCNN 等部署後端。版本亦讓中斷的知識蒸餾檢查點可直接驗證與匯出,但效能收益仍須在目標硬體上個別量測。
 最新模型
Anthropic 發布 Claude Opus 5,提供 100 萬 token 上下文、最多 12.8 萬輸出 token,並把 thinking 改為預設開啟。新模型允許代理在保留提示快取的情況下增減工具,但停用推理與高 effort 的組合存在不相容變更。
 硬體
Microsoft Research 公開 VibeVoice-ASR-BitNet,分別以 INT8 與三值權重量化語音編碼器和語言模型,讓多語 ASR 不需 GPU 即可運作。官方測試顯示模型較同容量 Whisper.cpp 快 1.6 至 2.3 倍,但目前只支援離線批次轉錄。