 推論系統
Sol-Attn 在 online softmax 內動態稀疏化注意力,影片生成端到端加速逾 2 倍
NVIDIA 研究團隊公開無需重新訓練的 Sol-Attn,在注意力運算期間選取關鍵區塊,並近似補回被跳過區塊的貢獻。官方在多款影片模型測得約 1.9 至 2.34 倍端到端加速,但品質與硬體泛化仍需獨立驗證。
Archive
推論 runtime、量化、 serving、KV cache、成本與效能。
推論系統
NVIDIA 研究團隊公開無需重新訓練的 Sol-Attn,在注意力運算期間選取關鍵區塊,並近似補回被跳過區塊的貢獻。官方在多款影片模型測得約 1.9 至 2.34 倍端到端加速,但品質與硬體泛化仍需獨立驗證。
 最新模型
Anthropic 推出 Claude Opus 5,讓開發者以 effort 設定在推理品質、token 用量與延遲之間取捨。Google Cloud 與 AWS 已提供託管版本,但「接近 Fable 5、成本減半」仍主要建立在供應商測試與每任務成本估算上。
 推論系統
Dynamo 的實驗版本加入 Kimi K3 多模態、推理與工具呼叫解析,並公開聚合及 prefill/decode 分離的 Kubernetes 配方。配方把 2.8T MoE 的部署門檻量化到機架拓撲,但目前未經正式 QA,且已知 GB200 設定仍有啟動錯誤。
 代理工具
GitHub 開始把 Grok 4.5 部署至 Copilot 的 IDE、CLI、雲端代理與桌面應用,提供最高 50 萬 token 上下文、圖文輸入及三檔推理強度。企業管理員必須主動開啟模型政策,而 GitHub 目前只公布內部終端任務觀察,尚無可比較的 Copilot 評測結果。
 GitHub Repo
Feyn 開放 2.63 億參數 FeyNoBg 與 NoBg 訓練函式庫,統一背景移除、批次推論及微調介面。官方比較顯示模型在八項資料集的四項 S-measure 領先,但未報告速度、記憶體與透明度誤差等部署指標。
 代理工具
GitHub 更新 JetBrains 外掛,讓代理工作流匯出 OpenTelemetry,並可為自帶金鑰與自訂端點設定輸入、輸出 token 上限。Claude 代理流程亦可直接接入 MCP 伺服器與自訂代理,但工具呼叫內容、成本歸因及資料遮蔽仍需部署團隊自行驗證。
 硬體
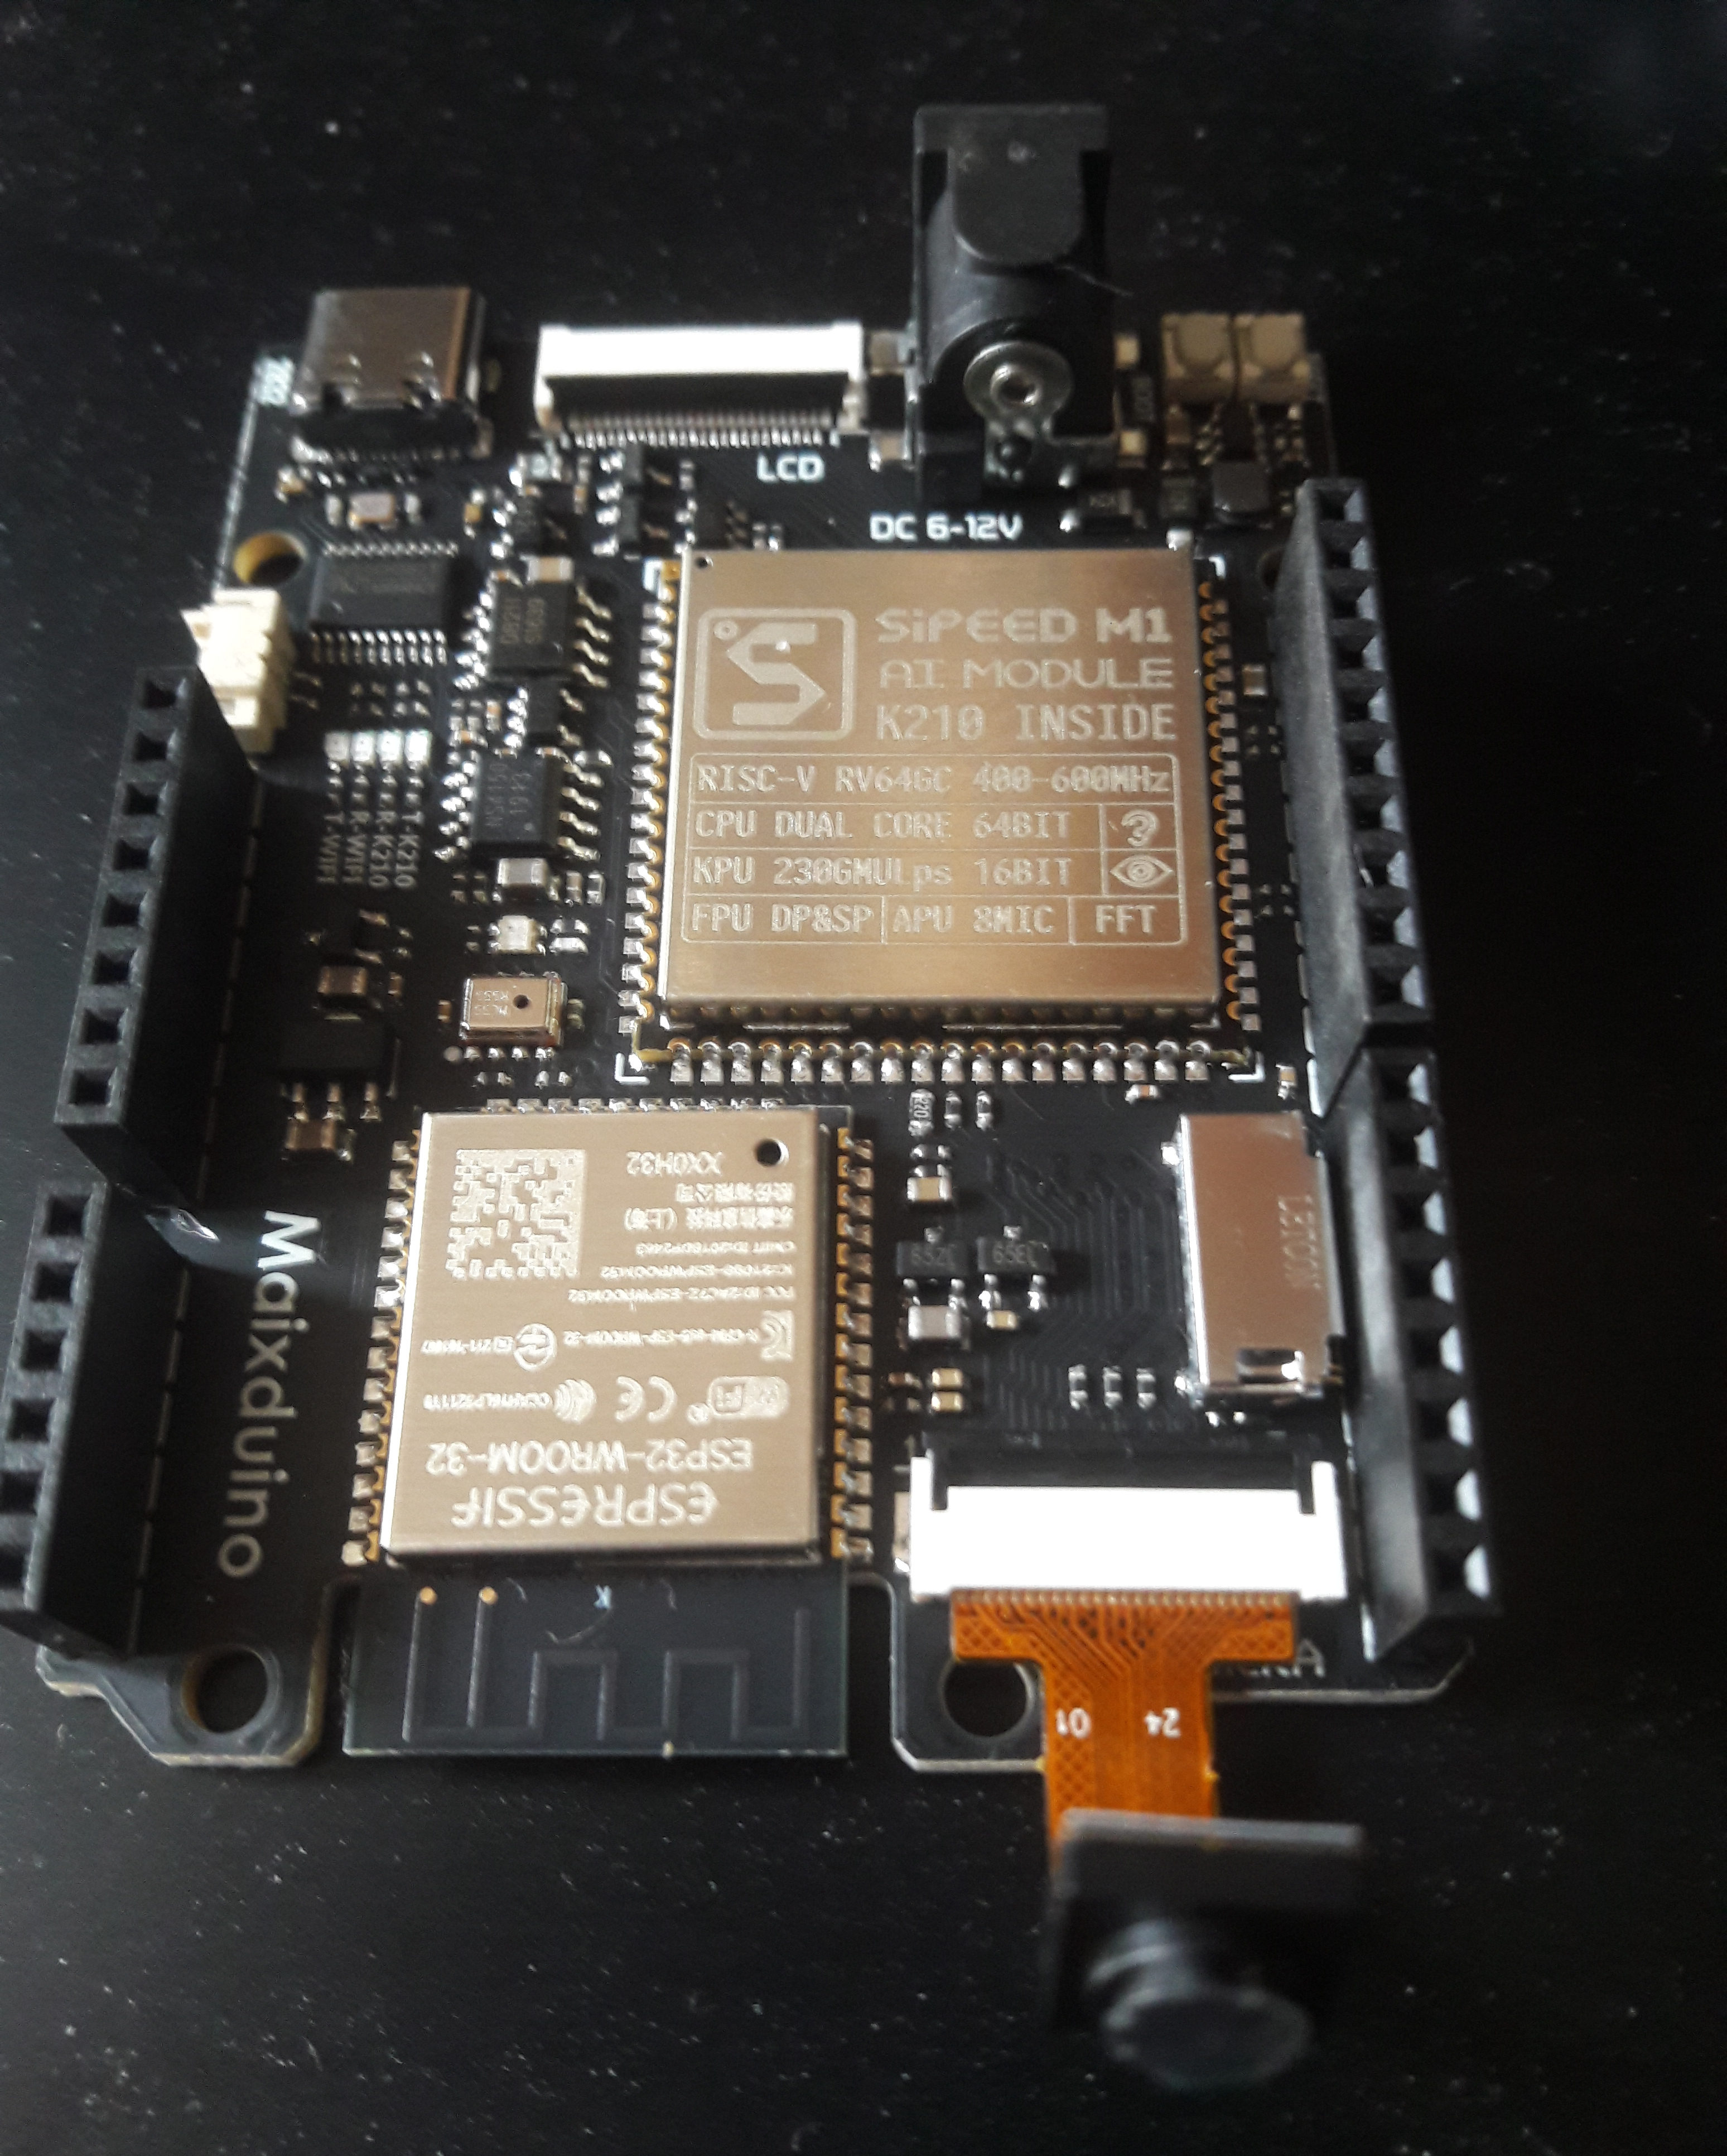
開源專案 esp32-ai 把多數參數移入記憶體映射 Flash,只讓小型 Transformer 核心留在快速記憶體,讓約 8 美元的微控制器完全離線生成文字。成果證明分層模型可下沉到韌體,但 TinyStories 等級輸出仍不能等同通用語言理解或裝置控制能力。
 推論系統
PaddlePaddle 開放 1B 參數 HPD-Parsing,以全域版面分支協調多個區塊解碼器,避開整頁逐 token 生成的序列瓶頸。官方測試顯示吞吐是既有最快比較模型的 2.62 倍,但目前依賴客製 vLLM 套件,峰值數字也不能直接等同端到端 PDF 處理速度。
 代理工具
Cohere 為 North 加入可配置的多步驟 Automations,讓代理依條件處理資料、呼叫企業工具並串接其他代理。平台支援私有部署、MCP 與稽核紀錄,但官方尚未公開失敗重試語義、版本控制及量化可靠性資料。
 代理工具
NOOA 將代理表示成單一 Python 類別,以方法、欄位、docstring 與型別標註取代分散的提示及工具 schema。官方在 SWE-bench Verified 報告 82.2% 與約一半 token 用量,但框架仍屬研究預覽,執行模型生成程式碼時必須另加沙箱。
 最新模型
Moonshot AI 於 7 月 27 日釋出 Kimi K3 完整權重、模型卡與技術報告,外部團隊如今可實際部署與稽核這款三兆級稀疏模型,但至少 64 顆加速器、自訂程式碼及推理歷史相依性也形成明確門檻。
 GitHub Repo
Nanbeige Lab 公開以 28 兆 token 從零預訓練的 Nanbeige4.2-3B,重複使用同一組 Transformer 層,在不增加參數下提升計算深度。官方代理評測普遍超越較大的 Qwen3.5-9B,但成績高度依賴自家執行框架,仍需獨立重現。