 代理工具
OmegaUse-OfficeVal 為辦公代理加入逐任務成本標籤,最佳模型品質仍落後人類逾三分之一
百度研究團隊公開 100 項長流程文件、試算表與簡報任務,並附上人工工時、價格代理值及可執行驗證器。最佳模型平均得分為 17.91,人類基線為 27.79,說明推論便宜且快速仍不等於交付物可直接使用。
Archive
推論 runtime、量化、 serving、KV cache、成本與效能。
代理工具
百度研究團隊公開 100 項長流程文件、試算表與簡報任務,並附上人工工時、價格代理值及可執行驗證器。最佳模型平均得分為 17.91,人類基線為 27.79,說明推論便宜且快速仍不等於交付物可直接使用。
 最新模型
Moonshot AI 正式釋出 Kimi K3 權重與技術報告;模型具備原生視覺、百萬 token 上下文,每個 token 啟用 896 個專家中的 16 個。開放權重使官方能力宣稱終於可以重現,但逾 1TB 的低精度權重仍讓完整部署遠離一般工作站。
 最新模型
Laguna S 2.1 以滑動視窗、注意力閘門及 FP8 KV cache 壓低長上下文成本,主打可自行部署的代理程式設計。模型提供多種精度權重與完整評測軌跡,但百萬 token 能力、效能比較及單機可行性仍高度取決於量化格式與執行環境。
 推論系統
研究團隊讓代理在推理期間預測並提前執行自己的下一個工具呼叫,以共用權重及 KV cache 取代外部草稿模型。聯合強化學習把兩款 Qwen 4B 模型的平均 Hit@1 分別提升至 61.2 與 66.3,但論文尚未量化真實並行部署的端到端加速。
 AI 安全
開源 SkillGate 在代理載入技能前,以 530 條規則定位可疑片段,再交由 LLM 判斷與隔離。官方基準測得 1.13% 誤報率及 76.9% 召回率,顯示低成本閘道可行,但尚不能取代沙箱與最小權限。
 最新模型
Shieldstral 把內容審核統一成可由自然語言指定的二元問答,讓同一模型依產品情境切換判斷標準。論文報告其文字與多模態平均 F1 分別達 84.9% 與 83.8%,但模型權重與完整推論套件尚未同步公開。
 開發者平台
GitHub Models 將於 7 月 30 日停止所有服務,既有客戶的模型目錄、Playground、推論 API 與 BYOK 端點都會消失。遷往 Microsoft Foundry 並非單純更換網址,團隊還須重新驗證身分、模型版本、計費與輸出相容性。
 推論系統
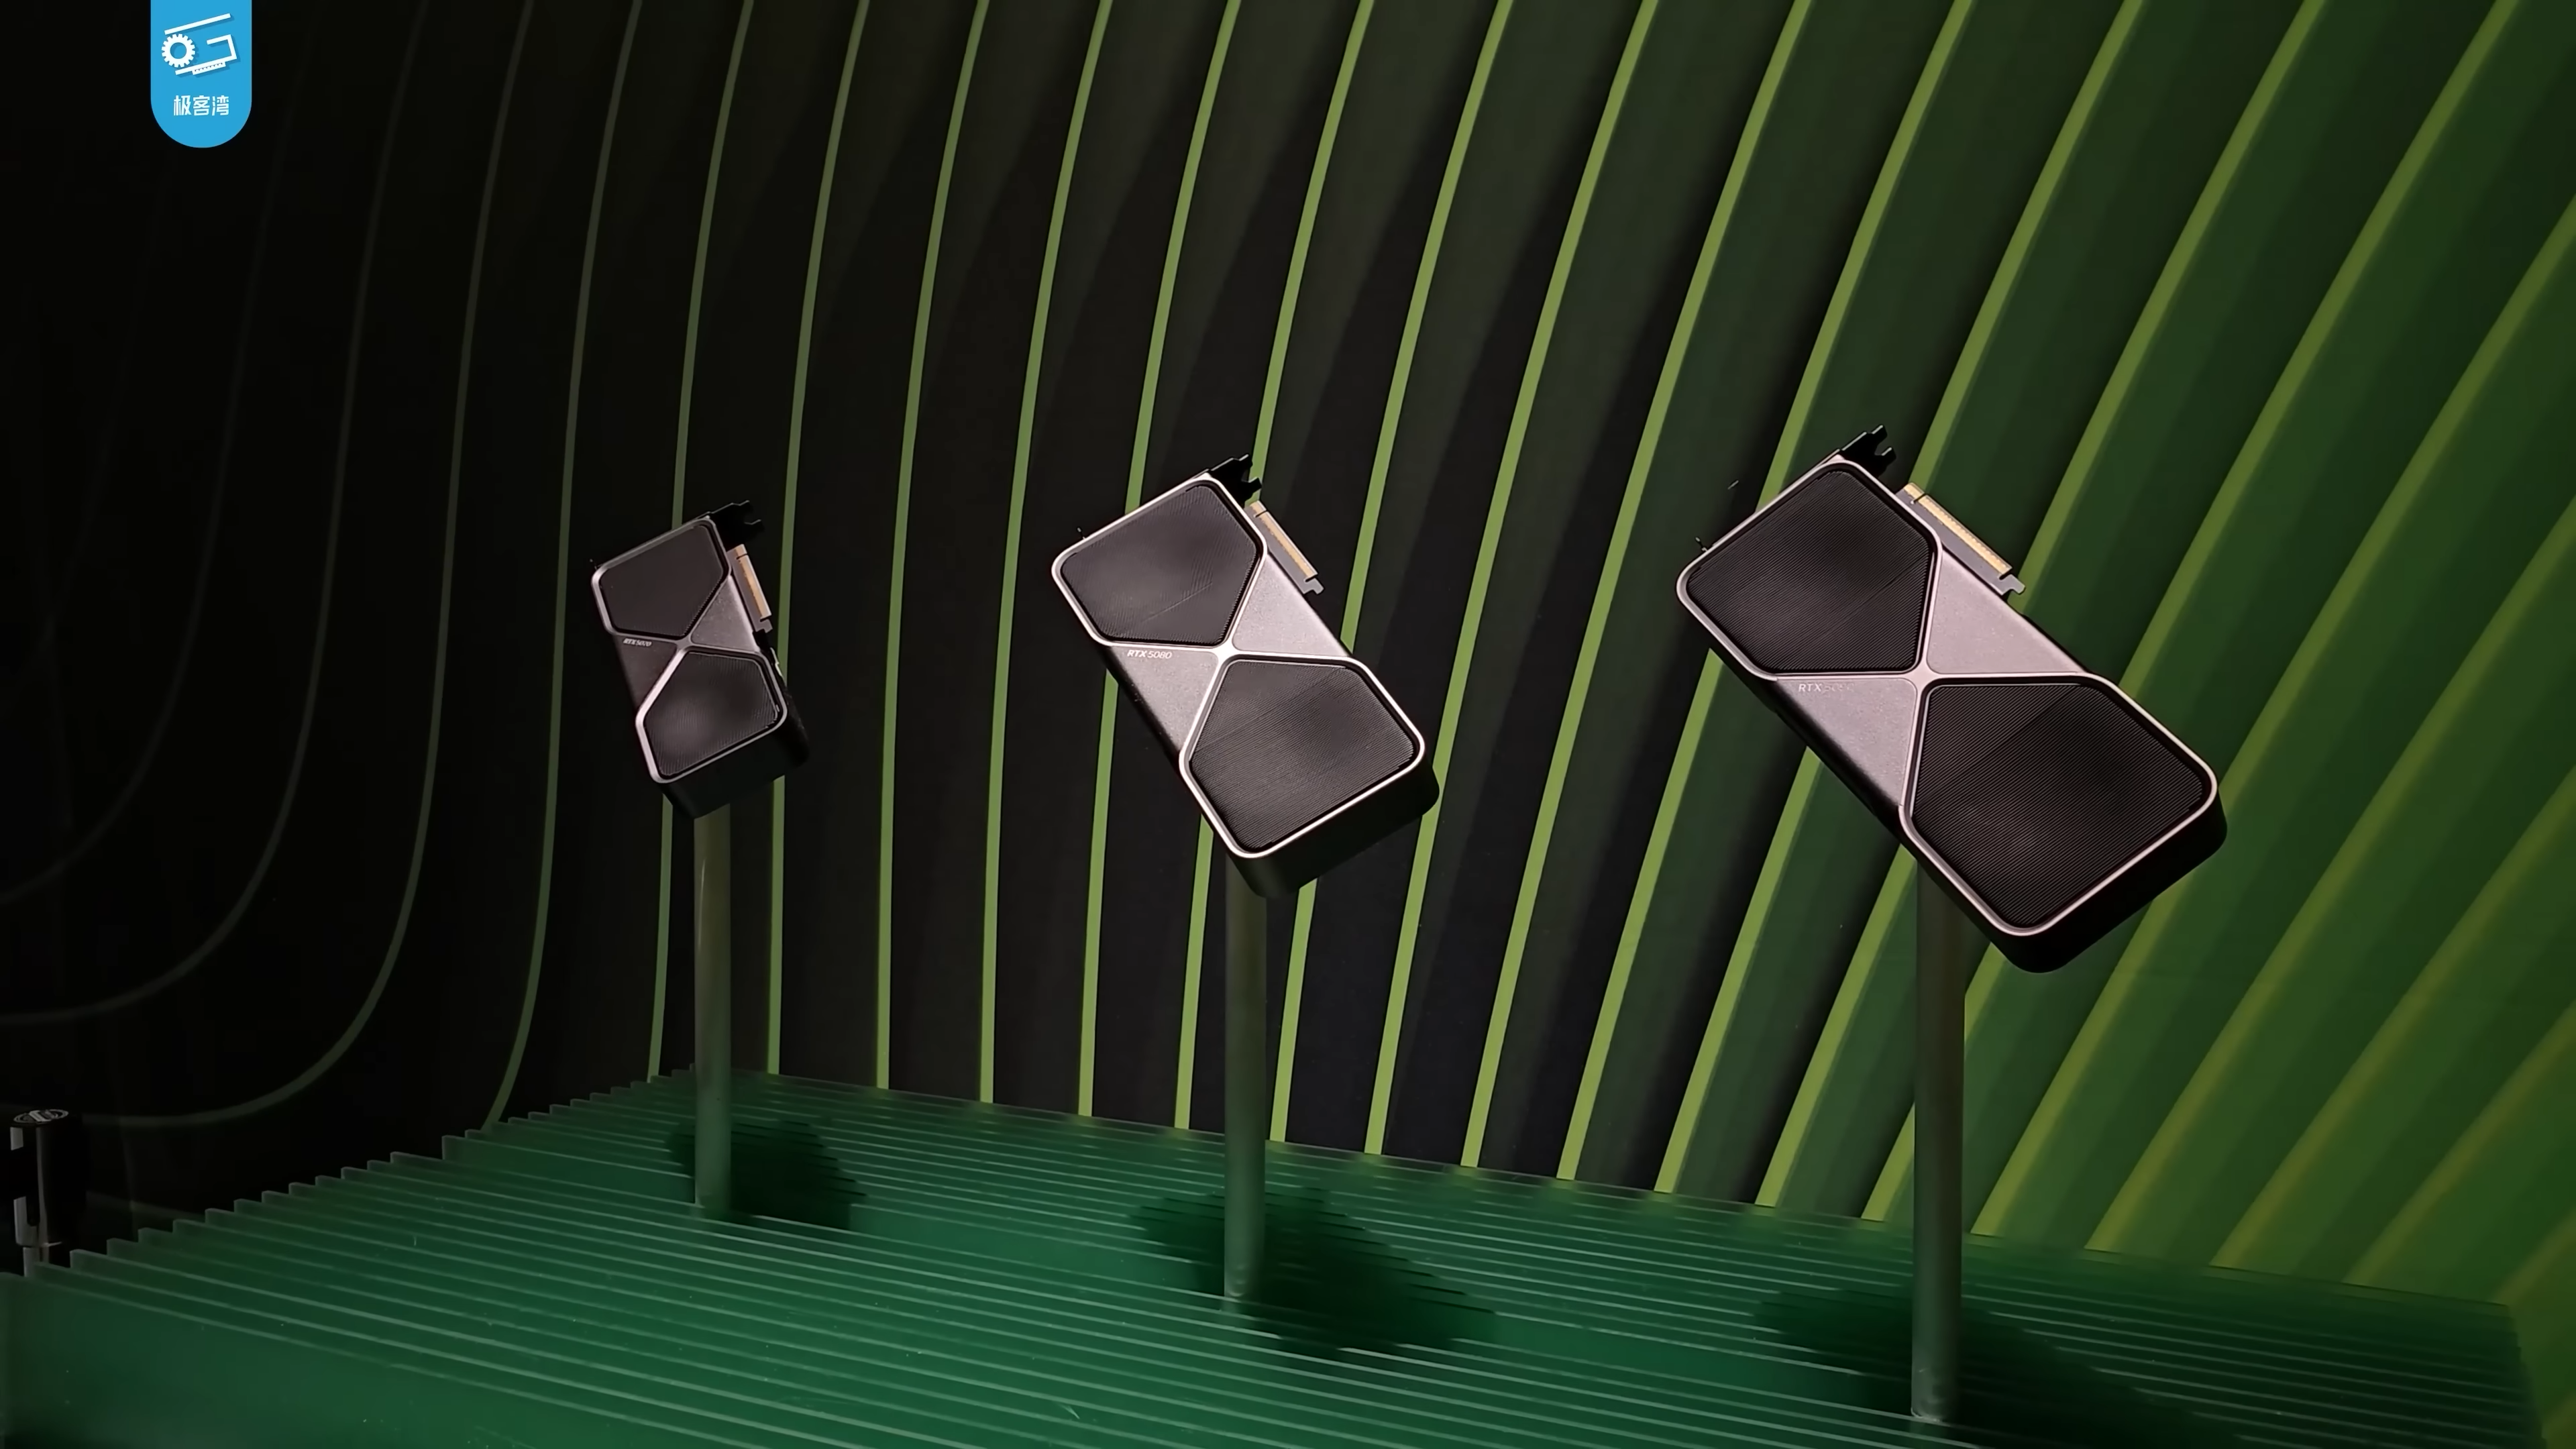
開源 NInfer 以客製量化、權重布局、融合核心與 MTP 草稿路徑,讓 Qwen3.6-35B-A3B 在單張 RTX 5090 上長程解碼維持約每秒 543 token。速度來自針對模型與 GPU 的深度特化,目前只支援兩個 checkpoint、缺乏連續批次,也尚無同條件獨立評測。
 AI 基礎設施
MLCommons 推出面向託管推論服務的 Endpoints 0.7,以自動投稿、持續審查及互動圖表取代半年一次的靜態比較。首版涵蓋五家供應商與三項基準,但成本正規化、代理工作負載及廣泛投稿要等 1.0 才會加入。
SpecBox 根據串流 token 推測即將使用的工具,讓沙箱啟動與模型推論重疊,並以相依圖預取後續執行環境。論文報告其 P99 端到端延遲最高改善 2.9 倍、峰值記憶體降低 45.9%,但目前仍是研究原型,尚無公開程式碼或獨立重現結果。
 硬體
CoTinyVLA 把 35B 教師的分層推理蒸餾進 0.9B 視覺—語言—動作模型,在 LIBERO-Plus 四組測試均領先最強 7B 基線。程式、訓練流程與權重已公開,但尚無真實機器人、不同硬體或外部團隊的重現結果。
 代理工具
開源 JarvisHub 以型別化節點和連線保存素材、版本、相依關係與代理軌跡,讓長程創作不必塞在線性對話中。系統已提供可執行的三層架構與本機部署程式,但論文目前只有質性案例,尚未證明可靠性或成品品質提升。