 AI 安全
Microsoft 以 5B 啟用參數資安模型分流漏洞分析,MDASH 在 CyberGym 得分 95.95%
MAI-Cyber-1-Flash 是 137B 參數的稀疏 MoE,但每個 token 只啟用約 5B,負責 MDASH 約九成工作,再把困難案例交給 GPT-5.4。官方宣稱新配置成本降低近半,但模型目前僅在 Azure AI Foundry 私人預覽提供,基準也尚未經外部重現。
Archive
推論 runtime、量化、 serving、KV cache、成本與效能。
AI 安全
MAI-Cyber-1-Flash 是 137B 參數的稀疏 MoE,但每個 token 只啟用約 5B,負責 MDASH 約九成工作,再把困難案例交給 GPT-5.4。官方宣稱新配置成本降低近半,但模型目前僅在 Azure AI Foundry 私人預覽提供,基準也尚未經外部重現。
 代理工具
MANTA 依任務建立代理通訊圖,再從執行軌跡偵測協作異常並有限度改寫角色、連線與驗證順序。以 Gemma 4 31B 測試時,其五項基準平均得分達 74.0,但實驗樣本與重複次數仍偏少。
 推論系統
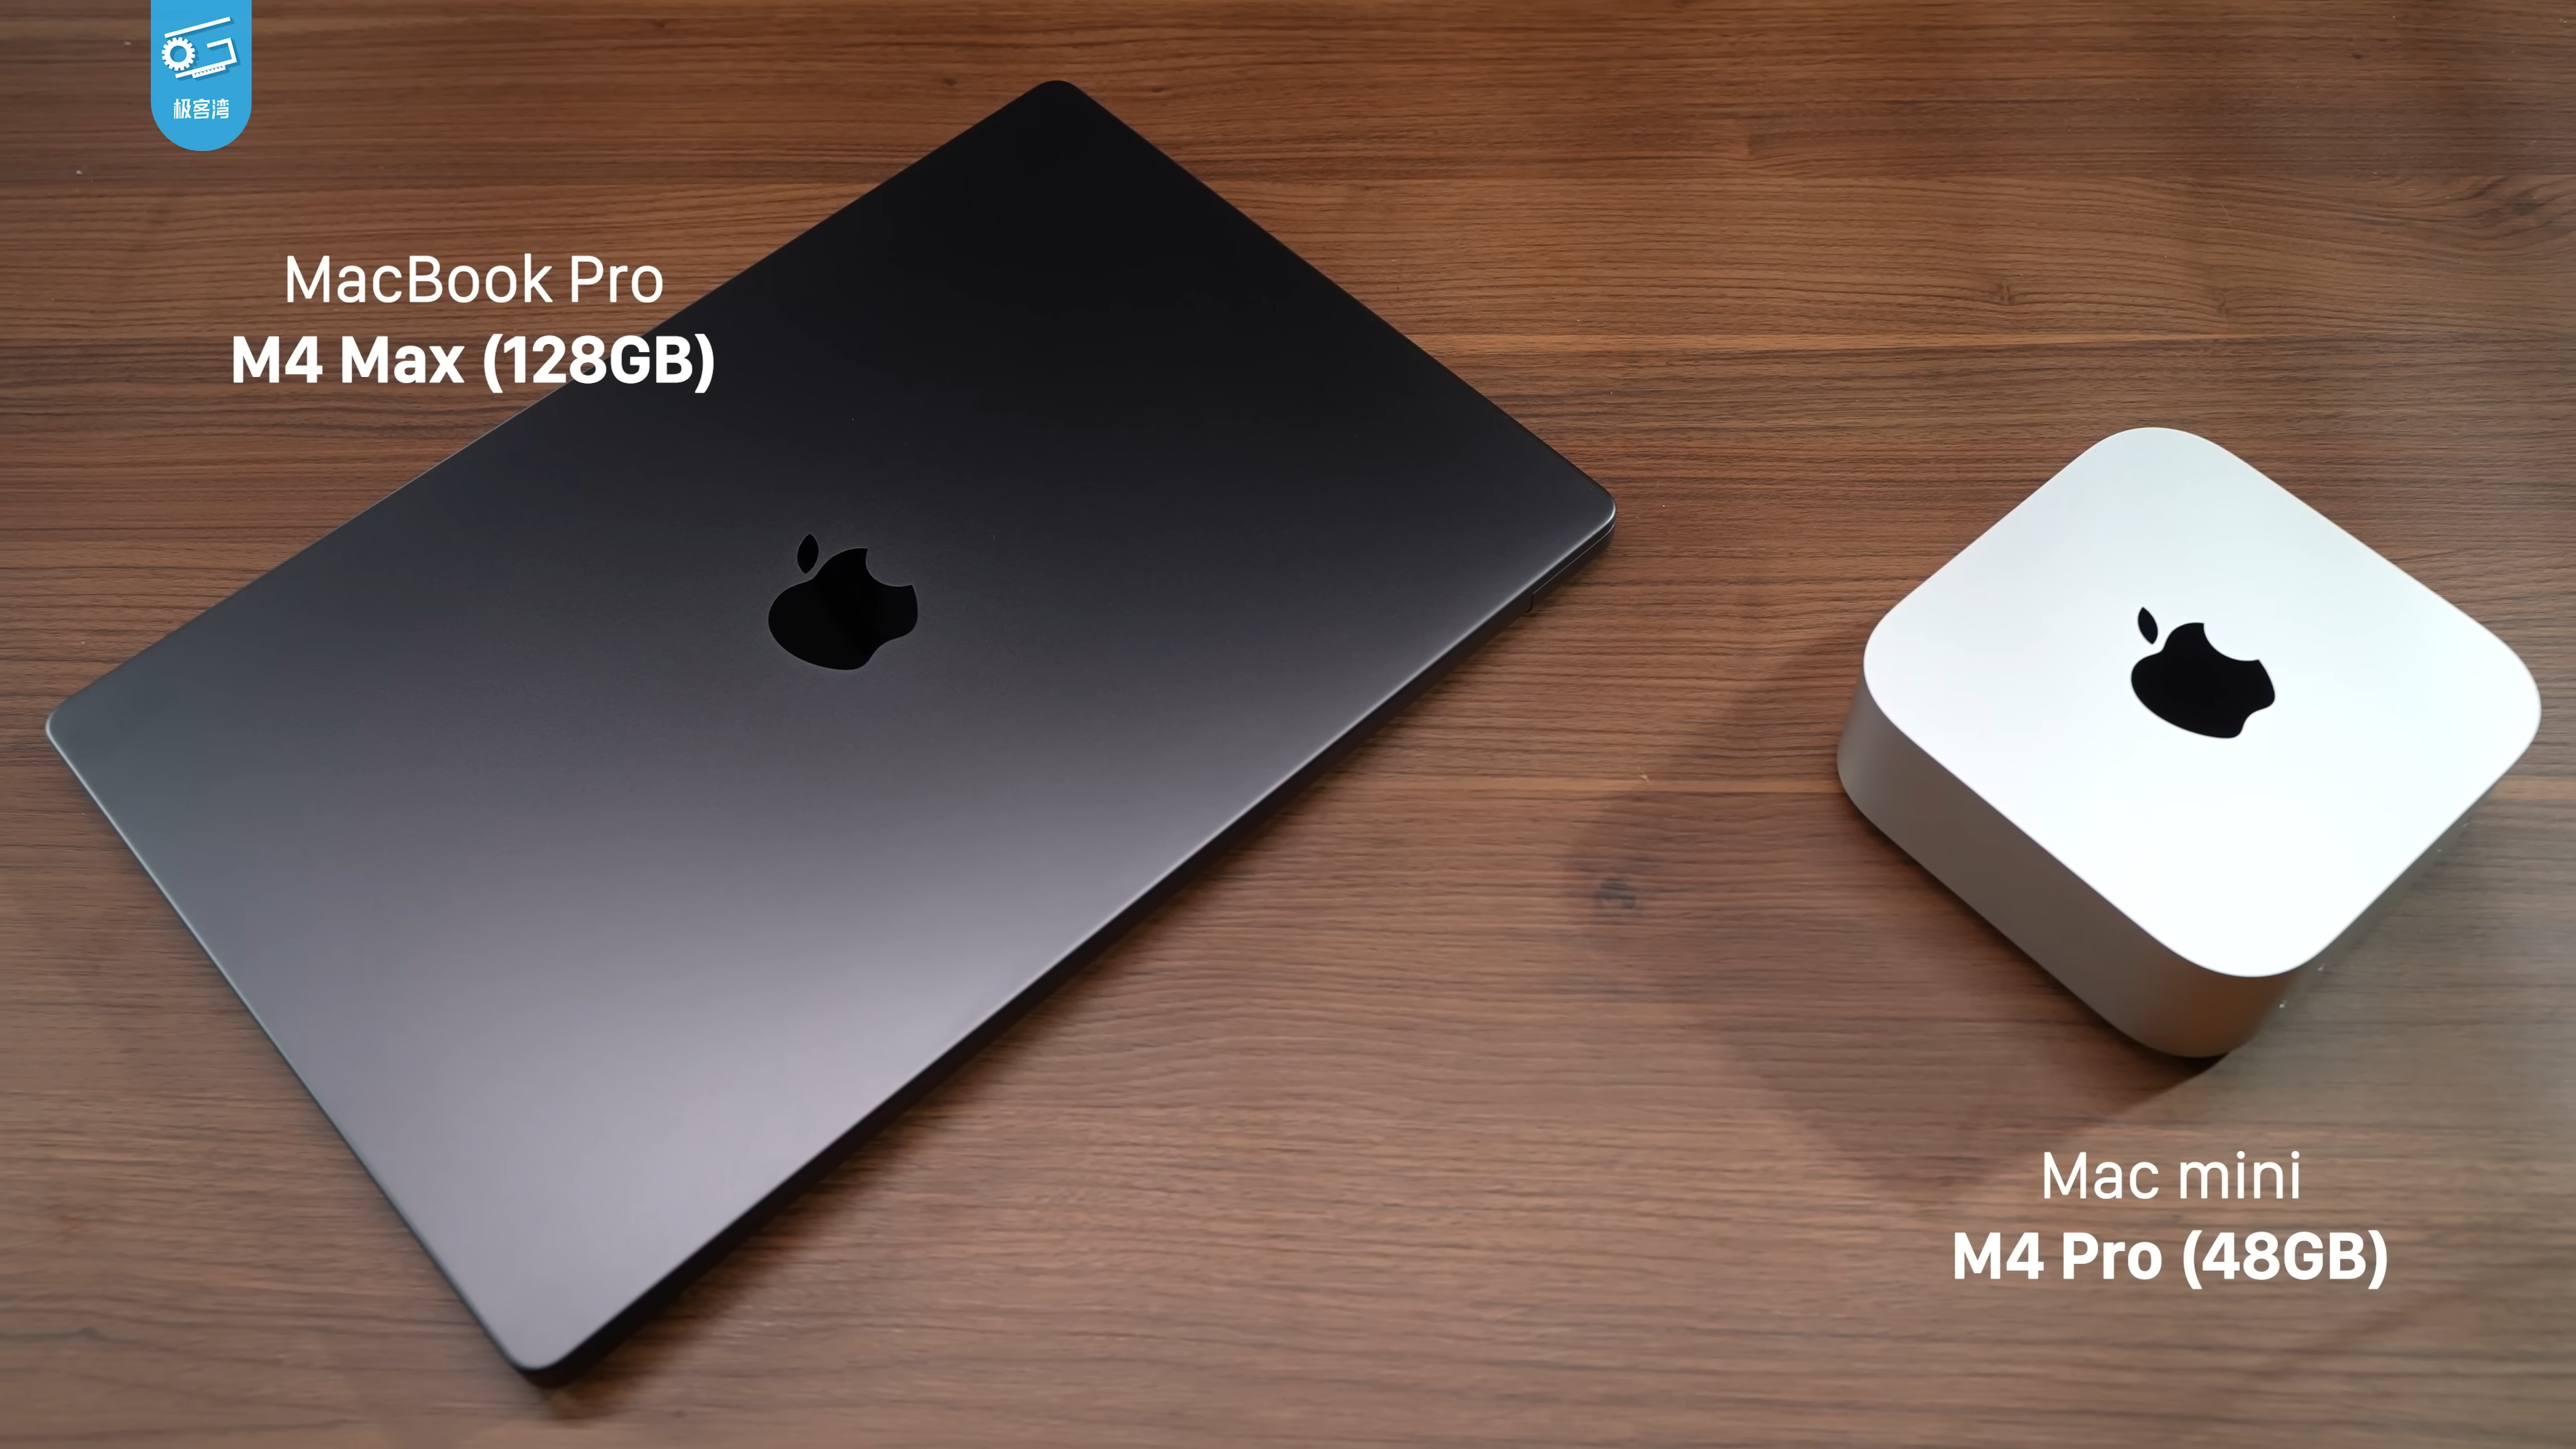
新一輪同價位本機 AI 測試顯示,M4 Max 憑 546GB/s 統一記憶體頻寬,在三款量化模型的逐 token 解碼領先 GB10 與 Strix Halo。GB10 的 prompt prefill 與整體能效仍佔優,單看 tokens/s 會錯估實際回應時間。
 最新模型
SVR 同時訓練答案、正誤判決與信心,使模型在推論時自行決定保留答案或繼續修正。Qwen3.5-2B 在七項數學基準取得 56.3% 平均準確率,但停止訊號仍可能受模型自身的校準偏差影響。
 開發者平台/API
GitHub 已於 7 月 30 日關閉 Models 的 playground、模型目錄、推論 API 及自帶金鑰功能,既有付費使用者也不例外。依賴其端點的應用必須遷移至 Microsoft Foundry、其他模型閘道或自建供應商抽象層。
 最新模型
一項新研究生成 68.6 萬本、共 320 億 token 的合成教材,並以內容相同的對照實驗隔離文件結構效應。把相關章節組成完整書籍優於拆散段落或隨機串接,但收益仍來自研究團隊自建訓練流程,資料與程式尚未公開。
 推論系統
SemPIC 以獨立 Writer 模型離線產生不依賴輸入位置的文件 KV,Reader 則維持原模型與標準快取介面。三款模型、四項任務的平均 micro-F1 由既有方法的 0.53 升至 0.60,但尚未公布端到端延遲、快取容量與程式碼。
 推論系統
QuantWAMs 針對同時生成未來畫面與機器人動作的模型,將量化校準改成結構、聯合目標與閉環軌跡三層決策。兩款模型的模擬成功率與 FP16 相差 0.2 至 0.7 個百分點,但速度數據只涵蓋特定運算模組,真機比較也只有每項十次試驗。
 代理工具
一項 OSWorld 實驗顯示,本機 GUI 代理加入少量畫面歷史可明顯降低重複操作,但繼續延長上下文或步數主要是在改變失敗型態。兩階段規劃架構也因格式與協調成本落後單一代理,平行產生更多計畫只能以高昂 token 成本追回部分差距。
 最新模型
Moonshot AI 從 42 個既有基準的最早失敗點建立感知分類,再以 3,000 道短答案題隔離十項基本視覺能力。結果顯示整體分數相近的模型可能具有完全不同的感知缺口,但測試集源自更大的內部題庫,仍需防範污染與評測者偏差。
 最新模型
微軟的 Mage-VL 不再均勻抽取影片影格,而是利用 I/P frame、運動向量與殘差能量,只編碼變化較大的區域。4B 模型宣稱可減少逾 75% 視覺 token 並維持靜態任務能力,但速度與品質比較仍主要來自官方測試。
新研究發現,on-policy 擴散蒸餾若只匹配 classifier-free guidance 合成結果,正、負分支的誤差可能互相抵銷。Positive-Direction Matching 將兩者拆開監督,在密集到稀疏的影片控制實驗中降低模型對推論 guidance scale 的敏感度。