 最新模型
AgentPatch 免訓練修補多模態代理合併,六項基準平均分由 54.5 升至 56.6
AgentPatch 先找出模型合併後的弱項,再只恢復專家模型的獨有殘差與關鍵 FFN 神經元。它輸出單一靜態 checkpoint,無需路由或推論期代理,但完整評測轉接器與模型權重仍未公開。
Archive
推論 runtime、量化、 serving、KV cache、成本與效能。
最新模型
AgentPatch 先找出模型合併後的弱項,再只恢復專家模型的獨有殘差與關鍵 FFN 神經元。它輸出單一靜態 checkpoint,無需路由或推論期代理,但完整評測轉接器與模型權重仍未公開。
 AI 安全
OpenAI 表示 Astra 的代理編碼與網路攻防能力進展,使其無法排除模型已跨入最高風險門檻。公司已隔離測試環境、限制工具與網路存取,並讓監控器檢查代理的推理軌跡與高風險行動。
 代理工具
DiDPO 不再把整次代理執行的成敗平均分配給所有 token,而是比對多條軌跡中的相似子 diff。公開的 verl-code 已包含訓練入口與資料配方,但尚無作者模型 checkpoint,實驗也不是完整軟體庫修復。
 推論系統
社群部署配方在單台 DGX Spark 上啟用 CUDA Graph 與一層 MTP 推測解碼,把 Ling-3.0-flash INT4 的生成速度由 20.8 提至 38.7 token/s。更關鍵的發現是主線 vLLM 尚未支援 V3 架構,強行套用舊注意力路徑不一定報錯,卻可能輸出看似流暢的錯誤內容。
 時間序列與檢索增強
百度研究者把 RAG 從文字生成移植到多變量時間序列,以 TCN 檢索相似片段,再用交叉注意力融合。加入通道依賴的版本在六套資料集優於所列基線,但程式尚未公開,採用的傳統基準也已被維護者警告可能失去鑑別力。
 最新模型
DASH 不再等量處理每個 token 的師生差異,而是根據整段推理中的分歧變化調整監督範圍。三種 Qwen3 規模均優於同條件 OPSD,但最佳 checkpoint 由測試基準平均分挑選,可能高估泛化增益。
 推論系統
PaDoc 讓版面序列與各區域內容共用頁面前綴並行解碼,避免把整頁文件串成單一路徑。2.1B 模型在 OmniDocBench 維持 94.24 整體分數,但效能數字來自單一 GPU 與特定排程設定。
 硬體
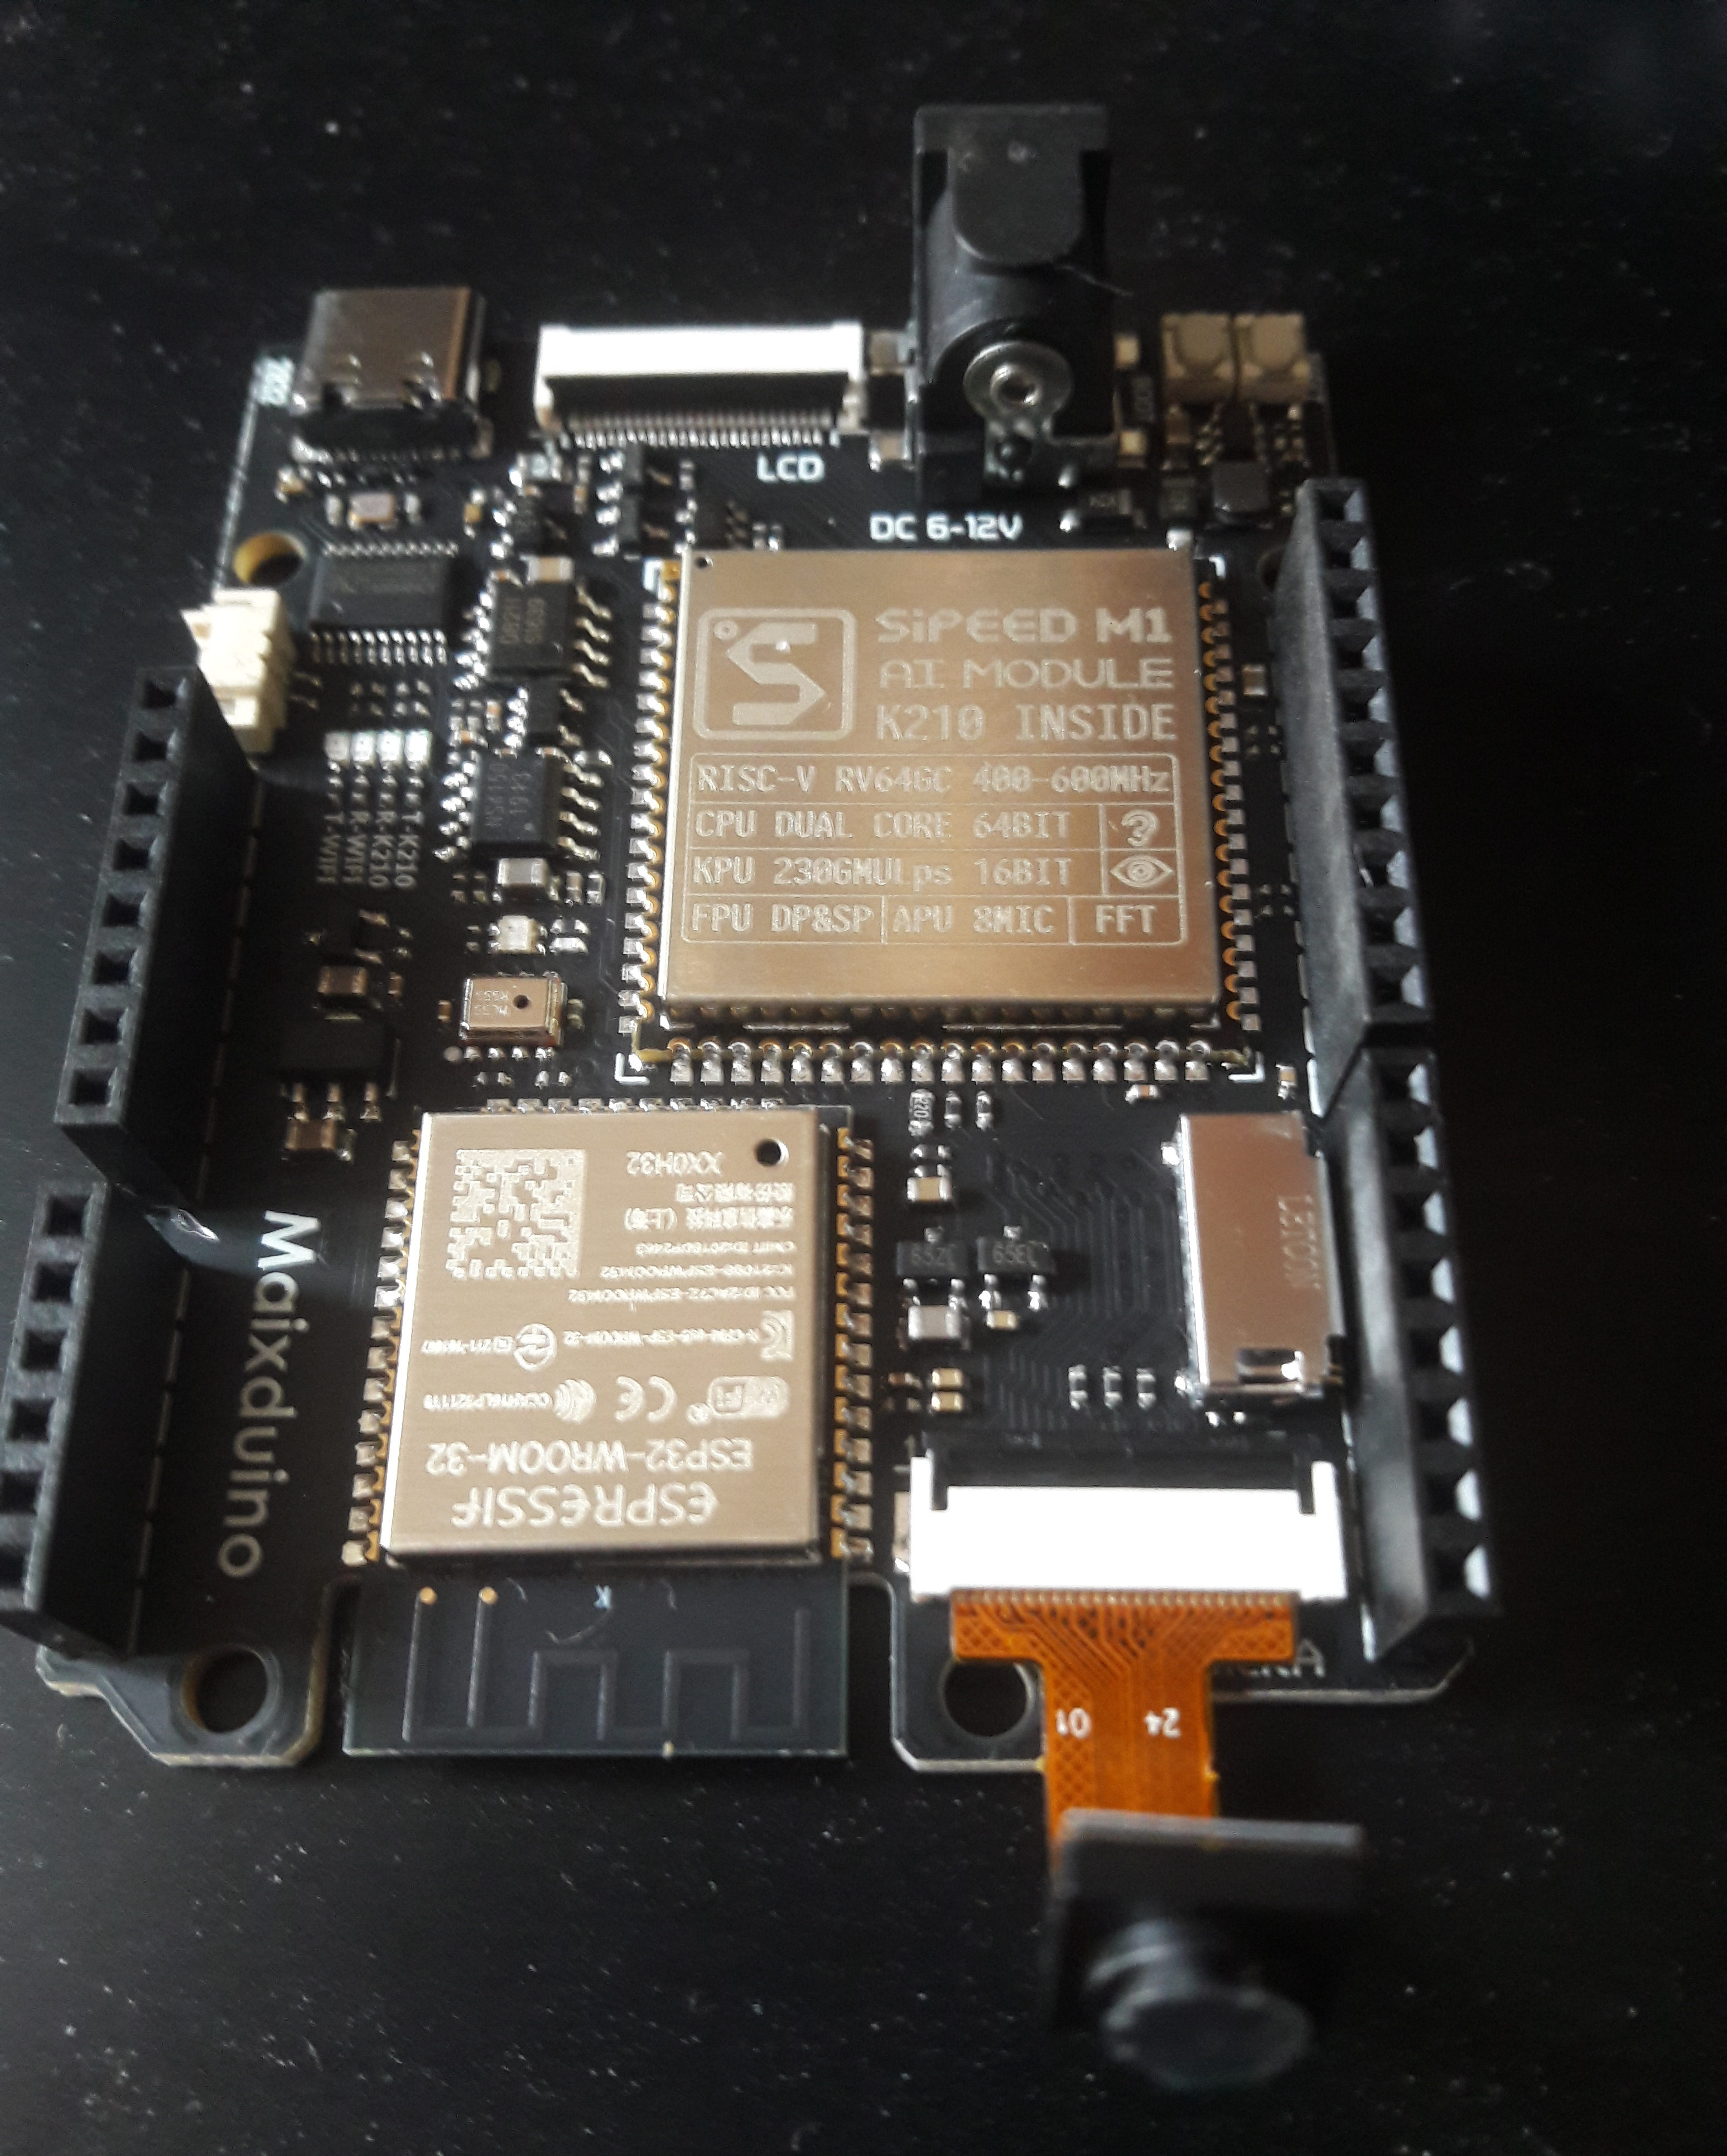
開源專案 esp32-ai 以 4-bit 量化及分層記憶體配置,把約 2,500 萬個嵌入參數留在快閃記憶體,只按 token 讀取所需列。模型能在低於 10 美元的微控制器上離線生成文字,但能力仍限於簡短故事與單一領域問答。
 推論系統
PhyAI 以模型轉接器保留各架構的條件、求解器與動作語意,再共用圖執行、核心、快取及多 GPU 服務。公開測試涵蓋 π0、π0.5、GR00T N1.7、Cosmos3 與 MiniCPM-Robot,但部分比較未使用完全相同的數值精度。
 代理工具
Ai2 以 462 份真實數學家教逐字稿建立可重播評測,要求模型在「提供鷹架」與「要求學生深入推理」之間選擇。明示兩者取捨可改善七款模型表現,但模擬學生與模型評分仍不能證明真實學習成效。
 最新模型
LFM2.5-2.6B 以短卷積與 GQA 混合架構,把代理推理、工具使用及長上下文帶到手機與個人電腦。官方測得 M5 Max 解碼 220 token/s,但效能與代理基準均主要來自廠商自評。
 最新模型
u-OPSD 從同一模型的八條推理軌跡產生多數決偽解答,再把共識條件下的 token 分布蒸餾至分歧軌跡。Qwen3-8B 非思考模式的五項平均分由 43.57 升至 54.31,但錯誤共識與多次取樣成本仍限制其適用範圍。