 推論系統
FreeBalance 提前預測 MoE 熱門專家,八張 A800 的 prefill 延遲最多降低 13.1%
FreeBalance 用上一層殘差狀態預測下一層專家負載,讓權重交換與注意力計算重疊。方法不改變最終路由與模型輸出,但目前證據只涵蓋兩款 MoE 模型、單一八卡拓撲及 prefill 工作負載。
Archive
推論 runtime、量化、 serving、KV cache、成本與效能。
推論系統
FreeBalance 用上一層殘差狀態預測下一層專家負載,讓權重交換與注意力計算重疊。方法不改變最終路由與模型輸出,但目前證據只涵蓋兩款 MoE 模型、單一八卡拓撲及 prefill 工作負載。
 推論系統
DeepSeek 已為 V4 Flash 與 Pro 啟用分時費率,尖峰時段價格是離峰兩倍。受衝擊最大的不是一般輸入,而是長對話與程式代理大量使用的快取命中 token。
 最新模型
Oracle 為 Grok 3、Grok 4 與多款 Fast、Mini、Code 端點設定的 8 月 15 日退休日已到。這不是模型別名的透明切換;OCI 使用者必須修改模型 ID,並重新驗證推理參數、影像限制與區域可用性。
 推論系統
新版修補兩個位於模型前處理層的相容性缺口:WebP 影像會先轉碼,Qwen renderer 亦不再要求 system 訊息必須排在最前。變更雖不涉及新模型或 kernel,卻可避免多模態及代理對話在進入推論核心前失敗。
 最新模型
GCache 不再只比較相鄰去噪步驟的局部差異,而是估算快取誤差對最終影像或影片的累積影響。它以動態規劃選擇快取刷新點,再用 Bayesian optimization 讓理論權重對齊實際生成品質。
 推論系統
FlashDrive 同時重用影片 KV、平行草擬推理 token,並快取流匹配中變化較小的步驟。論文在 RTX PRO 6000 報告 4.7 倍加速且軌跡誤差近乎不變,但仍只是在模擬與單一模型堆疊上的結果。
 推論系統
新版加入 Kimi K3 的文字模型、混合 KDA/MLA 注意力、latent MoE 與工具呼叫解析。轉換器直接重排 MXFP4 位元配置,毋須先展開整個 2.8T 模型至 BF16。
 最新模型
舊版 LoRA 載入路徑未驗證張量位移加大小是否超出 GGUF 檔案,損毀或未完整下載的 adapter 仍可能被當作成功載入。b10451 改為立即報錯,並確認張量索引確實存在。
 GitHub Repo
NInfer 的 Ampere 分支把 Qwen3.8-27B、MTP3、分頁 KV 與相容前綴重用塞進單張 24GB RTX 3090。作者測得八路解碼合計 165.33 token/秒,但結果集中於短提示、長輸出的固定工作負載。
 推論系統
社群實測指出,Apple Silicon 推論框架仍無法同時穩定提供內建 MTP 推測解碼、混合狀態前綴快取與批次服務。問題不只影響跑分,也會令長時程式代理在每輪對話重新支付 prefill 成本。
 最新模型
Google 將 Gemini 3.7 Flash 推向 API、Antigravity、Android Studio及企業代理平台,並以限時半價切入高流量代理工作負載。首批整合顯示多模態、工具呼叫與跨 API 格式已可用,但推理參數和成本資料仍有遷移陷阱。
 生成式 AI 工具
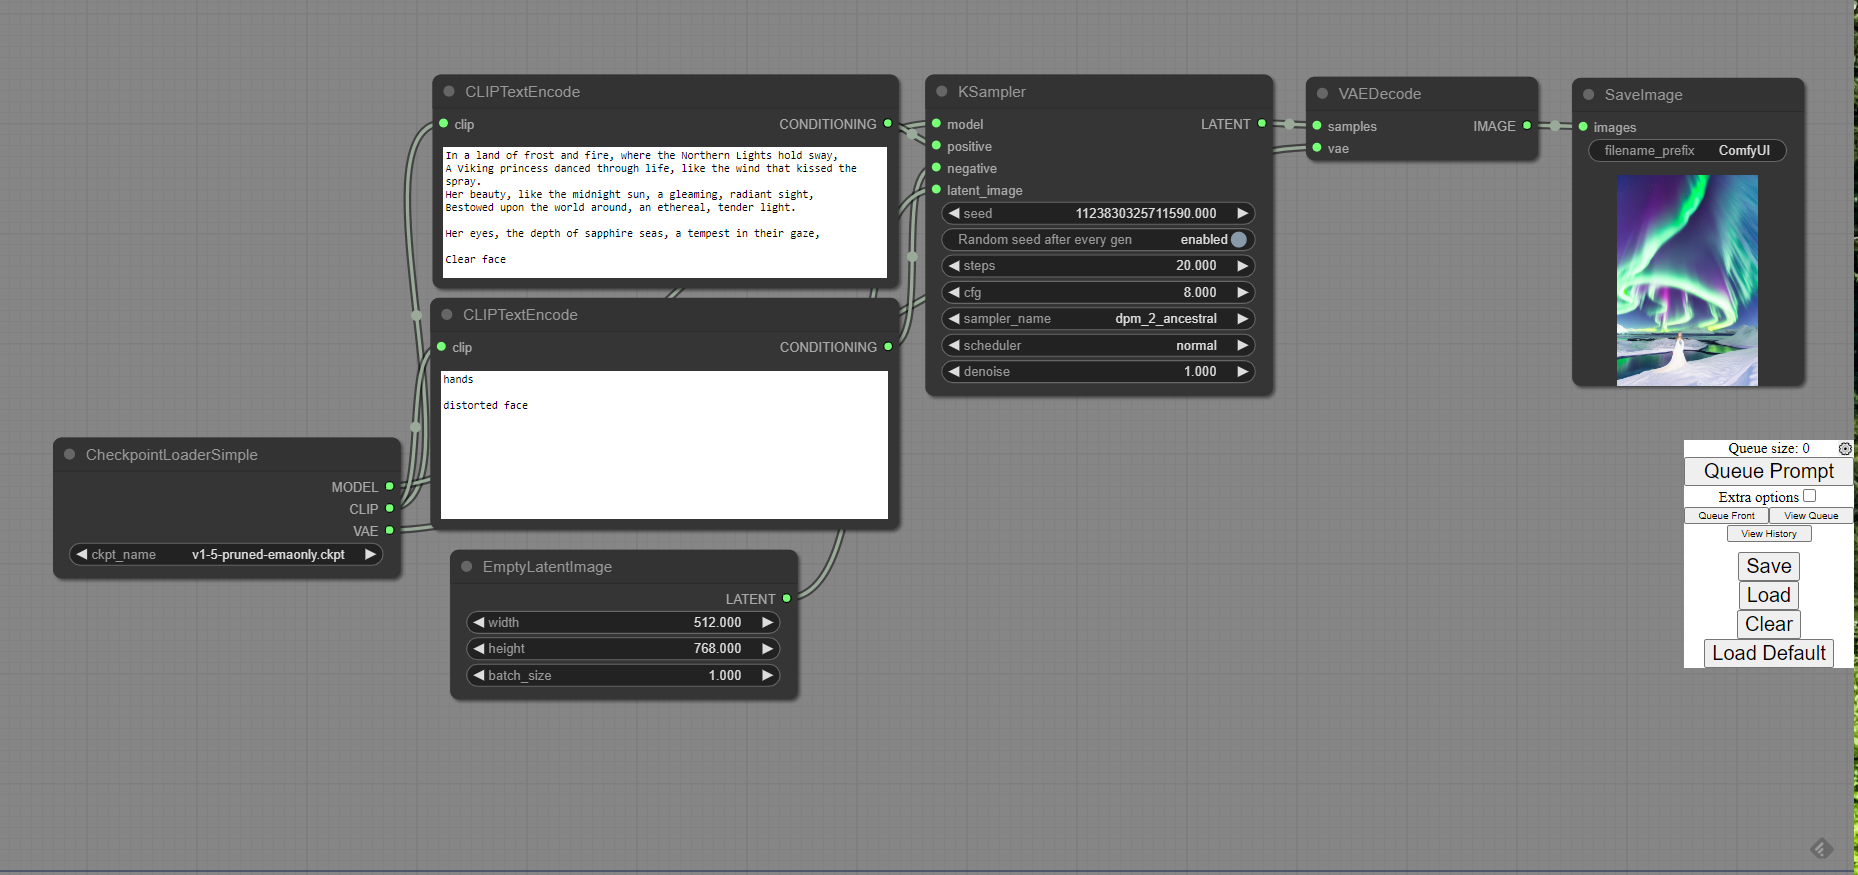
ComfyUI 0.33.1 把 MiniMax Music 3 的模型載入及推理節點納入核心,並加入可供後端使用的 CUDA Graph 支援。版本亦修正固定 VRAM 配置無法執行 Music 3,以及部分 MiniMax 權重 QKV 版型辨識問題。