 最新模型
Muse Spark 1.3 減少代理工具呼叫,最高推理模式仍等待安全測試
Meta 更新 Muse Spark,主攻長週期代理、程式開發及混雜對話中的任務追蹤,內部比較顯示工具呼叫與 token 用量同步下降。模型已進入 Muse Code 與 API,但最高推理模式、開放權重和可重現的完整評測仍未到位。
Archive
推論 runtime、量化、 serving、KV cache、成本與效能。
最新模型
Meta 更新 Muse Spark,主攻長週期代理、程式開發及混雜對話中的任務追蹤,內部比較顯示工具呼叫與 token 用量同步下降。模型已進入 Muse Code 與 API,但最高推理模式、開放權重和可重現的完整評測仍未到位。
 最新模型
Google 讓 Gemini 3.8 Flash 正式供生產使用,提供百萬 token 上下文、可調推理力度及新的 API 遷移要求。共用核心的 Flash Cyber 主攻弱點發現與自動修補,但僅透過 Fairwind 計畫向經審核的防禦者開放。
 最新模型
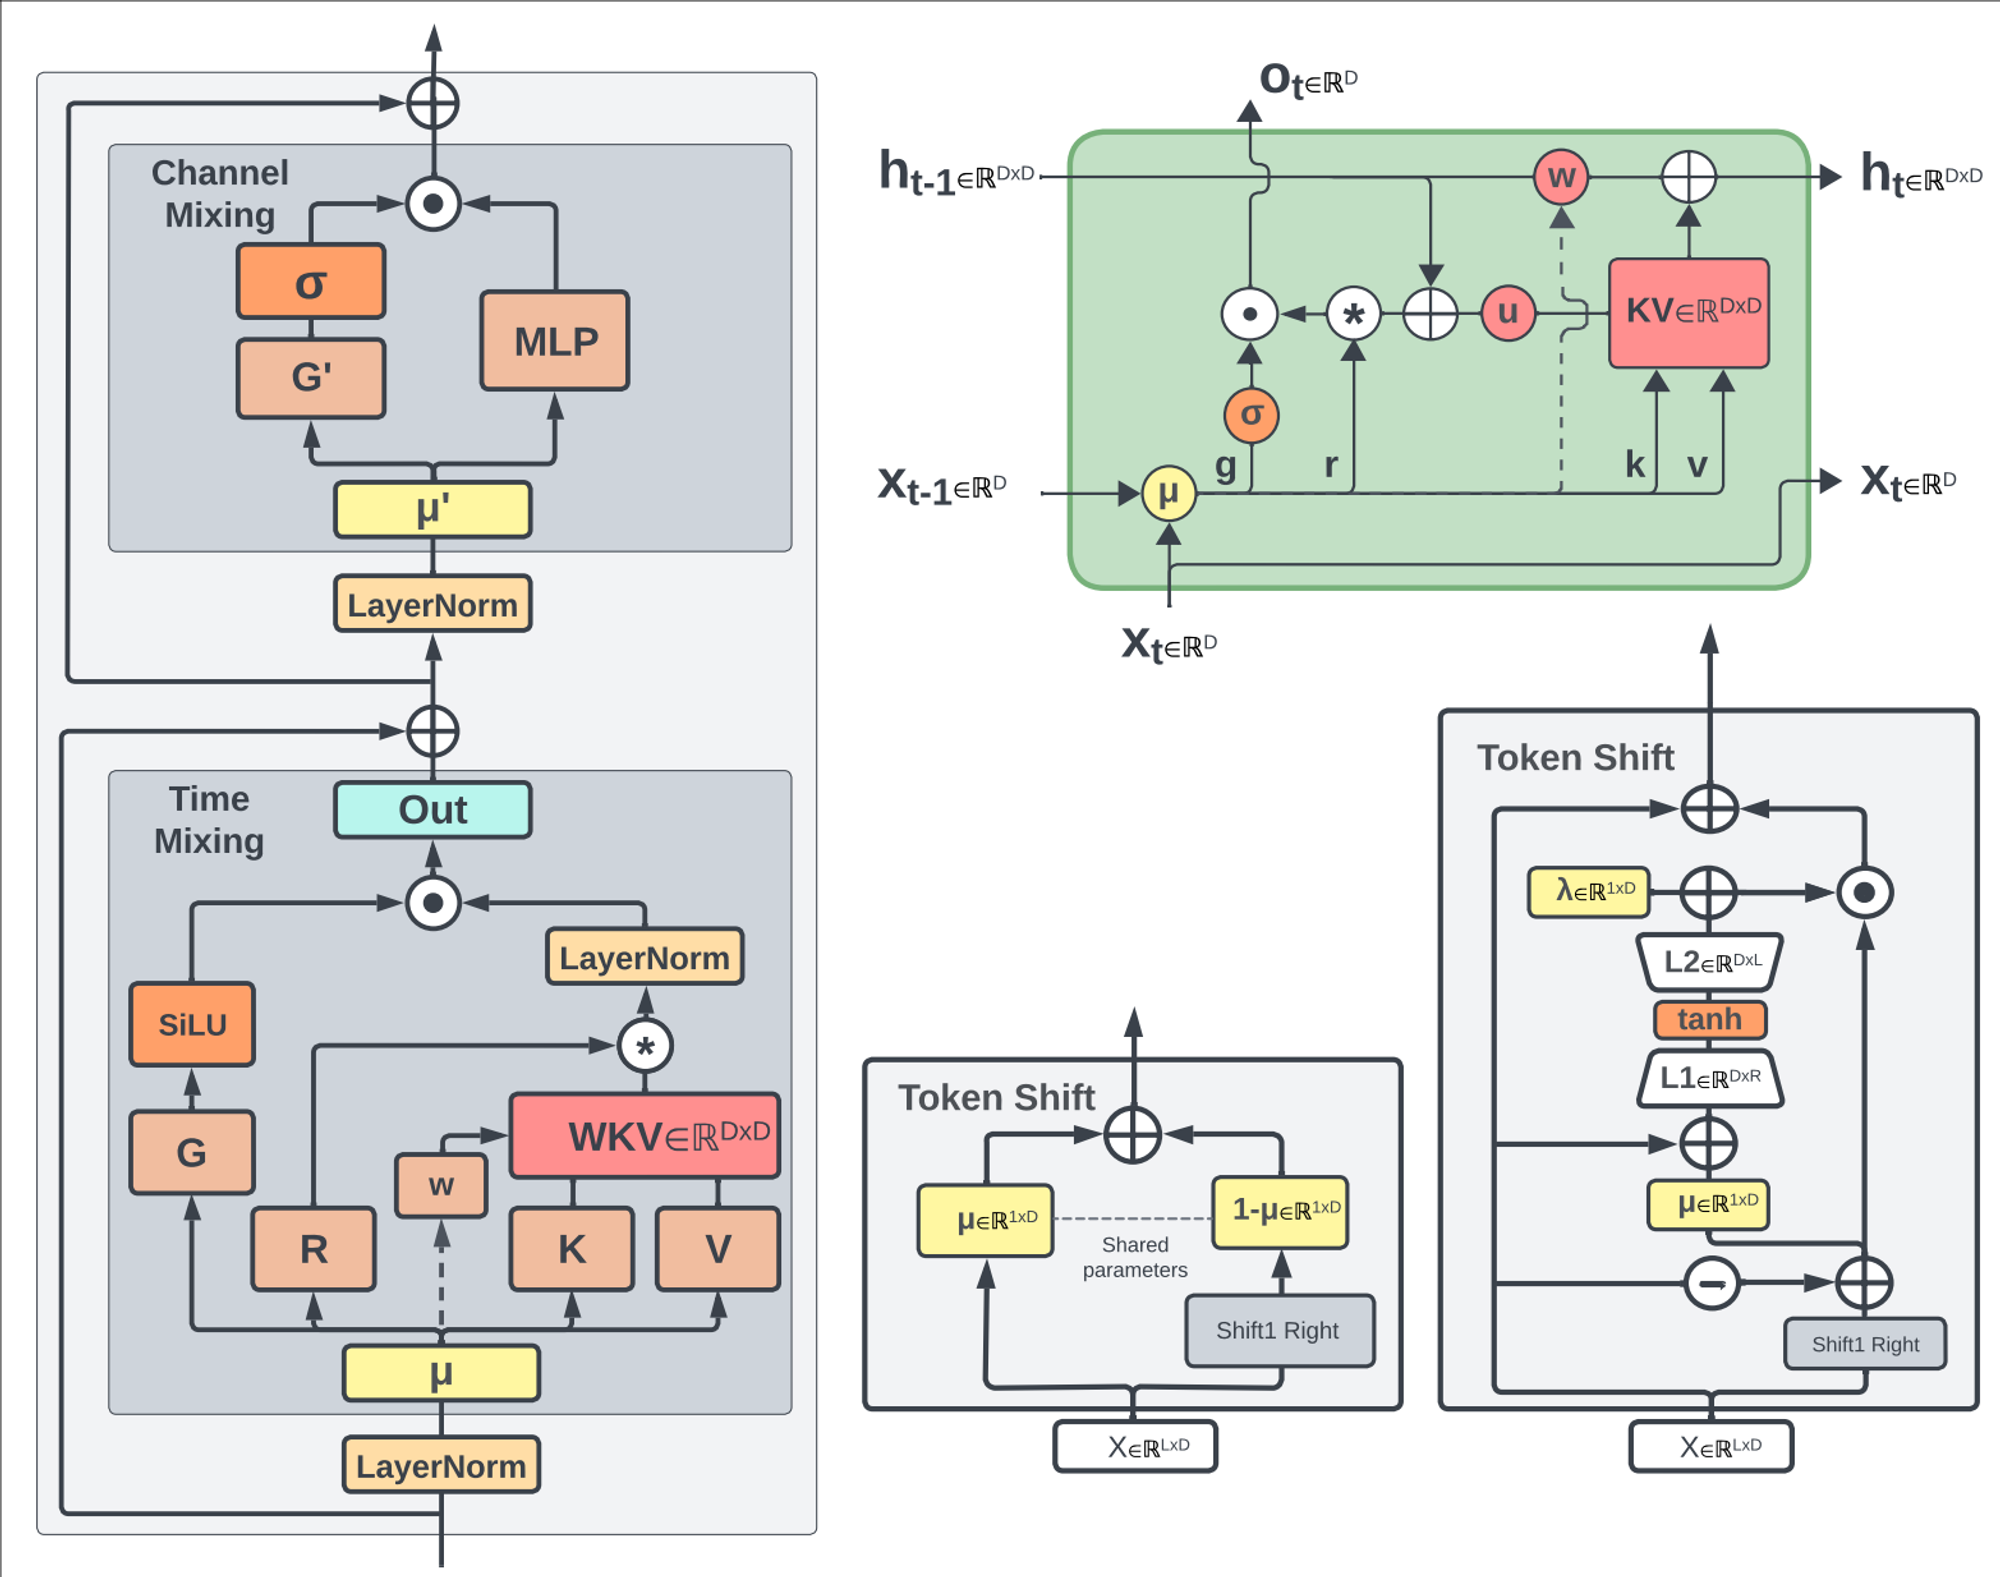
RWKV 團隊釋出 13.3B 參數的 G1j 基礎模型,並封裝 Transformers、LoRA 與 TileLang 推論支援。固定大小的循環狀態可避開隨上下文增長的 KV cache,但模型沒有安全或能力評測,亦不能直接視為成熟聊天助手。
 最新模型
阿里雲更新 Qwen3.8-Max 的託管快照,主攻工程級程式開發、多工具協作及視覺理解,並保留百萬 token 上下文。Code Arena 暫列第一,但樣本較少且排名區間重疊,尚不足以證明穩定超越其他旗艦模型。
 最新模型
Ai2 開源 BenchMIRT,從逾 3.4 萬道題目的模型作答模式中分離安全與一般推理等潛在能力。實驗顯示部分安全基準主要反映推理表現,精選一成題目亦能大致保留能力排序,但資料只涵蓋截至 2025 年初的模型。
 最新模型
Google 為三款 Gemini Flash 模型加入 agentic video processing,模型可按需載入畫面、音訊或逐字稿,而非預先以固定幀率處理整段影片。官方宣稱最多節省 88% token、降低 66% 成本,但短片的首 token 延遲及評測可重現性仍待檢驗。
 推論系統
llama.cpp 修正 Qwen3.8-Flash-Next 在草稿 token 被拒絕時無法正確回滾 SSM 與卷積狀態的問題。單張 RTX PRO 6000 測試顯示程式碼解碼由 123 增至 183 token/s,但結果仍侷限於特定量化、草稿頭與單一工作槽。
 推論系統
LMDeploy 0.17.0 為 TurboMind 加入 DeepEPv2 專家平行後端,並讓 KV connector 接上 Mooncake Store。新版亦支援 Kimi K2.6、非二次冪頁面與結構化回應,但未提供跨硬體的端到端效能數據。
 最新模型
Anthropic 推出具 100 萬 token 上下文的 Claude Fable 5.1,將快取讀取價格降低 75%,並加入逐訊息推理力度與工具間進度更新。既有 Fable 5 工作流程不能直接換模型,強制工具使用、思考區塊重用及安全路由都需要重新測試。
 代理工具
OpenAI 為個別 MCP 工具加入輸出 token 上限,並允許 app-server 的 shell 指令執行超過一小時。新版也修補壓縮歷史後遺失使用者指令與授權的問題,但內建規劃工具改為預設停用。
 最新模型
Flower Labs 推出面向推理、程式開發及長時間代理任務的 Endeavor 1.0,可使用託管服務或部署於客戶環境。首批成績接近部分前沿模型,但目前只有限量預覽及供應商自評,尚不能驗證實際部署成本與能力。
 代理工具
VS Code 1.132 至 1.135 把 Copilot、Claude 等代理接到獨立 Agent Host,使工作階段可跨視窗、遠端連線及無介面續跑。開放的 Agent Host Protocol 統一工作階段狀態,但不統一各模型的推理、權限或工具行為。