 GitHub Repo
FeyNoBg、BiRefNetの中間ステージを深化し、混合データで前景認識と境界の精細さを両立
Feynは、2億6,300万パラメータのFeyNoBgと、学習用ライブラリNoBgをオープンソースで公開し、背景除去、バッチ推論、ファインチューニングのインターフェースを統一した。公式比較では、8つのデータセットのうち4つでS-measureが首位となった一方、速度、メモリ使用量、透明度誤差などのデプロイ指標は報告されていない。
Archive
推論 runtime、量化、 serving、KV cache、成本與效能。
GitHub Repo
Feynは、2億6,300万パラメータのFeyNoBgと、学習用ライブラリNoBgをオープンソースで公開し、背景除去、バッチ推論、ファインチューニングのインターフェースを統一した。公式比較では、8つのデータセットのうち4つでS-measureが首位となった一方、速度、メモリ使用量、透明度誤差などのデプロイ指標は報告されていない。
 代理工具
GitHubはJetBrainsプラグインを更新し、エージェントワークフローからOpenTelemetryをエクスポートできるようにしたほか、持ち込みキーとカスタムエンドポイント向けに入力・出力tokenの上限を設定可能にした。Claude agent flowからMCPサーバーやカスタムエージェントへ直接接続できるようになった一方、ツール呼び出しの内容、コストの帰属、データのマスキングについては、導入チームによる検証が引き続き必要となる。
 硬體
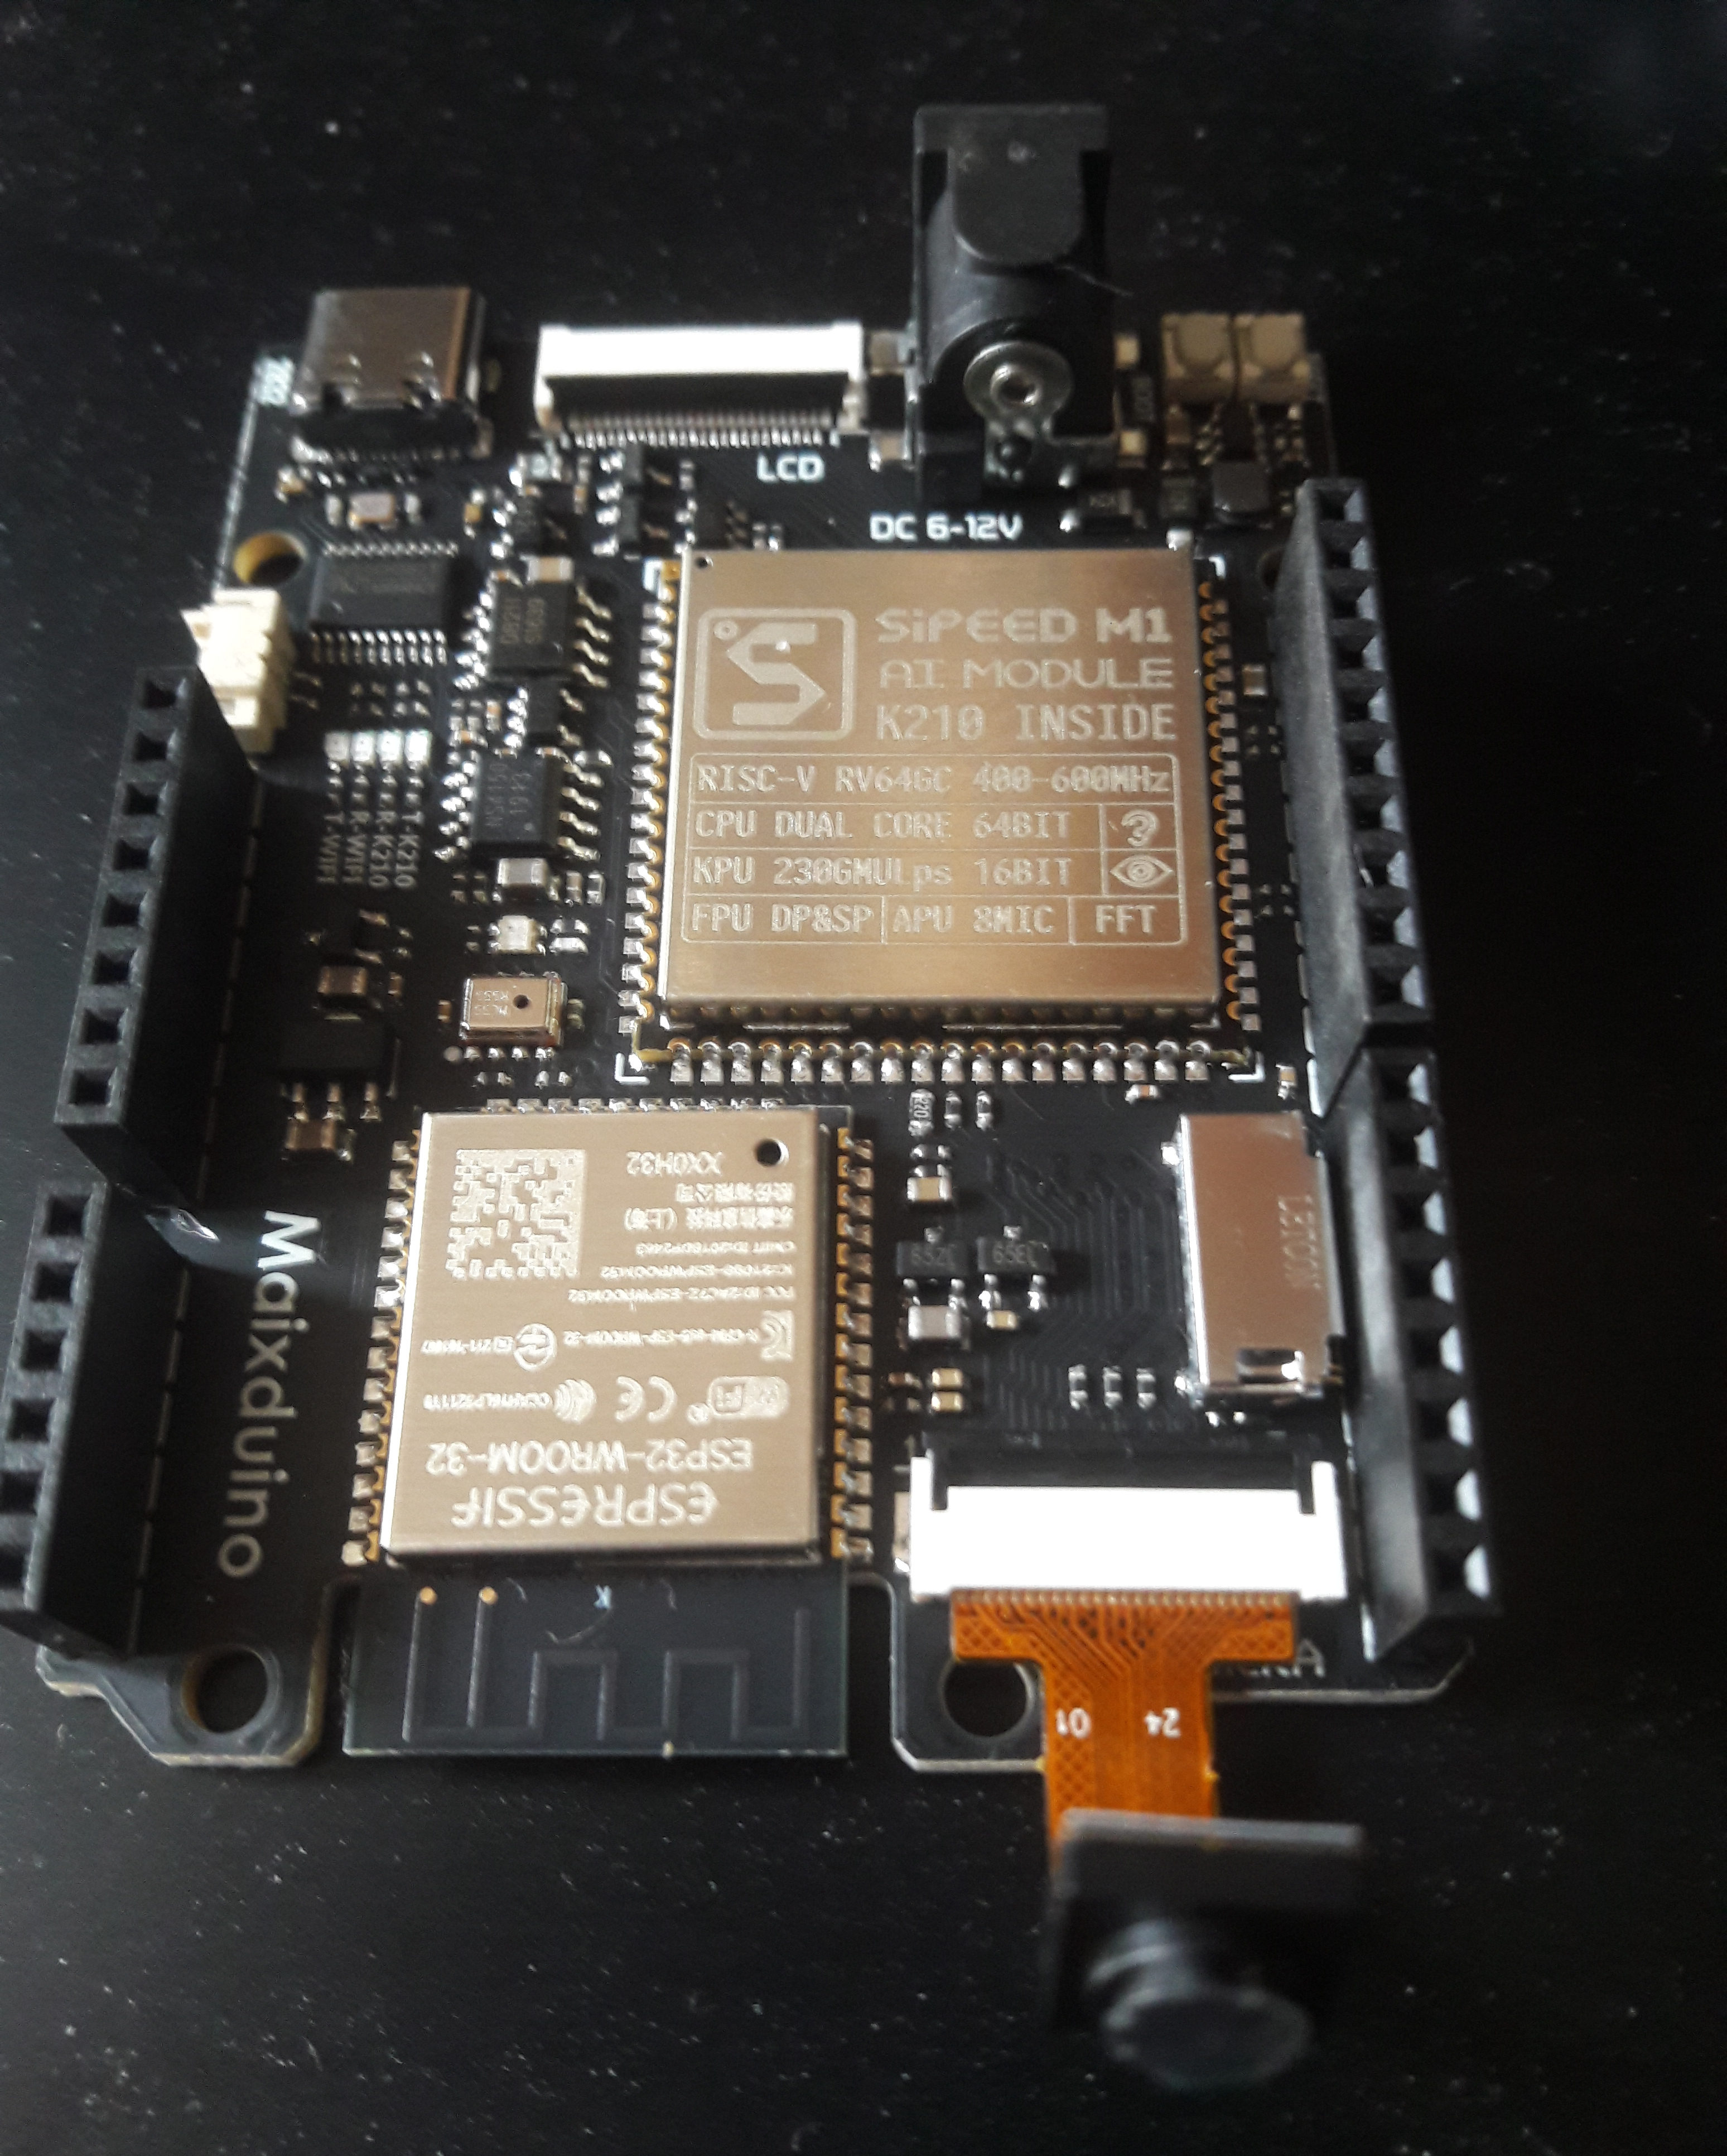
オープンソースプロジェクト「esp32-ai」は、パラメータの大部分をメモリマップドFlashへ移し、小型のTransformerコアだけを高速メモリに配置することで、約8ドルのマイクロコントローラーによる完全オフラインのテキスト生成を実現した。この成果は階層型モデルをファームウェアに組み込めることを示す一方、TinyStoriesレベルの出力を汎用的な言語理解やデバイス制御能力と同一視することはできない。
 推論系統
PaddlePaddleは、1BパラメータのHPD-Parsingを公開した。グローバルレイアウト分岐で複数のブロックデコーダーを協調させ、ページ全体をtoken単位で逐次生成する際のボトルネックを回避する。公式テストでは、既存の比較対象で最速のモデルに対して2.62倍のスループットを示したが、現時点ではカスタムvLLMパッケージに依存しており、ピーク値をエンドツーエンドのPDF処理速度と直接同一視することはできない。
 代理工具
CohereはNorthに設定可能な多段階Automationsを追加し、エージェントが条件に応じてデータを処理し、企業向けツールを呼び出し、ほかのエージェントと連携できるようにした。プラットフォームはプライベートデプロイ、MCP、監査ログをサポートするが、障害時の再試行セマンティクス、バージョン管理、定量的な信頼性データはまだ公開されていない。
 代理工具
NOOAはエージェントを単一のPythonクラスとして表現し、分散したプロンプトやツールschemaをメソッド、フィールド、docstring、型アノテーションで置き換える。公式発表ではSWE-bench Verifiedで82.2%を達成し、token使用量を約半分に削減したとしているが、フレームワークはまだ研究プレビュー段階にあり、モデルが生成したコードを実行する際には別途sandboxが必要だ。
 最新模型
Moonshot AIは7月27日、Kimi K3の完全版ウェイト、モデルカード、技術レポートを公開した。外部チームはこの3兆パラメータ級のスパースモデルを実際にデプロイし、監査できるようになった一方、少なくとも64基のアクセラレーター、カスタムコード、推論履歴への依存が明確な参入障壁となる。
 GitHub Repo
Nanbeige Labは、28兆tokenを用いてゼロから事前学習したNanbeige4.2-3Bを公開した。同一のTransformer層を繰り返し使用し、パラメータを増やさずに計算深度を高める。公式のエージェント評価では、より大規模なQwen3.5-9Bを概ね上回ったが、結果は独自の実行フレームワークに大きく依存しており、独立した再現検証がなお必要だ。
 最新模型
SGLangの新バージョンはDSparkを導入し、ドラフトモデルの信頼度に応じて各ラウンドの検証ウィンドウを変更する。また、UnifiedRadixTreeをスライディングウィンドウ、Mamba、スパースアテンションモデルのデフォルトキャッシュに設定した。複数の量子化バックエンドの削除やrollout転送形式の変更も含まれるため、既存サービスをアップグレードする前に互換性を確認する必要がある。
 最新模型
NVIDIAは、少数ステップ拡散、自己生成履歴を用いた蒸留、ストリーミングKVキャッシュによって構築した手術ロボット向け生成シミュレーターを公開した。システムはロボットの運動データをリアルタイムで受け取り、次の映像区間を合成できるが、視覚的なリアリティは物理的な正確性や臨床検証の代替にはならない。
 最新模型
inclusionAIは、Levenshtein Editingによって並列デコード中の挿入・削除・置換を可能にした100B級モデル「LLaDA2.2-flash」を公開した。一部のエージェント評価とスループットでは自社の自己回帰ベースラインを上回ったものの、コード修復や関数呼び出しの精度では依然として後れを取り、サービス対応もまだ整っていない。
 推論系統
vLLM 0.26では、KV-cacheグループごとに異なるアテンションバックエンドを選択できるようになり、オブジェクトストレージも階層型キャッシュに組み込まれた。新版ではDeepSeek-V4、ROCm、XPU、speculative decodingの最適化にも注力しているが、公式マイクロベンチマークの結果が実際のサービススループットを直接示すわけではない。