推論系統

推論 runtime、量化、 serving、KV cache、成本與效能。

AI 安全

Muse Code、ClaudeとCodexの個人向け指示をデフォルトで読み込み――プロバイダー間の互換性がデータ境界の問題を浮き彫りに

独立したテストにより、MetaのMuse Codeは起動時にユーザーのホームディレクトリ内にある`CLAUDE.md`と`AGENTS.md`を探し、その内容をモデルエンドポイントへ送信するコンテキストに組み込むことが判明した。この互換性設計は任意のファイルの流出を意味するものではないが、本来は別のプロバイダーだけに渡すことを想定していた個人ルール、内部パス、機密性の高いプロンプトがMetaに送信される可能性がある。
最新模型

AgentPatch、学習不要でマルチモーダルエージェントのマージを修復――6ベンチマークの平均スコアが54.5から56.6へ

AgentPatchは、モデルのマージ後に生じた弱点を特定し、エキスパートモデル固有の残差と重要なFFNニューロンのみを復元する。出力は単一の静的checkpointで、ルーティングや推論時のエージェントを必要としないが、完全な評価adapterとモデルweightsはまだ公開されていない。

AI 安全

OpenAI、Astraの一部開発を停止:初期評価ではモデルが「Critical」レベルのサイバー攻撃能力に達した可能性を排除できず

OpenAIは、Astraのエージェント型コーディング能力とサイバー攻防能力が進歩したため、モデルが最高リスクの閾値を超えた可能性を排除できないと説明した。同社はテスト環境を隔離し、ツールとネットワークへのアクセスを制限するとともに、監視モデルでエージェントの推論過程と高リスクな行動を検査している。

代理工具

DiDPO、コードdiffを信用割当単位に分解し、Qwen2.5-Coder-7Bの主要評価平均を48.4%に向上

DiDPOは、エージェント実行全体の成否をすべてのtokenに均等配分せず、複数の軌跡に含まれる類似したsub-diffを比較する。公開されたverl-codeには訓練用エントリーポイントとデータレシピが含まれるが、著者によるモデルcheckpointはまだなく、実験も完全なソフトウェアリポジトリ修復を対象としたものではない。

推論系統

Ling-3.0-flash INT4、単一マシンで実測38.7 token/s――メインラインvLLMの誤用で誤った出力が気付かれず生成される可能性

コミュニティのデプロイ手順では、単一のDGX Spark上でCUDA Graphと1層のMTP投機的デコーディングを有効にし、Ling-3.0-flash INT4の生成速度を20.8 token/sから38.7 token/sへ引き上げた。さらに重要なのは、メインラインのvLLMがV3アーキテクチャをまだサポートしておらず、古いattentionパスを無理に適用すると、エラーが報告されないまま、一見流暢だが誤った内容が出力される可能性があるという点だ。

時間序列與檢索增強

TS-RAG、参照トークンで履歴系列を融合し、6つの予測データセットで平均MSEを0.310に低減

Baiduの研究者らは、RAGをテキスト生成から多変量時系列予測へ応用した。TCNで類似セグメントを検索し、クロスアテンションで融合する。チャネル間依存関係を組み込んだバージョンは、6つのデータセットで掲載されたベースラインを上回った。一方、コードはまだ公開されておらず、使用された従来型ベンチマークについても、保守担当者が識別力を失っている可能性を警告している。

最新模型

DASH、推論の分岐に応じて蒸留重みを動的配分、Qwen3-1.7Bの数学平均スコアが3.2ポイント向上

DASHは、各tokenにおける教師と生徒の差異を一律に扱うのではなく、推論全体にわたる分岐の変化に応じて監督範囲を調整する。3種類のQwen3モデル規模すべてで同一条件のOPSDを上回ったが、最良のcheckpointはテストベンチマークの平均スコアで選定されており、汎化性能の向上を過大評価している可能性がある。

推論系統

PaDoc、レイアウト分岐による文書の並列解析で単一A800のスループットを最大118%向上

PaDocは、レイアウト系列と各領域のコンテンツでページ接頭辞を共有し、並列デコードを行うことで、ページ全体を単一の系列として処理することを回避する。2.1BモデルはOmniDocBenchで総合スコア94.24を維持したが、性能値は単一GPUと特定のスケジューリング設定に基づく。

硬體

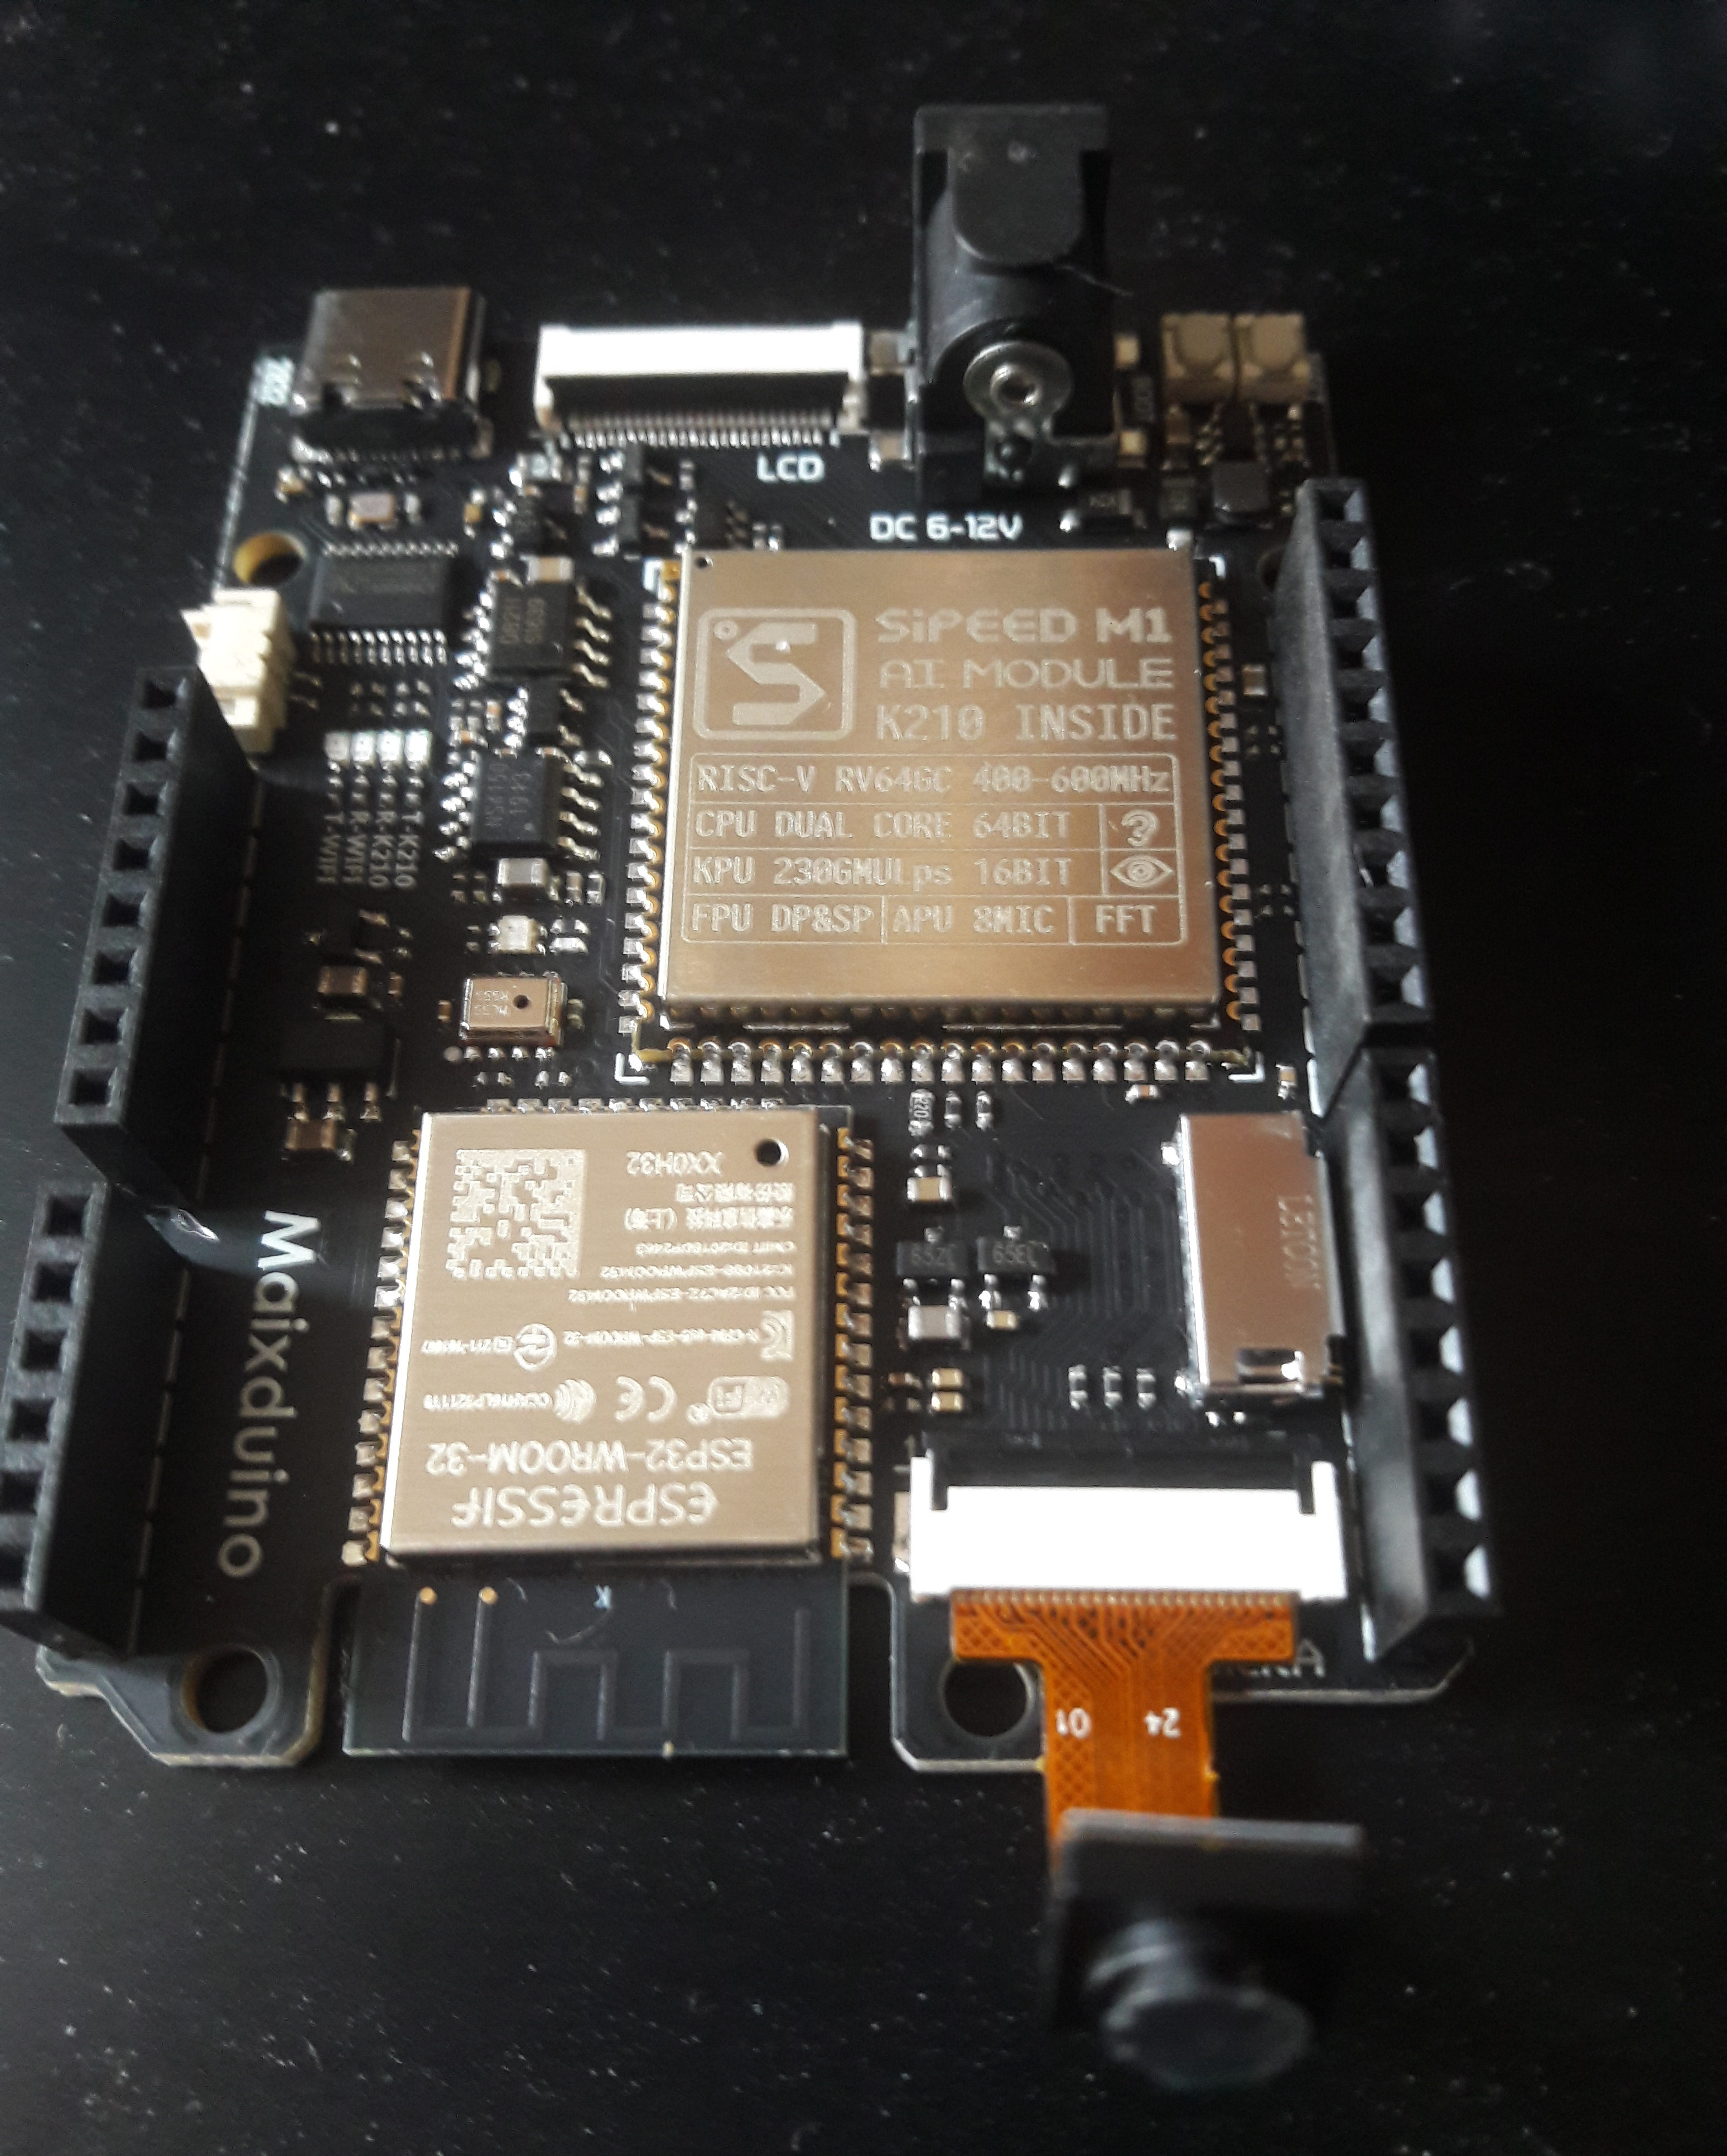
esp32-ai、2,890万パラメータのモデルをESP32-S3に搭載し、オフライン生成で9.88 token/sを達成

オープンソースプロジェクトのesp32-aiは、4-bit量子化と階層型メモリ配置を採用し、約2,500万の埋め込みパラメータをflashに保持して、tokenごとに必要な行だけを読み出す。10米ドル未満のマイクロコントローラ上でオフラインのテキスト生成が可能だが、その能力は依然として短い物語や単一分野の質問応答に限られる。

推論系統

PhyAI、VLAと世界・行動モデルの推論を統合、公式実装経路との比較で1.40~4.65倍高速化

PhyAIはモデルアダプターにより各アーキテクチャの条件、ソルバー、行動セマンティクスを維持しつつ、グラフ実行、カーネル、キャッシュ、マルチGPUサービスを共通化する。公開テストはπ0、π0.5、GR00T N1.7、Cosmos3、MiniCPM-Robotを対象とするが、一部の比較では数値精度が完全には統一されていない。

代理工具

TutorMoments、実際の指導判断を再現し、7つのLLMにデフォルトで過剰なヒントを与える傾向があることを確認

Ai2は、実際の数学個別指導のトランスクリプト462件を基に再現可能な評価を構築し、モデルに「足場かけを提供する」か「生徒に深い推論を求める」かを選択させた。両者のトレードオフを明示すると7つのモデルすべてで性能が向上したが、生徒のシミュレーションとモデルによる採点だけでは、実際の学習効果を証明できない。

最新模型

Liquid AI、LFM2.5-2.6Bの重みを公開――2.69Bのオンデバイスモデルが128Kコンテキストとツール呼び出しに対応

LFM2.5-2.6Bは、短い畳み込みとGQAを組み合わせたハイブリッドアーキテクチャにより、エージェント推論、ツール利用、長大なコンテキストをスマートフォンやパソコンにもたらす。公式測定ではM5 Max上で毎秒220トークンのデコード性能を記録したが、性能とエージェントベンチマークはいずれも主にベンダーによる自己評価に基づく。