 最新模型
LongEarth-R1、最長30フレームの衛星画像系列を推論し、12の時空間タスクすべてで比較モデルを上回る
LongEarth-Benchは11万7,000枚のリモートセンシング画像を約12万組の長系列QAに整理し、地形の変化、異常、欠損状態をモデルに追跡させる。Qwen2.5-VL-7BをベースとするLongEarth-R1は、フレーム番号、構造化推論、時空間報酬を導入したが、データ、重み、コードはまだ公開されていない。
Archive
推論 runtime、量化、 serving、KV cache、成本與效能。
最新模型
LongEarth-Benchは11万7,000枚のリモートセンシング画像を約12万組の長系列QAに整理し、地形の変化、異常、欠損状態をモデルに追跡させる。Qwen2.5-VL-7BをベースとするLongEarth-R1は、フレーム番号、構造化推論、時空間報酬を導入したが、データ、重み、コードはまだ公開されていない。
 推論系統
DARTreeは、拡散ドラフトモデルの因果補正を単一パスから複数分岐へ拡張し、ノード単位のheap探索を深さごとのバッチ展開に置き換える。単一のRTX 6000 Adaを用いたテストでは、7タスクすべてで平均高速化率がDFlash、DDTree、Dominoを上回ったが、コードはまだ公開されていない。
 推論系統
TEMPOは、トークン数やアクティブ化されたエキスパート数を単に均等化するのではなく、HBMからの重みロードとGEMMタイルのパディングを同時に推定する。SGLangのプロトタイプは、一部のQwen3‑235Bトラフィックでスループットを4~6%向上させた一方、通信律速のDeepSeek‑V3では追加コストだけが残った。
 推論系統
FlashDriveは、視覚エンコーディング、LLM prefill、推論token、軌跡デノイジングという4つのボトルネックを同時に処理し、RTX PRO 6000上でAlpamayo 1.5-10Bの単一ウィンドウ・レイテンシを717ミリ秒から151ミリ秒に短縮した。オープンソース実装はリアルタイム推論に近づいたが、専用のファインチューニングを経ており、クローズドループ評価も100本のシミュレーションクリップに限られる。
 最新模型
AlayaWorldは、インタラクティブ世界モデルの空間メモリと条件付けパイプラインを刷新し、カメラ制御、過去フレーム、生成コンテンツに整合した因果VAE表現を使用するようにした。新たな報告ではWBenchで一貫性の総合スコア首位を記録したが、新版の重みと推論コードはまだ同時公開されていない。
 推論系統
GCacheは、隣接するデノイズステップ間の局所的な類似度で再計算の要否を決めるのではなく、最終的な画質への影響が最小となるキャッシュ再利用シーケンスを探索する。Wan2.1で2.17倍の高速化を維持しながら偏差を大幅に抑えた一方、方策探索には複数のH100が必要で、実装もまだ公開されていない。
 推論系統
vTokenはPagedAttentionのブロック層の上に、トークンから物理位置へのマッピングを追加し、退避後に点在するKVの空き領域を再圧縮する。vLLMのプロトタイプでは保持ブロック数を最大72.3%削減したが、評価は依然として単一ノード・単一GPUと、7B~8B級モデルが中心だ。
 推論系統
新手法は、数千から1万個の有効な文字列に対してtrieの状態とtoken maskを事前構築し、汎用文法コンパイルにおけるカーディナリティのボトルネックを回避する。著者らの測定では、バッチサイズ256で毎秒219リクエストを処理した。ただし実装はまだ公開されておらず、この数値には既存のguided decoding経路を迂回する統合上の効果も含まれる。
 最新模型
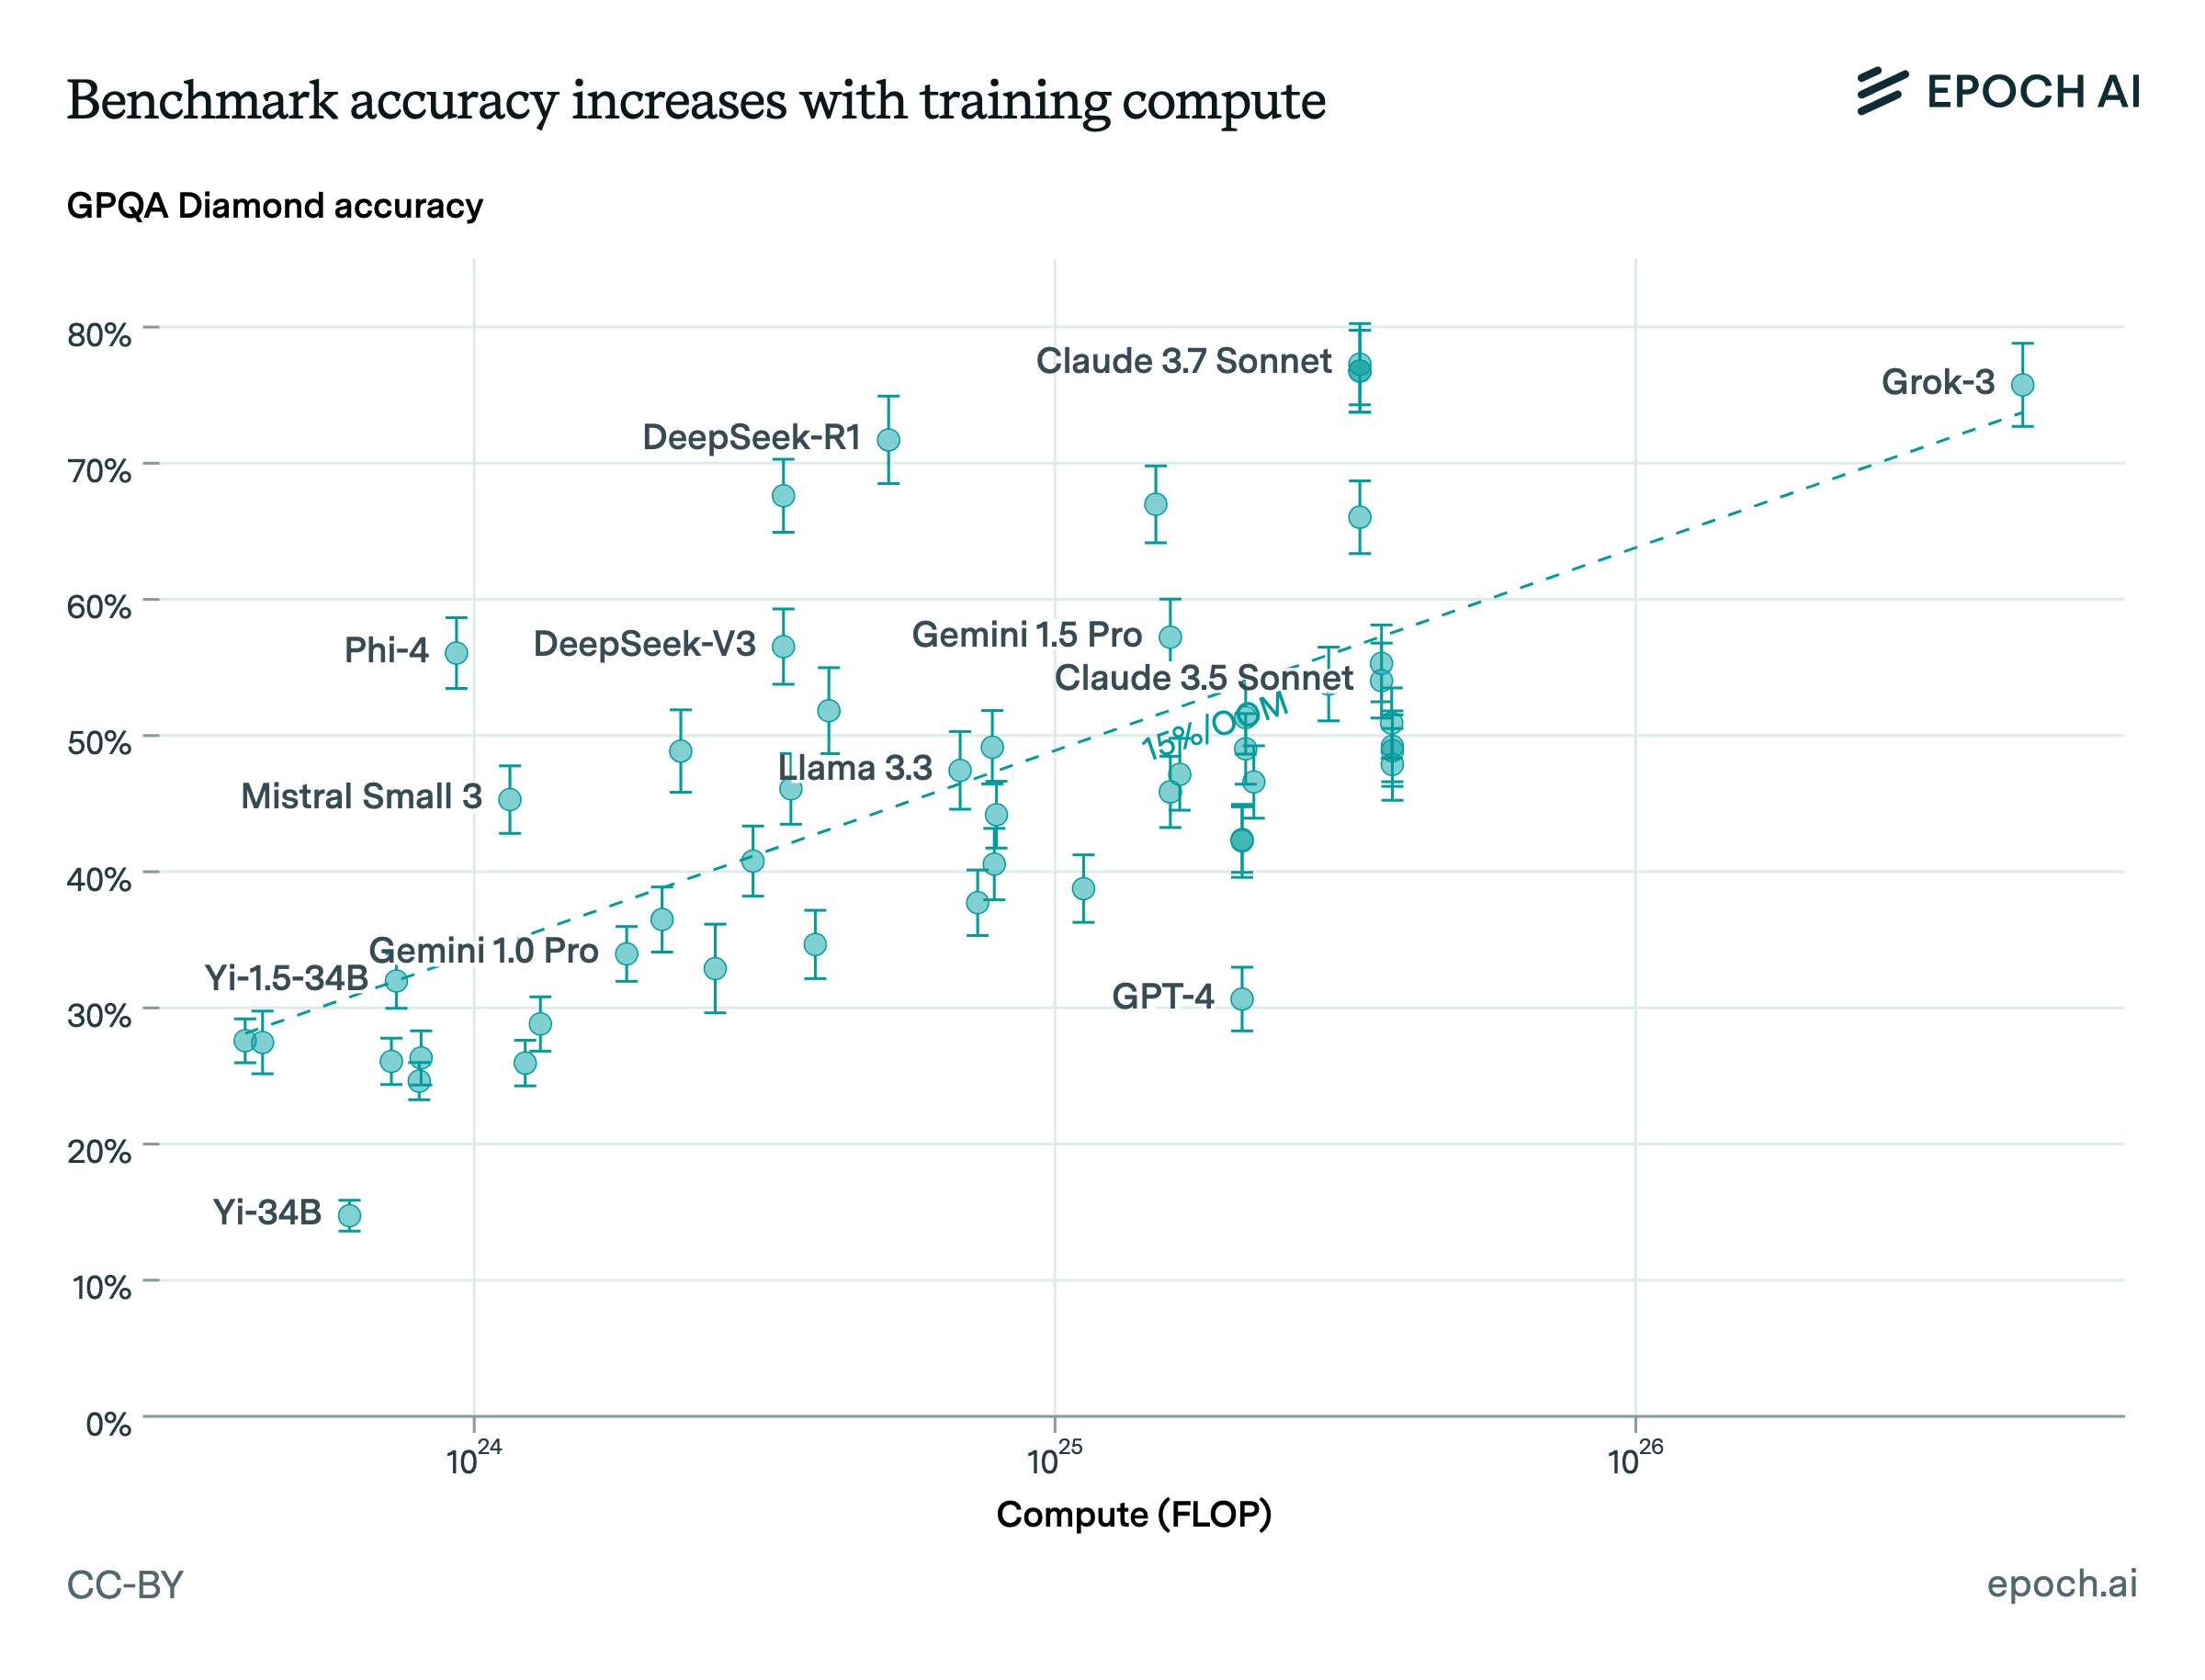
事前登録研究により、Qwen2.5-7BとLlama-3-8Bは、GPQA Diamondの問題の大半で投票数を増やすほど誤答に収束しやすくなることが分かった。全体の平均スコアはなおわずかに上昇しており、集約指標が問題ごとの性能低下を覆い隠すことを示している。
 最新模型
LTX‑2.5は、学習可能な22Bモデルと8ステップ蒸留モデルの重みを公開し、ショットをまたぐキャラクター、音声、シーンの一貫性を追加した。完全なクイックスタート用コンポーネントは約66 GiBで、Diffusers対応には依然としてmainブランチのインストールが必要だ。また、モデルには売上高基準のコミュニティライセンスによる制限もある。
 最新模型
AlibabaのQwenがQwen3.8‑2.4T‑A95Bを公開した。512のエキスパートと、線形Attentionおよび標準Attentionのハイブリッド構成により、最長約101万tokenに対応する。推論深度は調整できるものの、入力はテキストのみで、思考モードを無効化できない。実際のデプロイ要件は、一般的なオープンウェイトモデルをはるかに上回る。
 最新模型
新たな研究で、4つのオープンウェイトモデルの生成上限を64から4,096 tokenまで引き上げたところ、3つの推論ベンチマークすべてで首位モデルが入れ替わった。打ち切られた出力を除外しても、予算を増やした際に正解から不正解へ転じた問題が3~19%あり、単一のtoken設定だけではデプロイするモデルを十分に選定できないことが示された。