 最新模型
TranslatePsy、アフリカ言語翻訳モデルを公開——0.8B~4B版は量子化してオフライン実行可能
Tether AI Researchは、Qwen3.5をファインチューニングしたAfriSLMと、ブラウザやスマートフォン向けの17M~43MパラメータのAfriNanoをリリースした。モデルは最大19のサハラ以南アフリカ言語に対応するが、大規模ベースラインを上回るとの結論は主に自動評価指標に基づいており、母語話者の専門家による評価はまだ行われていない。
Archive
推論 runtime、量化、 serving、KV cache、成本與效能。
最新模型
Tether AI Researchは、Qwen3.5をファインチューニングしたAfriSLMと、ブラウザやスマートフォン向けの17M~43MパラメータのAfriNanoをリリースした。モデルは最大19のサハラ以南アフリカ言語に対応するが、大規模ベースラインを上回るとの結論は主に自動評価指標に基づいており、母語話者の専門家による評価はまだ行われていない。
 推論系統
Unslothは、Qwen3.8-Flash-NextとGLM-5.3-FlashでMulti-Token Predictionをデフォルトで有効化し、MLX、マルチGPU、ROCmの各経路も改善した。公式が掲げる「最大2倍」には完全なベンチマークマトリクスが添付されておらず、Qwenの技術文書に記載された低並行時の高速化は1.3~1.7倍となっている。
 代理工具
Googleは、Android専用スキルの自動選択とGemma 4によるローカル推論をAndroid Studioの安定版チャンネルに導入した。コードを開発マシン内に保持できる一方、ローカル実行だからといって、エージェントに十分な権限分離や検証可能な品質が備わっているとは限らない。
 代理工具
Coderは、Cursorのクラウドエージェントによる外部の制御ループを維持しつつ、コマンド、ファイル、ツールの操作を企業が管理するワークスペースへ移す。この階層化により、既存のRBAC、ファイアウォール、監査機能を適用できるが、推論とモデルへのトラフィックは引き続きプロバイダーを経由するため、完全なプライベートデプロイと同一視はできない。
 最新模型
MetaはMuse Sparkを更新し、長期的に動作するエージェント、ソフトウェア開発、複数の話題が混在する会話でのタスク追跡を重点的に強化した。社内比較では、ツール呼び出し回数とtoken使用量がともに減少している。モデルはすでにMuse CodeとAPIで提供されているが、最高推論モード、オープンウェイト、完全に再現可能な評価結果はまだ公開されていない。
 最新模型
GoogleはGemini 3.8 Flashを正式に本番環境向けとして提供し、100万tokenのコンテキスト、調整可能な推論強度、新たなAPI移行要件を導入した。共通のコアを持つFlash Cyberは脆弱性の発見と自動修正に特化するが、審査を通過した防御側の利用者にのみFairwindプログラムを通じて提供される。
 最新模型
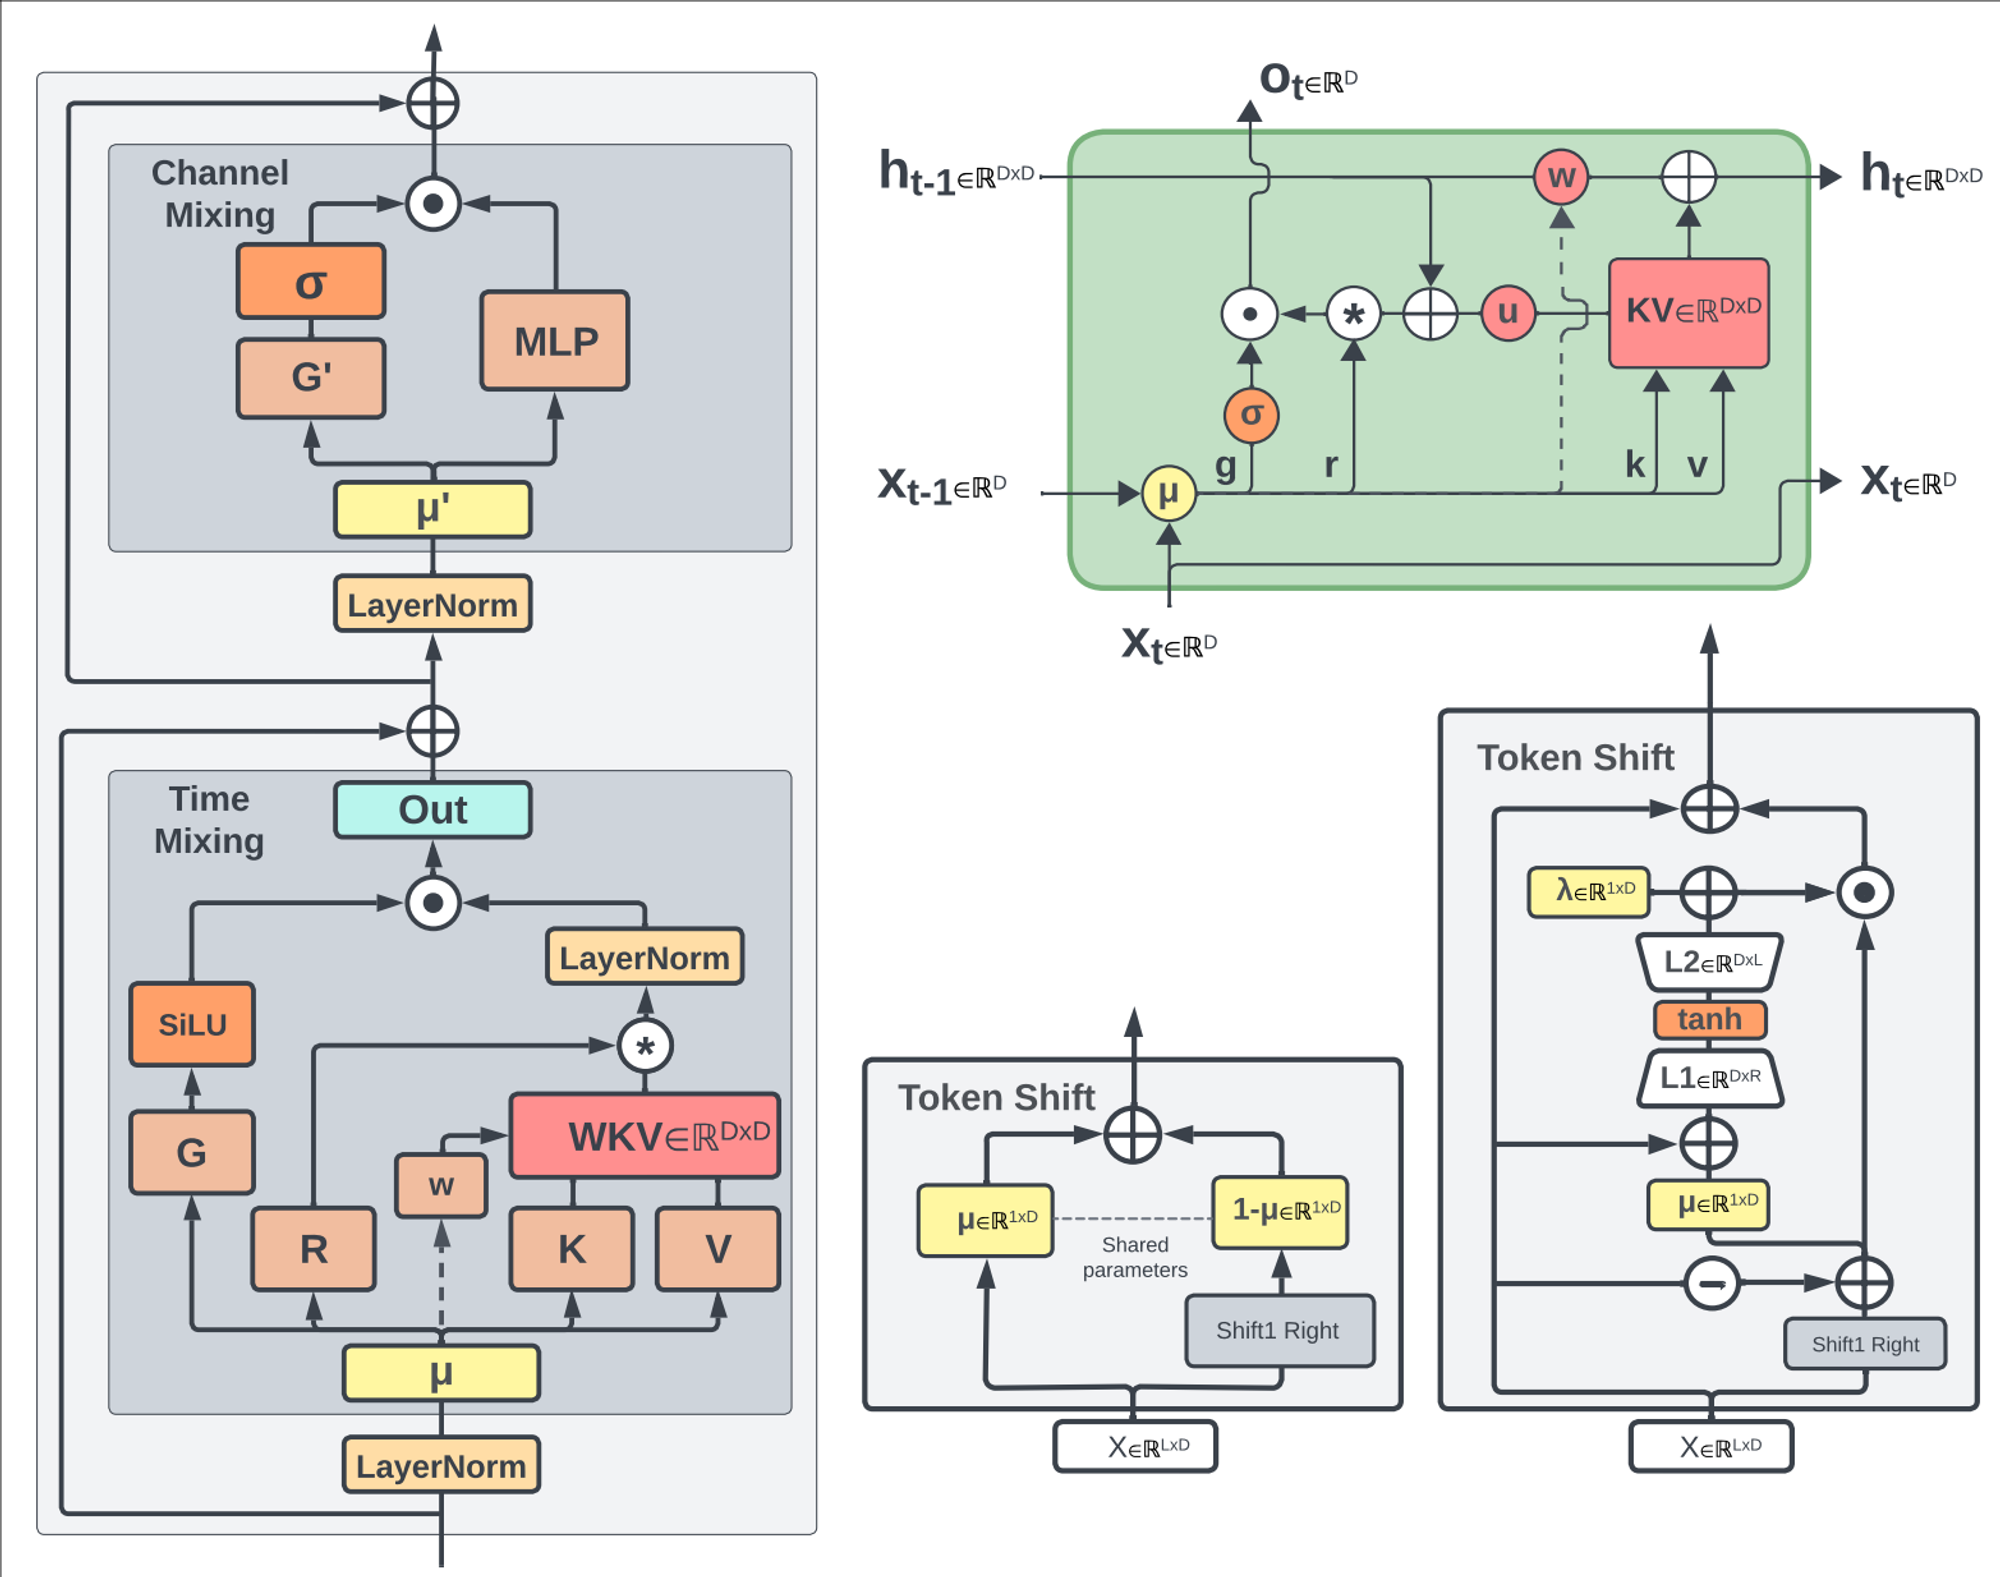
RWKVチームは、13.3BパラメータのG1jベースモデルを公開し、Transformers、LoRA、TileLangによる推論サポートをパッケージ化した。固定サイズの再帰状態により、コンテキストとともに増大するKV cacheを回避できる一方、安全性や能力の評価は示されておらず、成熟したチャットアシスタントと直接みなすことはできない。
 最新模型
Alibaba CloudはQwen3.8-Maxのホステッドスナップショットを更新し、エンジニアリング規模のソフトウェア開発、複数ツールの連携、視覚理解を重点的に強化する一方、100万tokenのコンテキストを維持した。Code Arenaでは暫定首位に立つが、サンプル数が少なく順位区間も重複しているため、他のフラッグシップモデルを安定的に上回ったと証明するには不十分だ。
 最新模型
Ai2がBenchMIRTをオープンソース化し、3万4,000問超に対するモデルの回答パターンから、安全性や一般推論などの潜在能力を分離した。実験では、一部の安全性ベンチマークが主に推論性能を反映していることや、厳選した約1割の問題でも能力順位をおおむね維持できることが示された。ただし、データの対象は2025年初頭までのモデルに限られる。
 最新模型
Googleは3つのGemini Flashモデルにagentic video processingを追加した。モデルは動画全体を固定フレームレートで事前処理するのではなく、必要に応じて映像、音声、文字起こしを読み込める。公式発表ではtokenを最大88%、コストを66%削減できるとしているが、短い動画でのTime to First Tokenと評価の再現性は、なお検証が必要だ。
 推論系統
llama.cppは、Qwen3.8-Flash-Nextでドラフトtokenが拒否された際にSSMと畳み込み状態を正しくロールバックできない問題を修正した。RTX PRO 6000を1基使用したテストでは、コードのデコード性能が123 token/sから183 token/sに向上したが、この結果は特定の量子化方式、ドラフトヘッド、単一ワークスロットに限られる。
 推論系統
LMDeploy 0.17.0は、TurboMindにDeepEPv2のexpert parallelバックエンドを追加し、KV connectorをMooncake Storeに接続した。新バージョンはKimi K2.6、2の累乗に限定されないページサイズ、構造化レスポンスにも対応するが、ハードウェアをまたぐエンドツーエンドの性能データは示されていない。