 GitHub Repo
Ollama 社群提出串流順序修補,文字接工具呼叫可能讓 Responses 客戶端拒收
10 月 5 日的社群案例指出,Ollama 在先輸出文字、再呼叫工具時,可能重複使用輸出索引並漏送訊息完成事件。修補提案已附回歸測試,但尚未合併,也未進行實際模型推論驗證。
Archive
AI 晶片、GPU、資料中心、邊緣裝置與硬體安全。
GitHub Repo
10 月 5 日的社群案例指出,Ollama 在先輸出文字、再呼叫工具時,可能重複使用輸出索引並漏送訊息完成事件。修補提案已附回歸測試,但尚未合併,也未進行實際模型推論驗證。
 GitHub Repo
Transformers 5.12.0 的社群案例指出,啟用節省 CPU 記憶體的載入選項後,其他訓練程序仍可能配置完整模型,導致主機記憶體耗盡。官方文件確認該選項應避免各程序重複載入,但問題根因與修復狀態仍待上游確認。
 GitHub Repo
PyTorch 開發版的重現案例顯示,非整數縮放倍率若仍產生相同輸出尺寸,CUDA 雙三次插值可能直接回傳輸入值。社群已提出修補,但尚未合併,正式版本影響範圍仍待確認。
 GitHub Repo
vLLM 開發版的重現案例顯示,啟用批次不變性後,模型資訊快取與模組匯入順序仍可能改變推論結果。社群已提出修補,但尚未合併,正式版本與其他硬體的影響範圍仍待確認。
 GitHub Repo
Ollama 0.35.1 的社群重現案例指出,lfm2:24b 可能漏掉特定位置的 python 字串,連帶改變 JSON 值與文件內容。問題目前仍待上游確認,尚無足夠證據判定是分詞解碼、模型封裝或硬體路徑造成。
 GitHub Repo
vLLM 0.30.0 的社群案例顯示,圖片請求加入 chat_template_kwargs 後,模型可能只收到文字,伺服器仍回傳成功。問題尚待上游確認,結合視覺輸入與思考模式控制的部署應驗證實際輸入。
 GitHub Repo
新版讓專家常駐 GPU,以資料路由減少反覆聚合權重的成本,官方初步測試回報約 2.7 倍吞吐量。兆參數配置已完成系統測試,但採用隨機路由,實際訓練品質與穩定性仍待驗證。
 GitHub Repo
固定種子與零溫度的 Qwen3-8B 測試,仍因核心配置不同而出現輸出差異。相關 PyTorch 修補尚未合併,影響範圍須依版本、硬體與編譯路徑確認。
 GitHub Repo
一組單機測試顯示,調整記憶體設定可減少解碼時的 GPU 等待。官方仍維持預設關閉,收益與容量限制須依部署環境驗證。
 GitHub Repo
Guidance 後端在特定設定下會改寫固定物件,讓合法輸出遭拒、錯誤版本反而通過。社群已提交修補與測試,但尚未合併,受影響版本範圍仍待確認。
 AI 研究
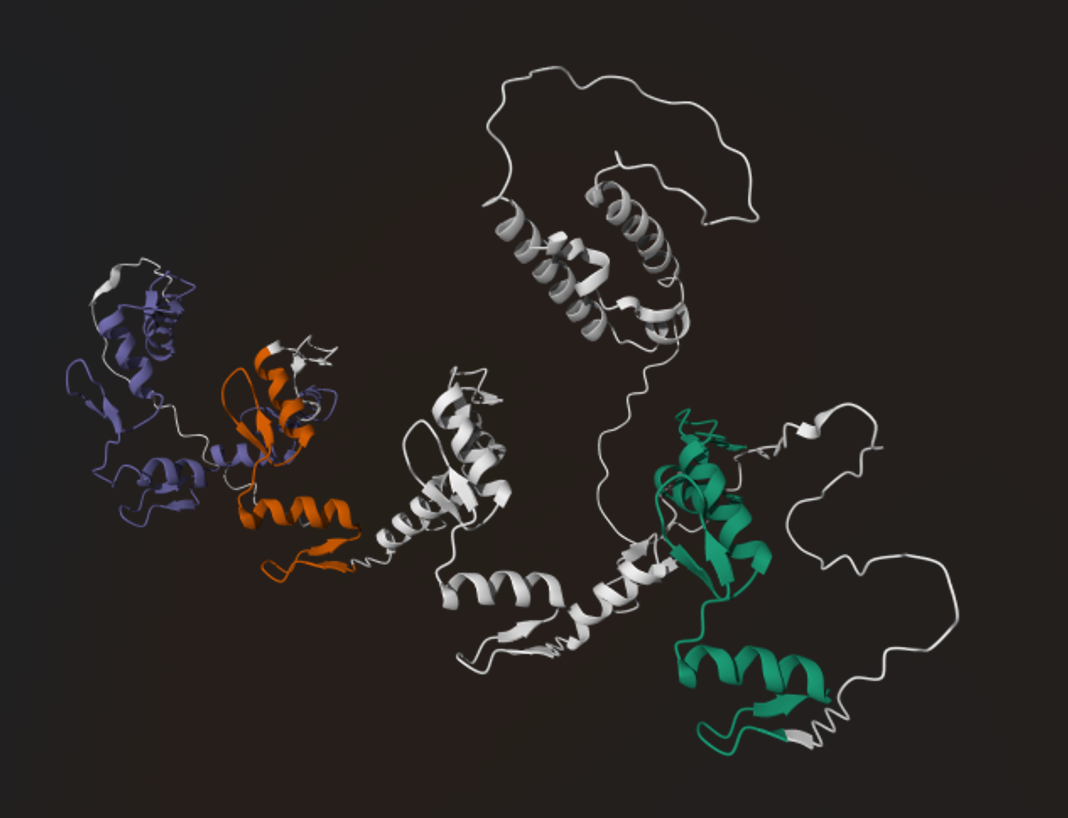
合作團隊針對 2,812 組病毒蛋白質體,公開高信心複合體預測及 GPU 運算流程。部署仍需大型 GPU 與叢集配套,結構預測也須經實驗驗證。
 GitHub Repo
系統以實測 GPU 核心時間預測服務瓶頸,再由代理把候選優化落實到推論框架。團隊已公開程式碼與測試案例,但收益受模型和負載限制,部分修補仍待上游審查。