 GitHub Repo
Linus Torvalds 劃清 Linux Kernel 對 AI 的底線:不禁用,也不讓反 AI 立場綁架專案
在 Sashiko 與 Patchwork 串接討論中,Linus Torvalds 明確表示 Linux kernel 不是反 AI 專案;反對者可以依開源規則 fork,或選擇離開。這不是全面放行 AI 產物,而是把 AI 工具納入既有技術評估:結果要有用、責任仍在人類維護者與提交者身上。
Archive
AI 晶片、GPU、資料中心、邊緣裝置與硬體安全。
GitHub Repo
在 Sashiko 與 Patchwork 串接討論中,Linus Torvalds 明確表示 Linux kernel 不是反 AI 專案;反對者可以依開源規則 fork,或選擇離開。這不是全面放行 AI 產物,而是把 AI 工具納入既有技術評估:結果要有用、責任仍在人類維護者與提交者身上。
 AI 科學與高效能運算
Genesis Mission 首批計畫涵蓋核能、關鍵礦物、晶片設計與商用核融合,研究團隊將共用模型、代理框架及高效能運算資源。OpenAI 另承諾 Codex 與 API 額度,支援約 2,000 名研究者及兩項大規模科學實驗。
 訓練系統
研究團隊針對 DeepSeek-V4 家族重做平行策略、通訊排程、核心與算子融合,使 Ascend 訓練效率達開源基線的 2.93 倍。系統再以求解器驗證資料訓練運籌研究模型,但程式、資料與硬體測量仍需更完整的公開重現。
 推論系統
BaseRT 新增手寫的稠密、MoE GEMM 與 FlashAttention 核心,將提示階段的矩陣運算交給 M5 GPU 內的神經加速器。團隊在 M5 Pro 報告顯著領先 llama.cpp 與 MLX,但數據目前仍來自開發者自己的單機測試。
 具身 AI/機器人
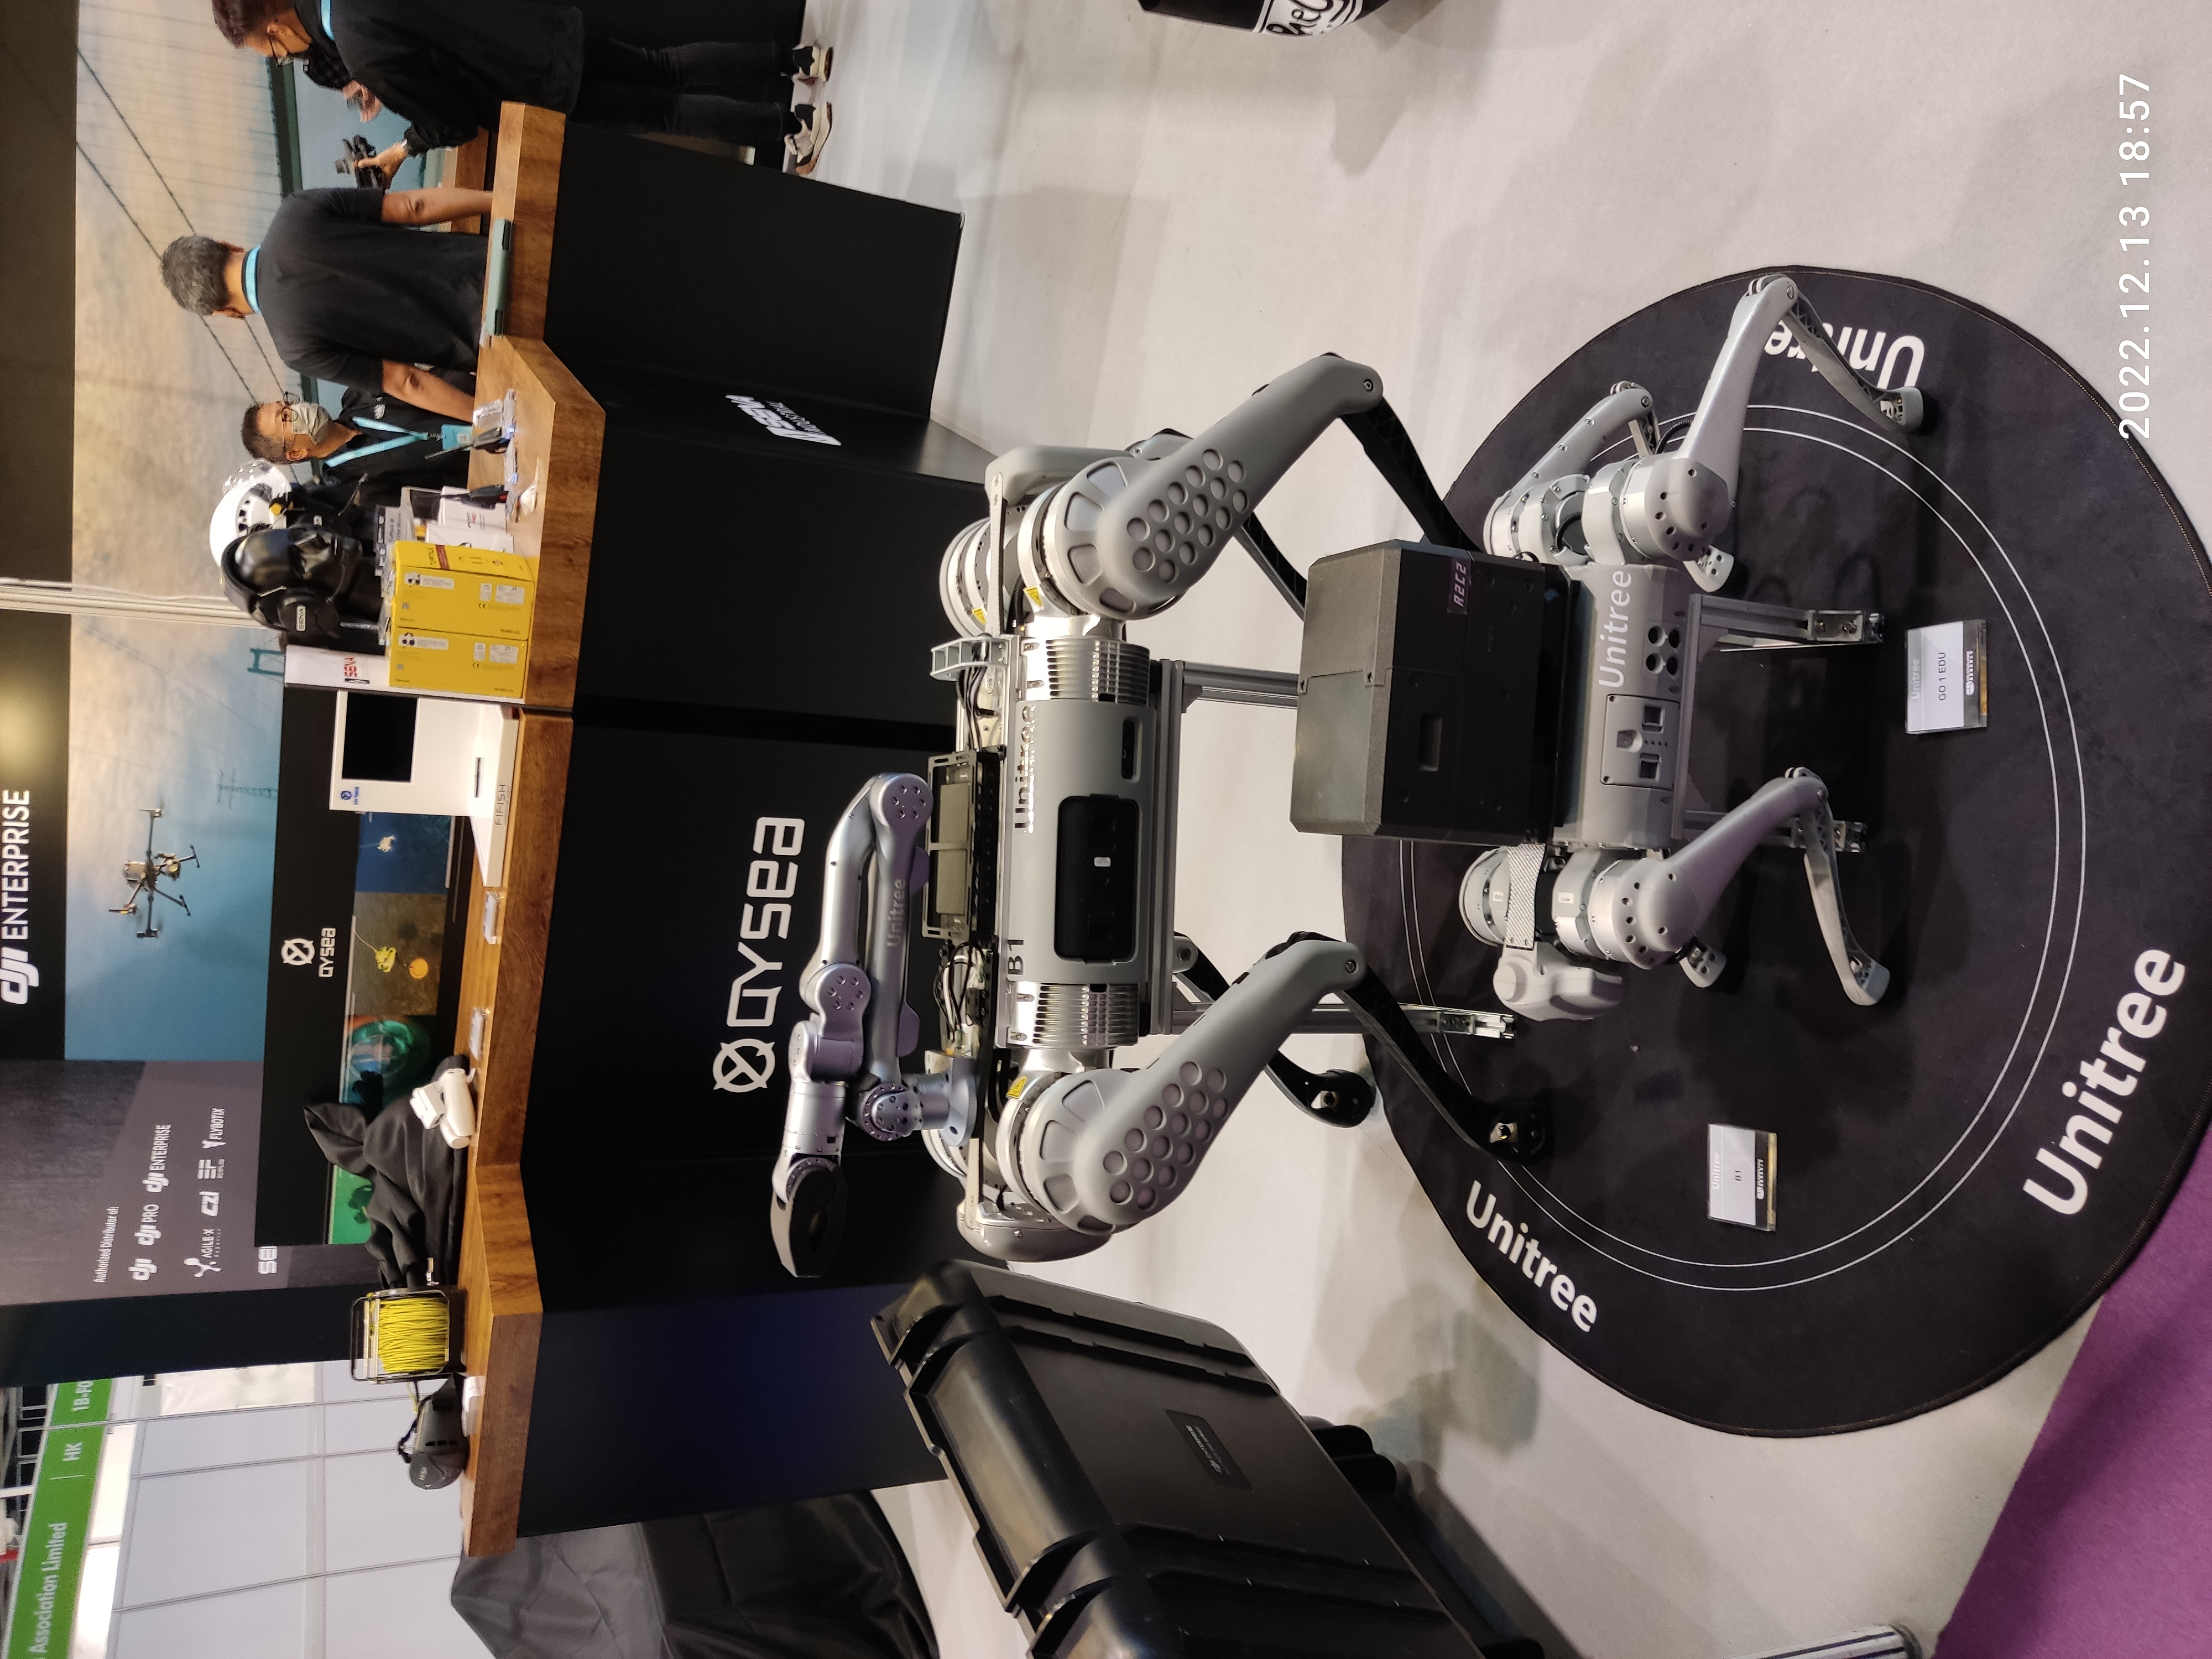
阿里巴巴達摩院發布 2B、9B 與 122B-A10B 三種 RynnBrain 1.1 模型,新增接觸點預測及原生 3D grounding。配套 RynnBrain-VLA 以統一動作空間跨 Unitree G1、Astribot-S1 與天機舞姬訓練,但跨硬體泛化仍主要由團隊自有實驗支持。
 AI 基礎設施
Anthropic 計畫自 2027 年上半年起部署首批 AMD Instinct MI450 系列 GPU,總規模最高達 2 GW。合作不只是採購硬體,雙方還將以 Claude 優化 GPU 工作負載與 ROCm 軟體堆疊。
GPT-5.6 家族進入一般供應,以 Sol、Terra、Luna 分別覆蓋最高能力、均衡成本與大量低價工作負載。三款模型共享長上下文與工具介面,但推理成本、安全行為及實際品質仍需分別評估。
 推論系統
Nemotron 3 Embed 提供 8B、1B BF16 與 1B NVFP4 等文字嵌入模型。低精度版本把檢索模型的記憶體與吞吐效率納入第一級設計目標,但品質仍需在目標語料上驗證。
 硬體
NVIDIA 開始部署為 Vera Rubin 平台設計的 Spectrum-6 交換系統,單晶片提供 102.4 Tbps 吞吐量。產品同時導入 800Gb/s 連接埠、液冷與共封裝光學選項,瞄準十萬張以上 GPU 的橫向擴充網路。
Microsoft 計畫在 Azure 規模化部署 AMD Helios,並推出搭載第六代 EPYC 的 HDv2、HXv2 與 MI455X 推論執行個體。這是 GPU、CPU、DPU、網路與軟體共同設計的基礎設施更新,實際性價比仍待公開測試。
Google 發布 LiteRT.js,讓網頁應用直接執行 `.tflite` 模型,並依裝置使用 CPU、GPU 或 NPU。它把瀏覽器端 AI 從 JavaScript 核心推向跨平台原生執行堆疊,但效能與相容性仍高度依賴瀏覽器及硬體。
LiteRT.js 透過 WebAssembly 封裝 Google 的跨平台推論執行期,並以 XNNPACK、WebGPU 與實驗性 WebNN 分別對應 CPU、GPU 與 NPU。它讓既有 `.tflite` 模型更容易移至用戶端執行,但效能與相容性仍高度取決於瀏覽器及裝置。