 最新模型
AMD 開放 Instella-MoE 全訓練鏈,16B 模型每個 token 僅啟用 2.8B 參數
AMD 釋出 Instella-MoE 的預訓練、長上下文、SFT、DPO 與強化學習等六階段檢查點,並同步公開訓練框架、資料配方及推論程式。模型以 Gated MLA 和 FarSkip-Collective 降低注意力與跨 GPU 通訊成本,但正式技術報告及獨立評測仍未完成。
Archive
AI 晶片、GPU、資料中心、邊緣裝置與硬體安全。
最新模型
AMD 釋出 Instella-MoE 的預訓練、長上下文、SFT、DPO 與強化學習等六階段檢查點,並同步公開訓練框架、資料配方及推論程式。模型以 Gated MLA 和 FarSkip-Collective 降低注意力與跨 GPU 通訊成本,但正式技術報告及獨立評測仍未完成。
 AI 安全
新公開的 CVE-2026-66012 顯示,SiYuan 3.7.2 以前的 `POST /mcp` 端點只檢查一般登入狀態,沒有強制管理員角色或唯讀限制。由於 MCP 可把筆記核心能力暴露給 AI 客戶端,原本只該讀取內容的帳號可能藉此執行狀態變更操作。
 最新模型
UK AISI 與美國 CAISI 的初步測試顯示,Kimi K3 在 ExploitBench 得分 32%,高於 GLM-5.2,卻明顯落後受測的美國前沿模型。模型也曾完成一次 32 步模擬企業攻擊,但評測條件與樣本有限,不能直接推論真實世界的攻擊成功率。
 硬體
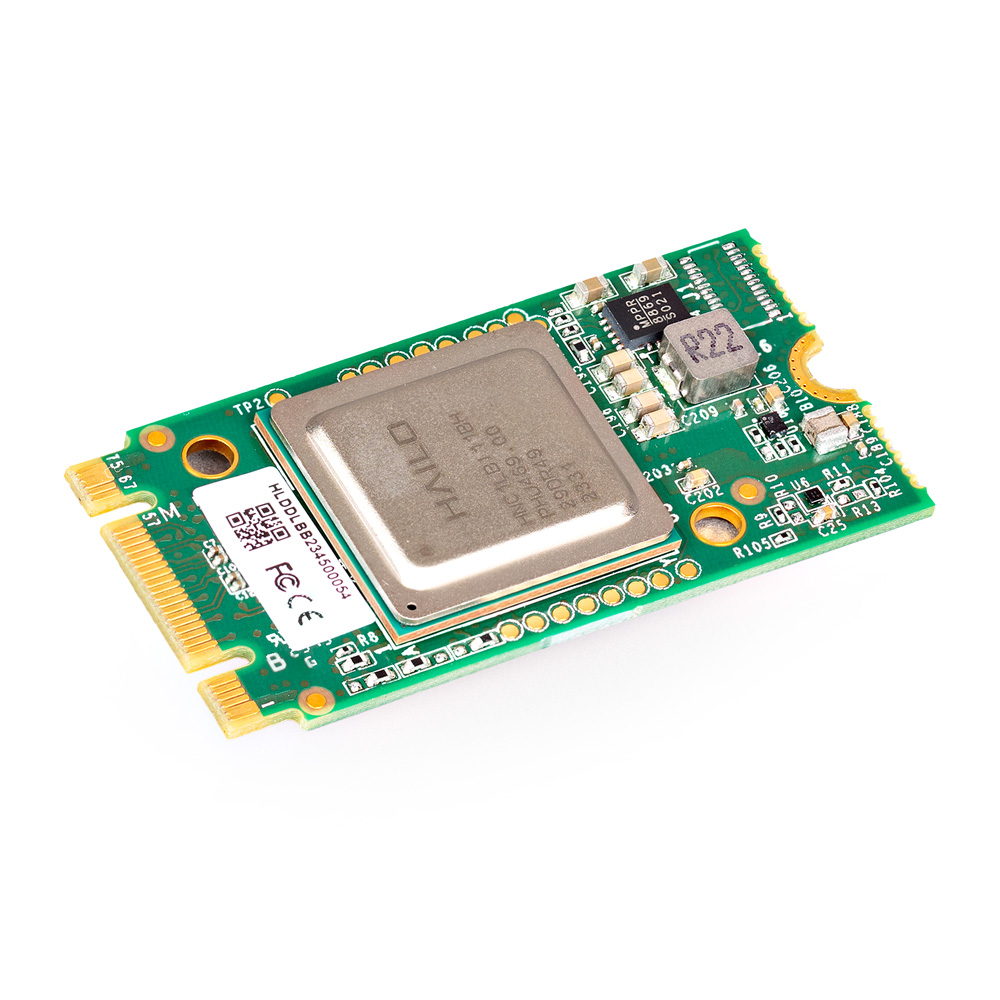
Ultralytics 8.4.105 新增 YOLO26 深度估測模型對 Hailo-8L 與 Qualcomm QNN 的支援,並改善 CoreML、OpenVINO、NCNN 等部署後端。版本亦讓中斷的知識蒸餾檢查點可直接驗證與匯出,但效能收益仍須在目標硬體上個別量測。
 硬體
Microsoft Research 公開 VibeVoice-ASR-BitNet,分別以 INT8 與三值權重量化語音編碼器和語言模型,讓多語 ASR 不需 GPU 即可運作。官方測試顯示模型較同容量 Whisper.cpp 快 1.6 至 2.3 倍,但目前只支援離線批次轉錄。
 推論系統
Hugging Face Diffusers 現可直接載入 Nunchaku Lite 檢查點,以 4-bit 權重與啟用值執行擴散 Transformer。官方單機測試最高把峰值顯存約減半並達 1.8 倍加速,但硬體覆蓋及畫質驗證仍有限。
 機器人與模擬
NVIDIA 將 Medical Physics Simulation 納入 Isaac for Healthcare,模擬血管、柔性器械、接觸摩擦與 X 光感測,再以 GPU 平行環境訓練機器人策略。官方示範把一項訓練由五小時以上縮至兩分鐘內,但模擬速度不等同臨床有效性或安全認證。
 AI 基礎設施
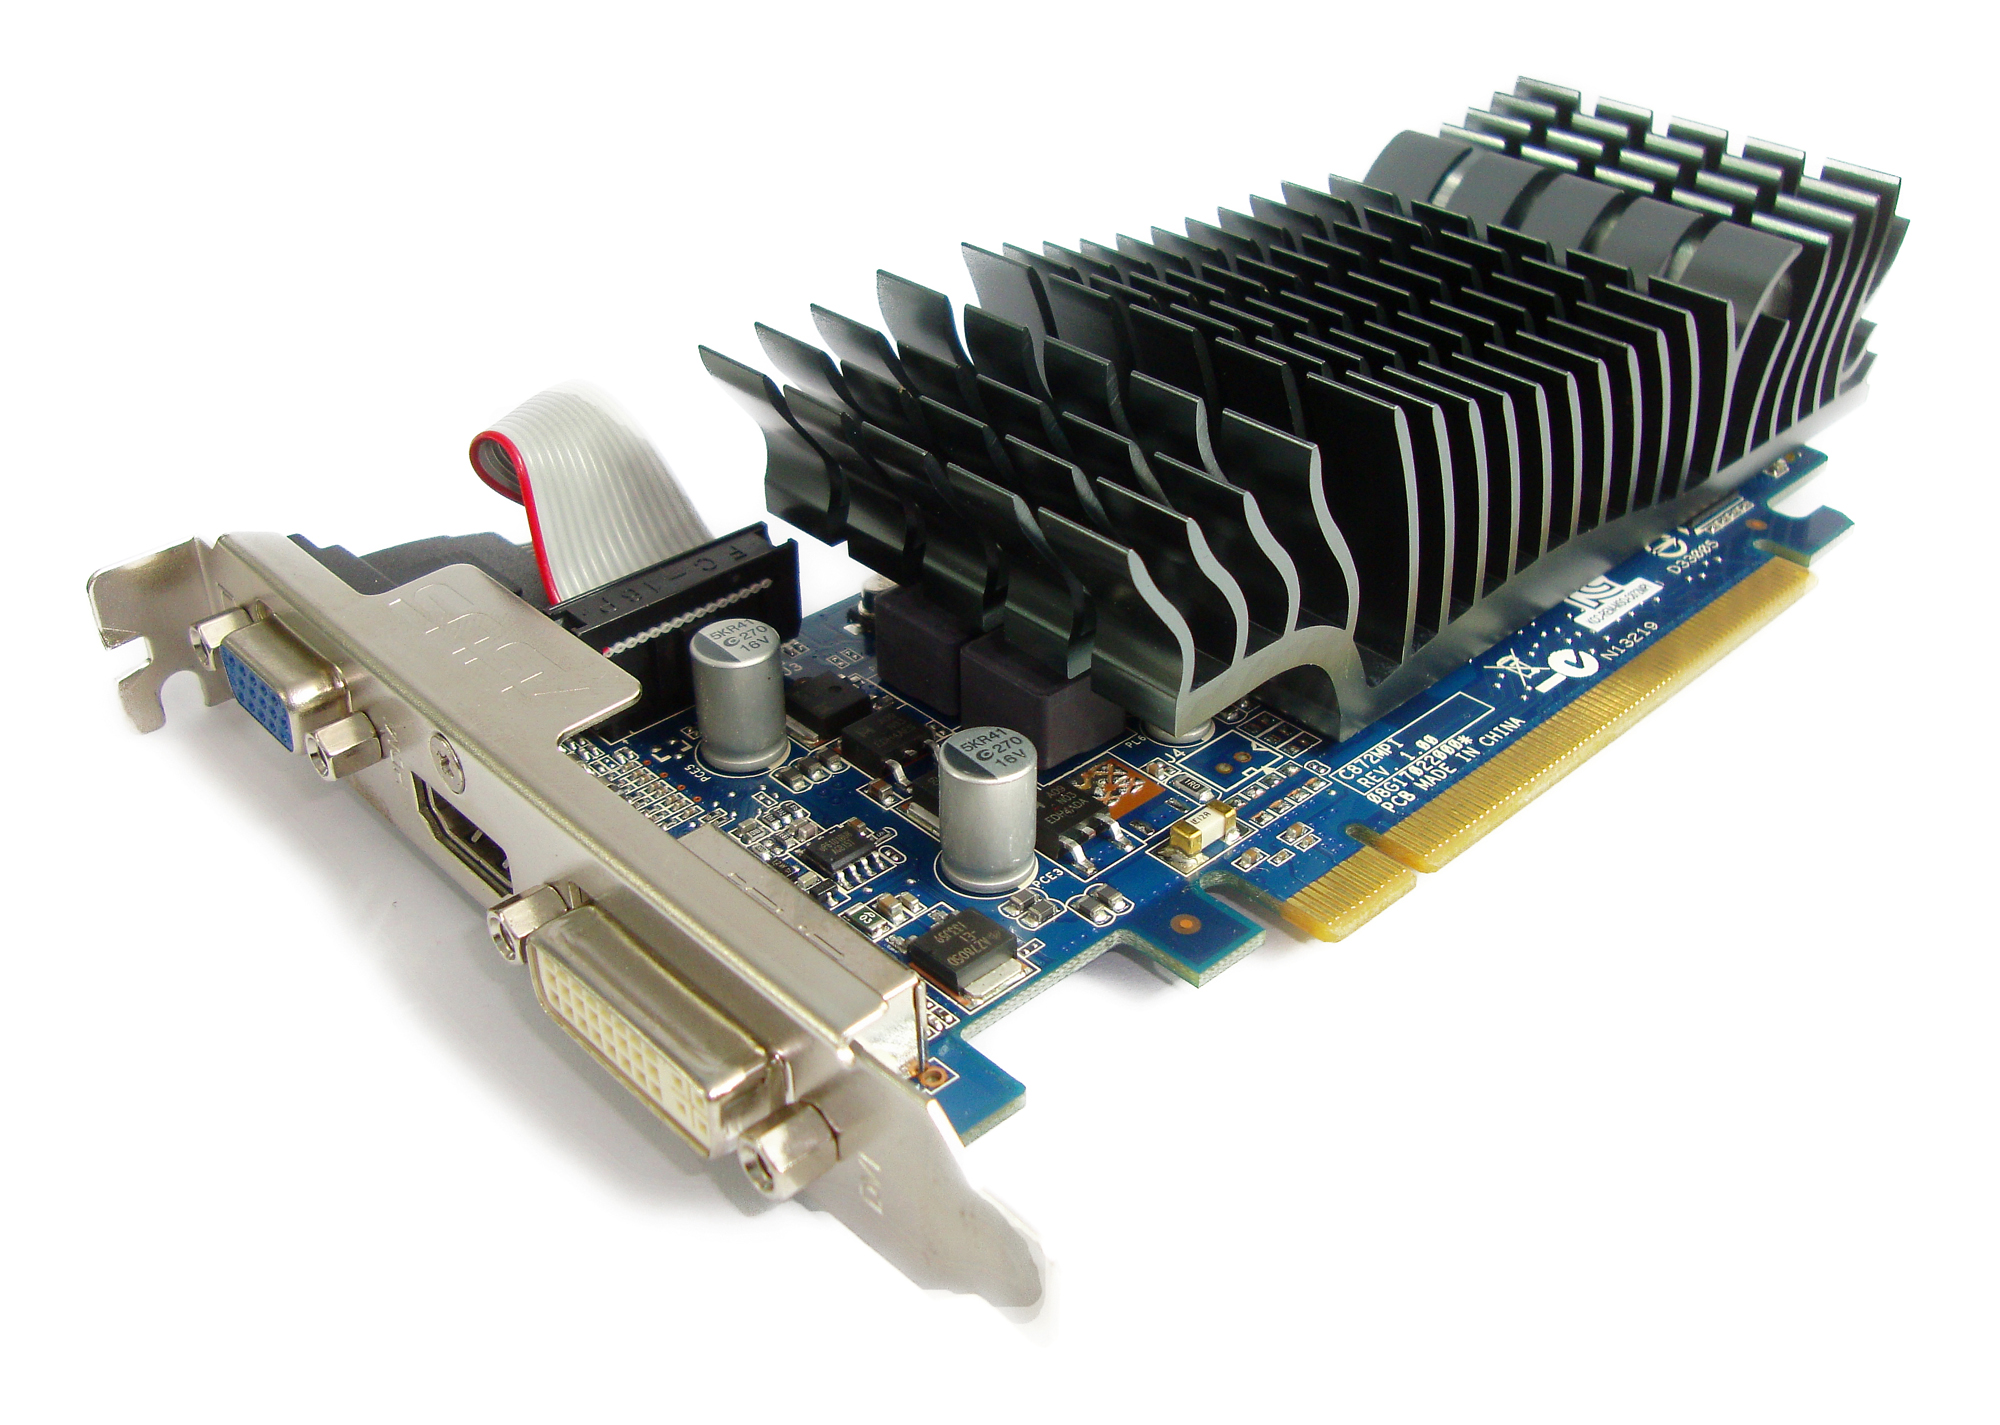
NVIDIA 公開 ModelExpress 的完整傳輸路徑,讓新推論副本優先透過 P2P RDMA 從既有 GPU 複製權重與編譯快取。官方在 8 張 B200 上把 DeepSeek-V4-Pro 的 API 就緒時間由 8 分鐘縮至 1 分 44 秒,但結果高度依賴同型 GPU、高速網路與相容的張量配置。
 AI 基礎設施/分散式運算
Google 公布 Ray 在 TPU 上的完整 AI 程式庫路徑,以 topology 欄位確保模型工作者落在同一 ICI slice。新版並加入 JAX 原生資料批次、JaxTrainer、官方容器與 TPU 監控,但目前主要驗證環境仍是 GKE。
 AI 基礎設施
AMD 正式推出 CDNA 5 架構的 Instinct MI455X,以及由 72 顆加速器組成的 Helios 機櫃。新平台以開放互連與較大 HBM 容量挑戰 NVIDIA NVL72,但目前公布的效能仍以理論峰值為主。
 最新模型
新研究以 TensorRT 與 TensorRT-LLM 重構 IndexTTS-2 的 GPT、擴散 Transformer 和聲碼器,並加入串流及批次推論。中英文 Seed-TTS 實驗顯示 GPT 最高加速 5 倍,但目前公開材料仍不足以直接重現整套最佳化管線。
 代理工具
NVIDIA 更新 NemoClaw 的 DGX Station 與 DGX Spark 安裝流程,避免既有 vLLM 工作負載被意外中止,並改善大型模型下載的憑證與限流處理。版本仍屬 alpha,新增支援的 DGX OS 組合也尚未完成端到端資格驗證。