 最新模型
openPangu 2.0 Pro 開放 505B MoE 權重,以 18B 啟用參數支援 512K 上下文
華為 openPangu 團隊釋出以昇騰 NPU 訓練的 505B 混合專家模型,每個 token 約啟用 18B 參數。模型加入分層稀疏注意力與三頭多 token 預測,但效能數字目前主要來自團隊自評。
Archive
AI 晶片、GPU、資料中心、邊緣裝置與硬體安全。
最新模型
華為 openPangu 團隊釋出以昇騰 NPU 訓練的 505B 混合專家模型,每個 token 約啟用 18B 參數。模型加入分層稀疏注意力與三頭多 token 預測,但效能數字目前主要來自團隊自評。
 科學機器學習
UNICON 將河川、交通、電網、氣象與人流等資料轉成共同的圖序列介面,透過少量數值範例在上下文中指定新任務。模型在未參與訓練的網頁流量等領域接近專用模型,但目前只驗證預測問題,權重與程式碼亦未公開。
 推論系統
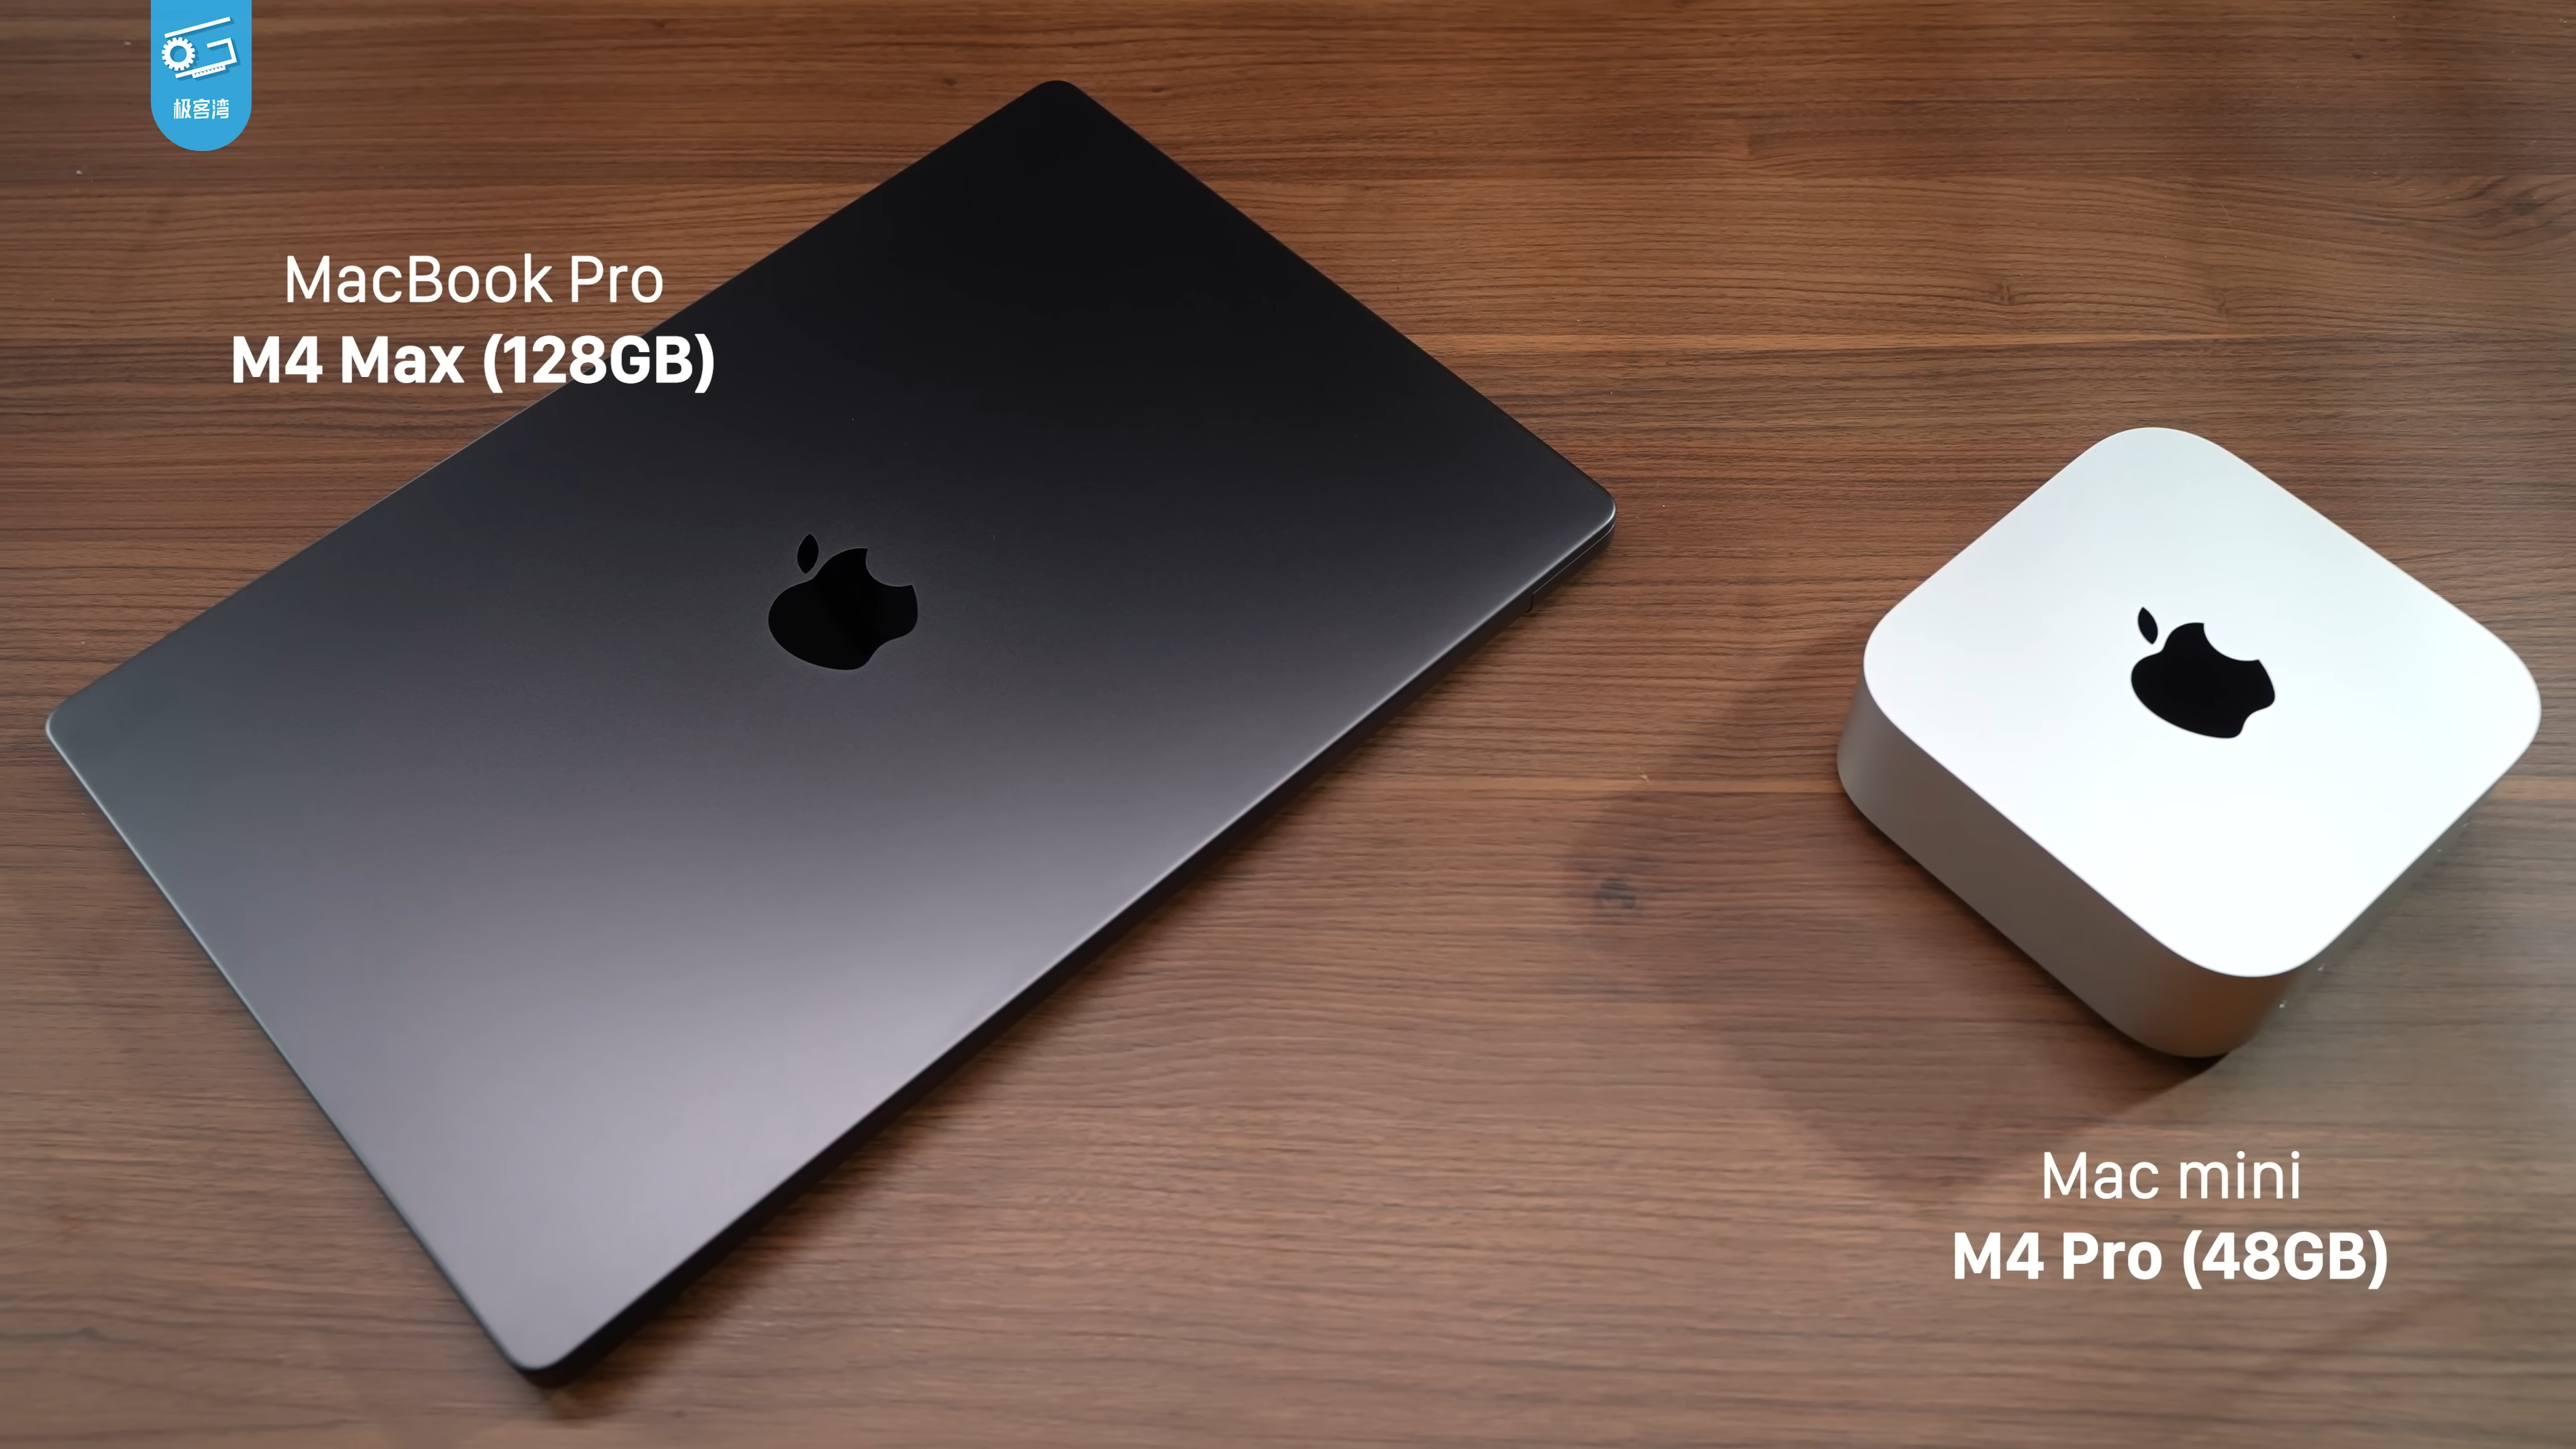
新一輪同價位本機 AI 測試顯示,M4 Max 憑 546GB/s 統一記憶體頻寬,在三款量化模型的逐 token 解碼領先 GB10 與 Strix Halo。GB10 的 prompt prefill 與整體能效仍佔優,單看 tokens/s 會錯估實際回應時間。
 代理工具
Home Assistant 新增 llama.cpp 與 LiteLLM 對話整合,可為不同模型建立各自的代理與指令。更新降低本地模型接入門檻,但目前仍是 beta,端到端工具呼叫可靠性取決於模型、schema 與硬體。
 實體 AI/科學自動化
PUDA 把自動化儀器公開為可探索的命令列工具,並以 JSON、NATS/JetStream 和穩定識別碼保存命令、量測及樣本來源。代理可以選擇下一場實驗,但實際硬體操作只能經過工程師預先撰寫及參數驗證的驅動方法。
 硬體
NVIDIA 將 Nemotron 3 Ultra 接入「生成—測試—反思」的 RTL 代理迴圈,在 CVDP 九類代理任務取得 97.1% 平均通過率。結果顯示可執行驗證能大幅強化晶片設計模型,但資料關聯、工具設定及供應商自測仍限制外推。
 最新模型
Moonshot AI 正式釋出 Kimi K3 權重與技術報告;模型具備原生視覺、百萬 token 上下文,每個 token 啟用 896 個專家中的 16 個。開放權重使官方能力宣稱終於可以重現,但逾 1TB 的低精度權重仍讓完整部署遠離一般工作站。
 最新模型
一項跨 44 款語言模型的實驗發現,僅加入「以 JSON 回答」便會降低答案多樣性,無須 schema 強制或受限解碼。結果提醒開發者,結構化輸出不只是序列化層,也可能改變模型實際選擇的答案。
 推論系統
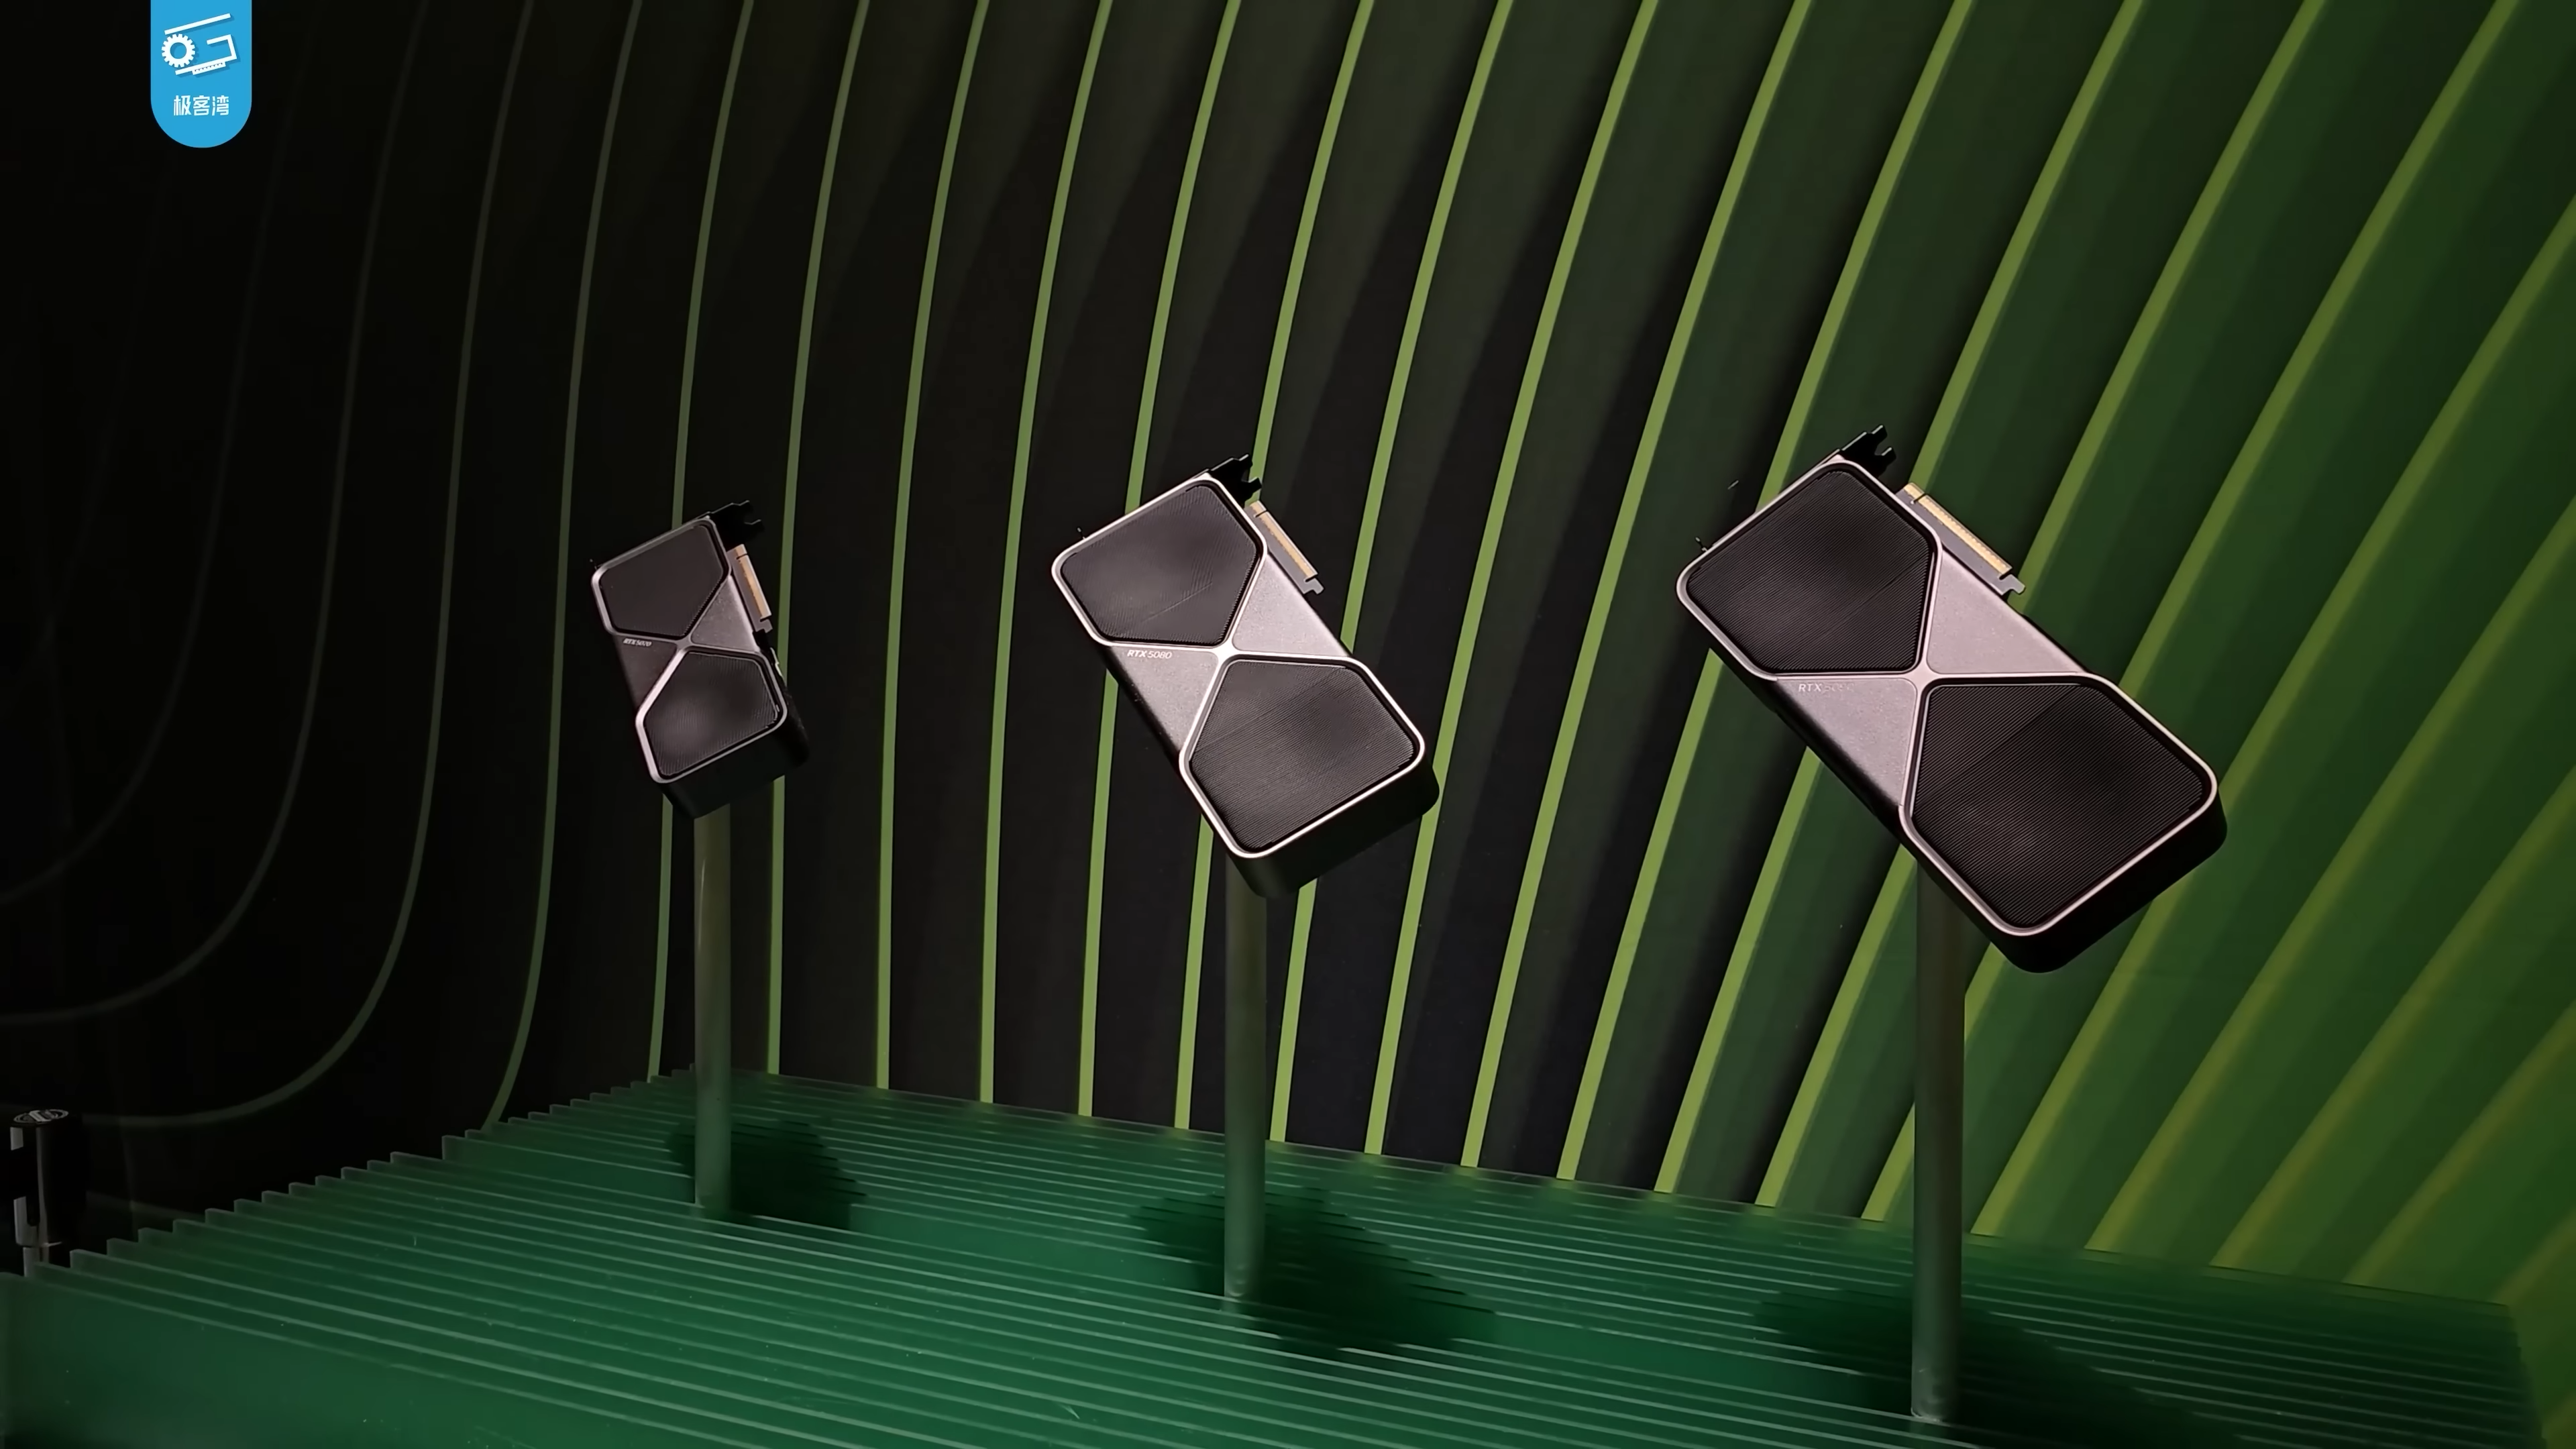
開源 NInfer 以客製量化、權重布局、融合核心與 MTP 草稿路徑,讓 Qwen3.6-35B-A3B 在單張 RTX 5090 上長程解碼維持約每秒 543 token。速度來自針對模型與 GPU 的深度特化,目前只支援兩個 checkpoint、缺乏連續批次,也尚無同條件獨立評測。
 硬體
CoTinyVLA 把 35B 教師的分層推理蒸餾進 0.9B 視覺—語言—動作模型,在 LIBERO-Plus 四組測試均領先最強 7B 基線。程式、訓練流程與權重已公開,但尚無真實機器人、不同硬體或外部團隊的重現結果。
 推論系統
NVIDIA 研究團隊公開無需重新訓練的 Sol-Attn,在注意力運算期間選取關鍵區塊,並近似補回被跳過區塊的貢獻。官方在多款影片模型測得約 1.9 至 2.34 倍端到端加速,但品質與硬體泛化仍需獨立驗證。
 推論系統
Dynamo 的實驗版本加入 Kimi K3 多模態、推理與工具呼叫解析,並公開聚合及 prefill/decode 分離的 Kubernetes 配方。配方把 2.8T MoE 的部署門檻量化到機架拓撲,但目前未經正式 QA,且已知 GB200 設定仍有啟動錯誤。