 最新模型
Meta 開放 Muse Glimmer 30B:17GB 量化版搭 DFlash 在 RTX 5090 達 233 token/s
Muse Glimmer 將多模態輸入、工具呼叫與失敗重試放進可在消費級硬體部署的 30B 密集模型。Apache 2.0 權重與官方 GGUF 已上線,但性能與安全數字目前仍主要來自 Meta 自評。
Archive
AI 晶片、GPU、資料中心、邊緣裝置與硬體安全。
最新模型
Muse Glimmer 將多模態輸入、工具呼叫與失敗重試放進可在消費級硬體部署的 30B 密集模型。Apache 2.0 權重與官方 GGUF 已上線,但性能與安全數字目前仍主要來自 Meta 自評。
 推論系統
社群部署配方在單台 DGX Spark 上啟用 CUDA Graph 與一層 MTP 推測解碼,把 Ling-3.0-flash INT4 的生成速度由 20.8 提至 38.7 token/s。更關鍵的發現是主線 vLLM 尚未支援 V3 架構,強行套用舊注意力路徑不一定報錯,卻可能輸出看似流暢的錯誤內容。
 硬體
MicroEvo 把處理器設計知識、Pareto 樹搜尋及歷次 PPA 回饋結合,用較少模擬尋找效能、功耗與面積折衷。最高 36.2% hypervolume 增益來自模擬設計空間,尚不能等同實體晶片改善。
 推論系統
PaDoc 讓版面序列與各區域內容共用頁面前綴並行解碼,避免把整頁文件串成單一路徑。2.1B 模型在 OmniDocBench 維持 94.24 整體分數,但效能數字來自單一 GPU 與特定排程設定。
 硬體
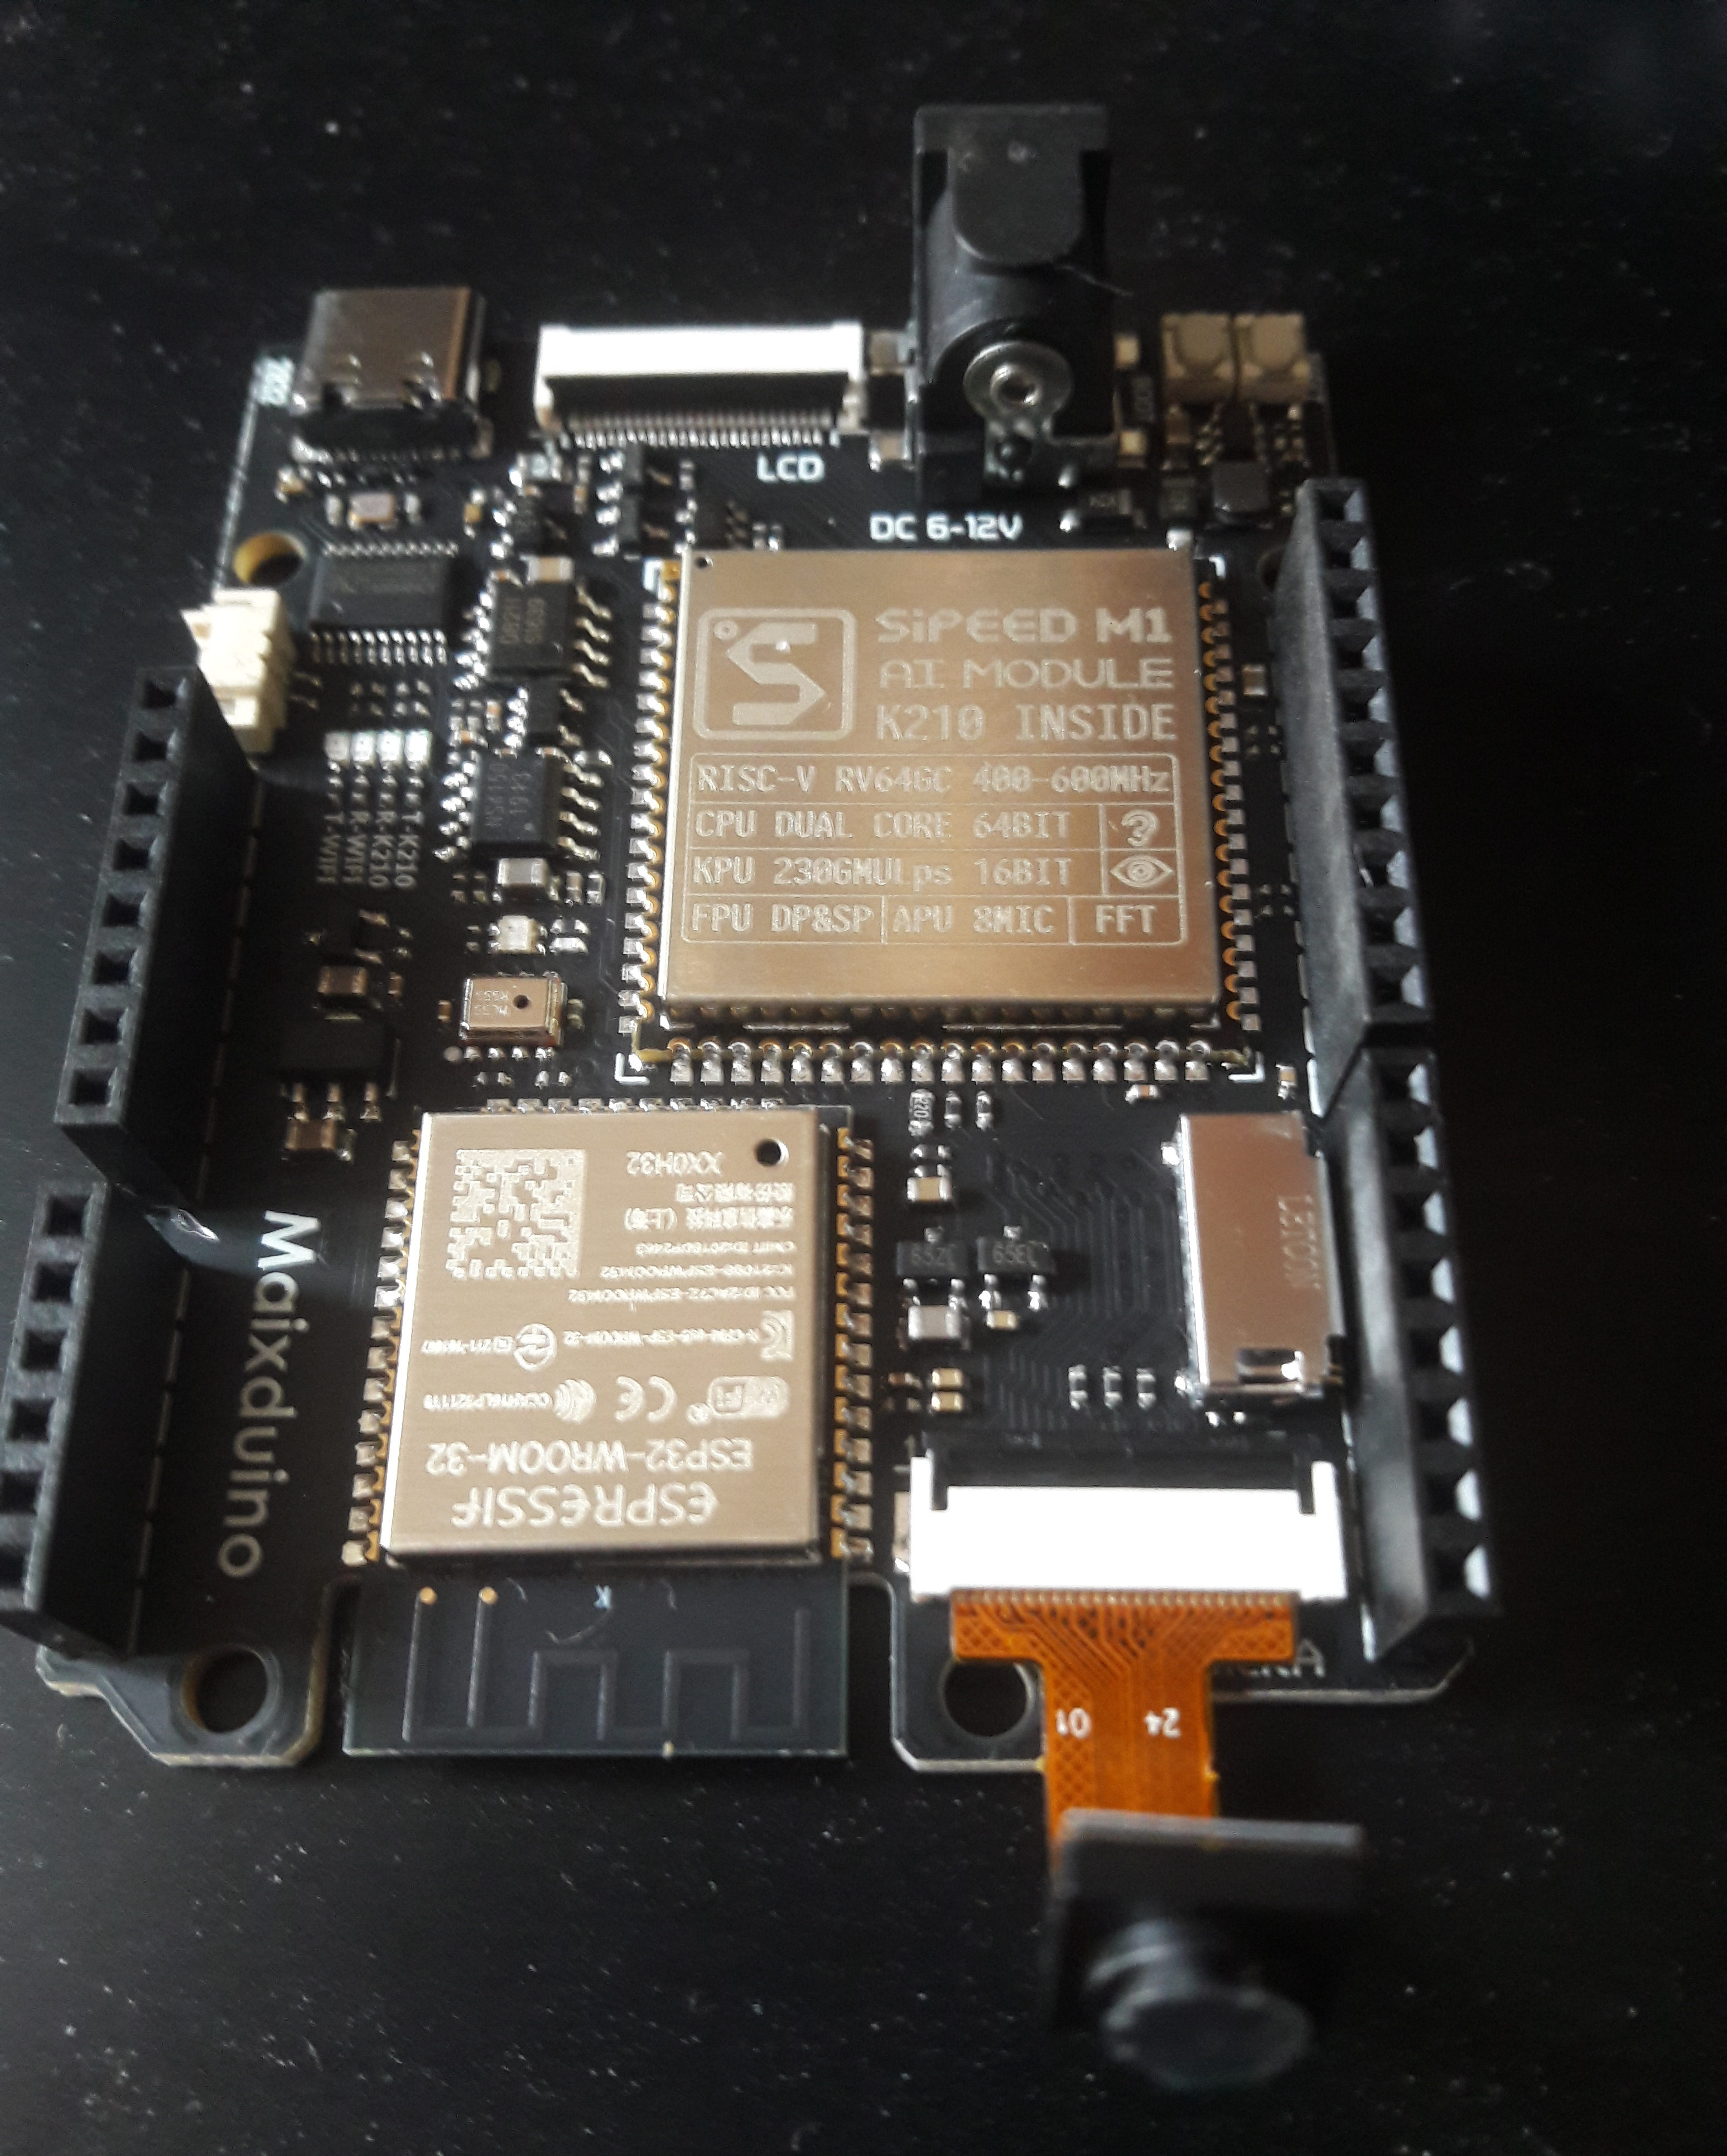
開源專案 esp32-ai 以 4-bit 量化及分層記憶體配置,把約 2,500 萬個嵌入參數留在快閃記憶體,只按 token 讀取所需列。模型能在低於 10 美元的微控制器上離線生成文字,但能力仍限於簡短故事與單一領域問答。
 推論系統
PhyAI 以模型轉接器保留各架構的條件、求解器與動作語意,再共用圖執行、核心、快取及多 GPU 服務。公開測試涵蓋 π0、π0.5、GR00T N1.7、Cosmos3 與 MiniCPM-Robot,但部分比較未使用完全相同的數值精度。
 AI 基礎設施
Microsoft Azure 研究顯示,代理在模型推論、工具與協調器之間反覆切換,使 CPU 重新進入關鍵路徑,GPU 卻經常閒置。原型系統 Agora 可依工作流型態回收算力,但錯誤壓縮平行代理的 GPU 配置反而會讓尾延遲惡化 16 倍。
 最新模型
新研究以語音轉錄與 QWERTY 鍵盤擾動測試指令模型,發現語音造成的結構改寫會一致降低作答表現。提高推理預算幾乎可修復鍵盤通道,卻無法同樣挽救口語輸入。
新基準以可視辨識的真實實體測試視覺語言模型,發現只用文字做知識遺忘,效果不易轉移至圖片與跨模態問答。多模態遺忘可回頭通過文字測試,顯示單一文字評測可能高估刪除成效。
 最新模型
新研究先快取教師模型的少量 logits,再以分塊融合 KL kernel 避免建立完整詞彙張量。單張 GPU 可把蒸餾上下文由 8K 擴至 32K,但速度與品質結論仍來自有限模型及硬體設定。
 推論系統
新方法把同一家族小模型產生的 KV cache 映射至較大模型,避免長對話切換模型時重新處理整段提示。六組模型中僅四組保留 73% 至 98% 的原始準確率,顯示張量相容不等於語意相容。
 代理工具
新評測先封存模型構想,再以賽季技術與職業賽牌組作為延遲出現的答案,降低回溯基準的資料污染疑慮。結果顯示模型不缺看似合理的點子,瓶頸反而是篩選、組合及辨識真正有用的新意。